📌 エグゼクティブサマリー
llama.cpp MoEの話題が、モデル構築から推論オフロードへ進んだことを追跡します。LLaMA-MoEは活性パラメータ3.0〜3.5B、zilongはllama-server互換で動的オフロードを狙います。実測TPSは素材になく、設定設計が中心です。
静かな投稿から、動きが見えます。Hacker Newsでは1ポイント、コメント0件でした。[1] それでもllama.cppのMoE対応は、AI推論の話題に残っています。MoEは、全部の部品を動かさず、必要な専門家だけを使う仕組みです。[5] オフロードは、重い部品を別の場所に置くことです。[3] 前回は構築とオフロードの分岐を追いました。今回は、その後の運用設計に目を向けます。派手な発表ではありません。[1] でも、実装の断片は集まっています。[1]
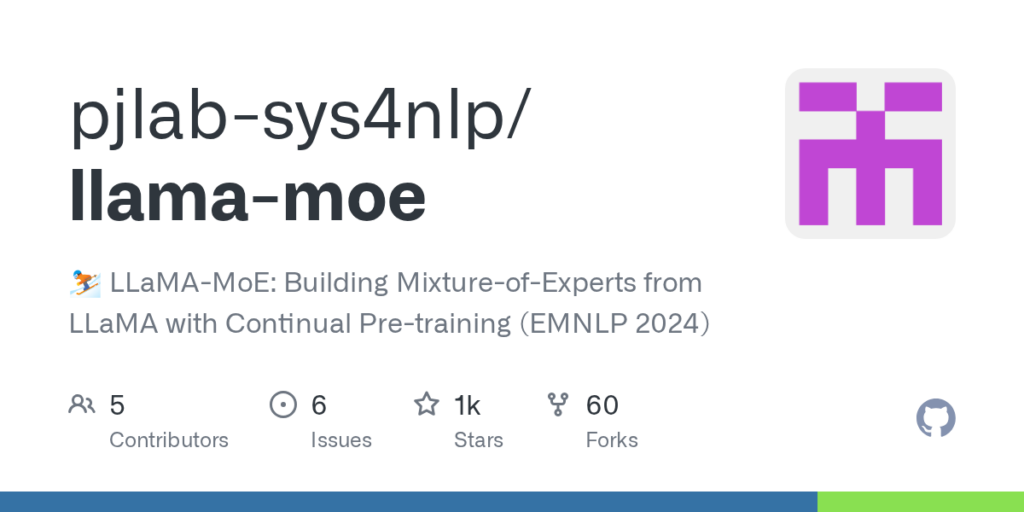
まず、モデル側の数字を確認します。LLaMA-MoEは、LLaMAのFFNを疎な専門家に分けます。[2] そして各層にtop-Kゲートを挿入します。[2] 活性パラメータは3.0〜3.5Bです。[2] 小さいモデルとして、研究とデプロイを狙っています。[2] FlashAttention-v2も統合されています。[2] 学習の速さを意識した構成です。モデルを小さく保つ狙いです。[2] 3.0〜3.5Bという数字は、展開のしやすさを示します。[2]
構築の試みは、単なる変換ではありません。[2] 専門家分け方はランダム、クラスタリング、共活性グラフ、勾配など複数です。[2] ゲートもTopK Noisy GateとSwitch Gatingを扱います。[2] 監視項目にはgate loadやbalance loss、TGS、MFUがあります。[2] 学習の質を数字で見る姿勢です。[2] データ側も工夫されています。[2] SlimPajamaから選別したデータを使います。[2] Sheared LLaMAの動的バッチ読み込みも採用しています。[2] 単発の改造ではなく、継続学習を前提にしています。[2]
READMEにはpython>=3.10の例があります。[2] モデル名はLLaMA-MoE-v1-3_5B-2_8です。[2] バージョン名も重要です。[2] 生成はmax_length=50、temperature=0.0です。[2] 短い出力で確認する例です。[2] ここでは、モデルが動くこと自体を確かめています。[2] 性能の比較にはなっていません。[2] それでも、小さなMoEを扱う入口として重要です。[2] 研究と実装の距離を縮める例です。[2] 温度0.0は、ばらつきを抑える設定です。[2] 出力の揺れを減らすためです。[2]
次に、推論側の動きです。llama.moeは、llama.cppの上に立つ軽量な枠組みです。[3] 動的な専門家オフロードを売りにしています。[3] CUDAが必要で、ビルドにはcmakeやninja-buildも使います。[3] scripts/build_llama_cpp.shとuv syncが手順です。[3] 使い方はllama-serverと同じです。[3] llama-serverをzilongに置き換えるだけです。[3] ここが今回の新しい角度です。[3] 既存の運用を壊さず、MoEを試す道です。[3] zilongは、llama.cppをビルドしてから使います。[3] 依存関係は重めです。[3] それでも、既存のサーバー運用に寄せられます。[3]
ローカル実行の狙いもはっきりしています。[4] CPU推論にGPU加速を組み合わせる、という道です。[4] llama.cppでは–n-cpu-moeが鍵になります。[5] 専門家のどれをCPUに置き、どれをGPUに置くかを決めます。[5] さらにストリーミングの説明も出ています。[5] 重みをどう扱うか、という話です。[5] 大きなMoEを、メモリに全部載せないで動かす工夫です。[5] DeepWikiでは、llama.cpp内のMoE設計も整理されています。[5] どの層で専門家を使うか、という話が見えます。[5] GPUだけを見るのではなく、CPUとGPUの役割分担を見ます。[4][5] 環境ごとの分担も、運用の一部です。[4][5]
ただし、数字の比較はまだ薄いです。[4] TPSは、1秒あたりの生成数です。[4] 実測TPSや消費電力は、素材には見つかりませんでした。[4][5][5] HNの反応も1ポイント、0コメントです。[1] つまり、派手な結論は出ていません。[1] 一方で、構築と推論の道具は増えています。[2][3][5] ここに温度差があります。[1][2][3] 大きなMoEを跨ぐガイドもありますが、環境ごとの差は示されていません。[5] 素材には具体的な比較数値が見つかりませんでした。[5] ガイドは手順を並べますが、同じ環境の数字を揃えていません。[5] だから、比較の土台が弱いままです。[5]
意外なことに、主役はモデルより設定です。[3][5] AIの運用では、メインの設定が速さと載せ方を決めます。[3][5] セッティング次第で、扱えるMoEの大きさが変わります。[3][5] LLaMA-MoEの例では、3.0〜3.5Bの活性パラメータが目安です。[2] でもllama.moeやzilongは、モデルの大きさを直接示していません。[3] 素材には具体的な比較数値が見つかりませんでした。[3] だから、速さの断定はできません。[3] 必要なのは、環境と旗の組み合わせです。[5] 旗は設定項目です。[5] 旗の指定は、載せられるモデルに関わります。[5] 速さの前に、動く構成を作ります。[5]
今後の見通しは、地味な運用にありそうです。[4][5][5] MoEの対応は、モデルを作る話から、動かす話へ進みました。[2][3][5] llama.cppのMoEは、CPUとGPUの分担をどう設計するかが中心です。[4][5] Hacker Newsの静けさは、まだ途中であることを示しています。[1] ローカルでMoEを試す人は、構成と設定を丁寧に追うのが良さそうです。[3][4][5] AI推論の入口は、派手な数字より、再現できる手順にあります。[2][3][5] 次の一手は、TPSや電力の公開かもしれません。[4][5][5] 数字が揃えば、MoEのローカル実行は一段進みます。[4][5]
引用ソース
- [1] Hacker News Hacker News: If llama.cpp enables MoE to activate multiple experts — https://www.openai-hub.com/news/1924/
If llama.cpp enables MoE to activate multiple experts
- [2] Web記事 記事全文: GitHub – pjlab-sys4nlp/llama-moe: ⛷️ LLaMA-MoE: Building Mixture-of … — https://github.com/pjlab-sys4nlp/llama-moe
📢 A SMALLER AFFORDABLE MoE MODEL FOR EVERYONE!!
LLaMA-MoE is a series of open-sourced Mixture-of-Expert (MoE) models based on LLaMA and SlimPajama. We build LLaMA-MoE with the following two steps:
– Partition LLaMA’s FFN - [3] Web記事 記事全文: GitHub – jklincn/llama.moe: Optimized inference of MoE models based on … — https://github.com/jklincn/llama.moe
A lightweight inference framework for Mixture-of-Experts (MoE) models, built on top of llama.cpp with dynamic expert offloading.
sudo apt update
sudo apt install build-essential cmake ccache libcurl4-openssl-dev ninja-bu - [4] Web記事 Web検索: Performant local mixture-of-experts CPU inference with GPU acceleration … — https://huggingface.co/blog/Doctor-Shotgun/llamacpp-moe-offload-guide
Performant local mixture-of-experts CPU inference with GPU acceleration …
- [5] Web記事 Web検索: llama.cpp's MoE Expert Offload: –n-cpu-moe and Streaming, Explained — https://www.shawnmayzes.com/ai-engineering/llama-cpp-moe-expert-offload-explained/
llama.cpp's MoE Expert Offload: –n-cpu-moe and Streaming, Explained
- [6] Web記事 Web検索: Mixture-of-Experts (MoE) Architectures | alesha-pro/llama.cpp | DeepWiki — https://deepwiki.com/alesha-pro/llama.cpp/5.2-mixture-of-experts-(moe)-architectures
Mixture-of-Experts (MoE) Architectures | alesha-pro/llama.cpp | DeepWiki
- [7] Web記事 Web検索: Guide to optimizing inference performance of large MoE models across … — https://gist.github.com/DocShotgun/a02a4c0c0a57e43ff4f038b46ca66ae0
Guide to optimizing inference performance of large MoE models across …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS