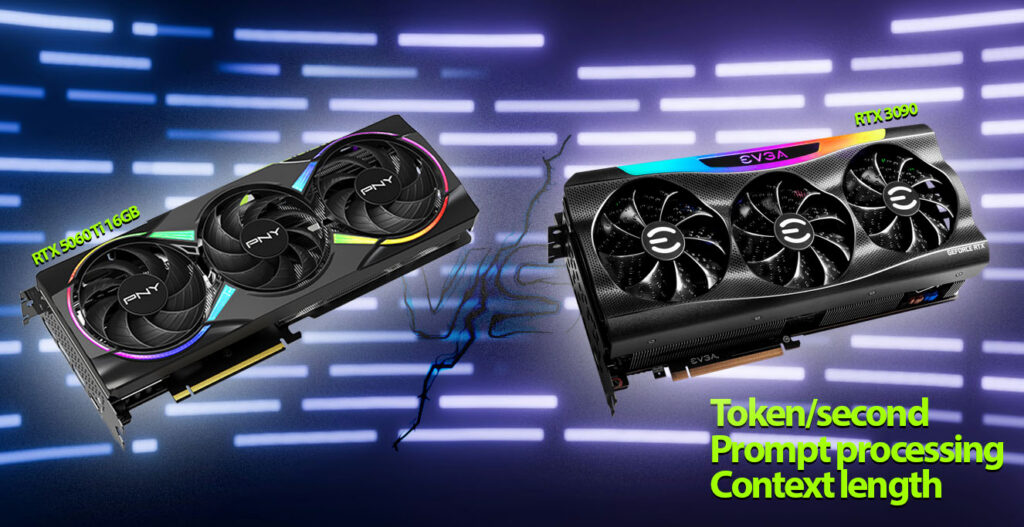
「新しいモデルを18個試したのに、どれも置き換えられなかった」——こんな率直なテスト結果が、エンジニアコミュニティのHacker Newsに投稿され、コメントで議論が始まっています[1]。ローカルLLM(自分のPCで動かすAIモデル)の愛好者が、RTX 5060 Tiを2枚搭載した環境で一晩かけて新しめのモデルを次々と試しました。すると、既存のQwen3.8-27Bが依然として現役だったという報告です。
なぜ5060 Tiを2枚なのでしょう。背景には、VRAM(モデルを載せておくGPUのメモリ)を安く確保する工夫があります。16GB版のRTX 5060 Tiは1枚549ドルと手頃です[4]。GDDR7メモリを備え、帯域は448GB/s、消費電力の目安は180W、接続はPCIe 5.0 x8です[2]。2枚で32GBのVRAMを確保でき、合計は860ドル前後。比較相手の中古RTX 3090は24GBで約800ドルなので、価格差はごくわずかです[2]。900ドル未満の予算で本格的なVRAM量を確保できる構成として注目されてきました[2]。
ベンチマークの結果、構成ごとの得意分野がはっきり分かれました。MoE(専門家役の小さなネットワークを切り替えて計算を減らす構造)を持つモデル、たとえばQwen3 30Bは、2枚の5060 Tiが有利です[2]。長いコンテキスト(会話の記憶範囲)とVRAM重視の場面でも、2枚構成が推されています[2]。一方、全パラメータを毎回使う従来型のQwen3 32Bでは、メモリ帯域が2倍以上あるRTX 3090のほうが速いという結果でした[2]。バージョンの新しさだけでは、帯域の差は覆せないようです。
1枚あたりの推論実力も数字で確認できます。RTX 5060 Ti 16GB単体では、Qwen3 14Bを16kコンテキストで動かした生成速度が平均32.9トークン/秒でした[4]。プロンプト処理(入力文を読み込む速度)は942.6トークン/秒です[4]。4ビット量子化(重みを圧縮してメモリを節約する仕組み)で丸ごと載せられるのは、20Bクラスまでです[4]。gpt-oss 20Bなら128kコンテキストまで動きました。ただし30Bモデルは、1枚では届きません[4]。それでも549ドルという価格から、入門向けの「コスパ王者」と紹介されています[4]。
ところが、この「Qwen3.8-27Bは無敵」という報告に、コメント欄から異論が上がりました[3]。コメント主は同じ2枚の5060 Ti環境で、Qwen 3.8 Flash NextとStrataを試しています。27Bより速く、ベンチマークでも上。速度は約60トークン/秒という主張です[3]。さらに「27Bの運用はすでにやめた」と述べています。モデルを2枚のGPUに分割して載せる設定で、200Kという長いコンテキストを扱い、量子化はQ5/Q4_1を使ったと報告されています[3]。この構成でのプロンプト処理は1900トークン/秒に達しました。生成速度は元記事の結果と同じだったといいます[3]。モデルの選び方次第で、「置き換え」はあり得たかもしれません。
もうひとつ意外なのは、前世代のRTX 3090が依然として強いという点です。5060 Ti 2枚はVRAM容量とMoEモデルで勝り、3090は従来型モデルの速度で勝ります[2]。勝敗を分けるのは世代の新しさではなく、帯域と容量のどちらを取るかという選択のようです。1000ドル未満の予算での勝者は、用途次第とまとめられています[2]。1枚で済ませるなら20Bまで、2枚に増やせば32GB。この自由度が、選び方を難しくも面白くしています。
こうした比較を支える情報も増えています。5060 Ti向けのローカルLLM実践レシピをまとめたGitHubリポジトリ[5]や、DeepSeek、Llama、Qwenなどを並べた2026年版の比較表[6][5]、3090と5060 Tiを軸にしたマルチGPU構成のガイド[6]が公開されています。用途に合わせたセットアップがしやすくなったのは、ありがたいところです。18個試しても消えなかった現役モデルの存在は、ローカルLLM選びが単なる新しさ競争ではなく、自分の環境と用途に合う最適解を探す作業だということを示しています。次の「置き換え」が見つかるかどうかは、試す側の構成と選択にかかっているように思えます。
引用ソース
- Hacker News Hacker News: Tested 18 new Local LLMs on two RTX 5060 Ti cards: none replaced Qwen3.8-27B — https://siimtolk.github.io/articles/llm-testing-overnight/
Tested 18 new Local LLMs on two RTX 5060 Ti cards: none replaced Qwen3.8-27B
- Web記事 記事全文: I Tested Dual RTX 5060 Ti 16GB vs RTX 3090 for Local LLMs – Here's What … — https://www.hardware-corner.net/guides/dual-rtx-5060-ti-16gb-vs-rtx-3090-llm/
I Tested Dual RTX 5060 Ti 16GB vs RTX 3090 for Local LLMs – Here’s What Surprised Me
The landscape of local Large Language Model (LLM) inference is constantly evolving, and for us enthusiasts who build and tweak our own - HNコメント HNコメント: sted 18 new Local LLMs on two RTX 5060 Ti cards: none replaced Qwen3.8 — https://news.ycombinator.com/item?id=50194948
Maybe they should have tried Qwen 3.8 Flash Next and Strata. Faster than 27B, around 60tps, and more intelligent on benchmarks. I'm using this on my own 2x 5060TI. I abandoned 27B on llama – split mode tensor, 200K
- Web記事 記事全文: RTX 5060 TI 16GB Local LLM Benchmarks, Context Scaling & Supported … — https://www.hardware-corner.net/gpu-llm-benchmarks/rtx-5060-ti-16gb/
Local LLM Performance: 32.9 t/s average on 14B models at 16k context. Updated Benchmarks: March 2026.
32.9T/s
943T/s
In our 2026 testing, we identify the RTX 5060 Ti 16GB as the definitive “value king” for entry-level lo - Web記事 Web検索: GitHub – 5p00kyy/club-5060ti: Practical local LLM recipes and … — https://github.com/5p00kyy/club-5060ti
GitHub – 5p00kyy/club-5060ti: Practical local LLM recipes and …
- Web記事 Web検索: DeepSeek V3.2 vs Llama 4 vs Qwen 3 (2026): – spheron.network — https://www.spheron.network/blog/deepseek-vs-llama-4-vs-qwen3/
DeepSeek V3.2 vs Llama 4 vs Qwen 3 (2026): – spheron.network
- Web記事 Web検索: Open Source LLM Comparison Table (2026) – ComputingForGeeks — https://computingforgeeks.com/open-source-llm-comparison/
Open Source LLM Comparison Table (2026) – ComputingForGeeks
- Web記事 Web検索: Best Dual-GPU Local AI Setup: RTX 3090, 5060 Ti (2026) — https://insiderllm.com/guides/multi-gpu-local-ai/
Best Dual-GPU Local AI Setup: RTX 3090, 5060 Ti (2026)
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。

RECENT COMMENTS