「自転車に乗るペリカンを、高精細に描いて」。このひとつの命令が、ClaudeとKimi K3の実力を比べる定番の題材になっています。以前この連載では、Claude内のモデル選び(Opus 5.5が標準、Fable 5.1は難問向け)を取り上げました。今回はその後の展開として、外から迫る挑戦者Kimi K3との比較を整理します。
きっかけのひとつは、Reddit r/LocalLLaMAへの投稿です。投稿者はMoonshotのKimi K3.1 Proに、デフォルトのthinking(max)設定でペリカン課題を試しました。コンテキスト(一度に扱える文章量)の使用は約16万トークンです。実行にはPi.devというハーネス(評価用の実行環境)を使っています[1]。できあがった結果は「Opus 5よりは上」ながら、公開時のOpus 5.5やastra 6とは依然差があるという評価でした。投稿者は「さらに思考を増やせば改善した可能性がある」とも書いています。コメント欄には改良版が次々と追加されました。オープンウェイト(誰でもダウンロードして動かせる)モデルの3D理解が大きく進んだ、というのが投稿者の見立てです[1]。なお、比較先のOpus 5.5の結果はClaude Codeで作られたもので、実行環境は異なります[1]。
ベンチマーク全体の成績は、もっと接戦です。14項目を並べた比較記事によると、Claude Fable 5が8勝、Kimi K3が6勝。Fable 5は難易度の高いエンジニアリング、専門知識を要する業務、視覚推論でリードしています。一方のK3は、長時間続くエージェント型コーディング、ターミナル操作、Web調査で勝ちました[2]。エージェントとは、指示をもとにAIが自律的に作業を進める形式のことです。公開から48時間で解説動画は二分され、「K3がFableを圧倒した」と「本当に勝ったのか」が並びました。同記事は「どちらの主張も特定のベンチマークについては正しく、全体としては誤り」と整理しています[2]。
コストの差も、具体的な数字で動いています。K3のトークン単価はFableの約3分の1です[2]。これに対しAnthropicは、Fable 5.1(2026年9月1日公開)で基本価格を入出力100万トークンあたり10ドル/50ドルのまま維持しました。その一方で、キャッシュヒット時の価格を100万トークンあたり1.00ドルから0.25ドルへ、75%引き下げています[2]。キャッシュは、同じプロンプトの一部を再利用して課金を減らす仕組みです。繰り返しの多いエージェント業務では、ここでコスト優位を盛り返した形になります。なお、K3対Fable 5.1の新しいスコアカードはまだ出ておらず、14項目の表はFable 5公開時の数値のままです[2]。
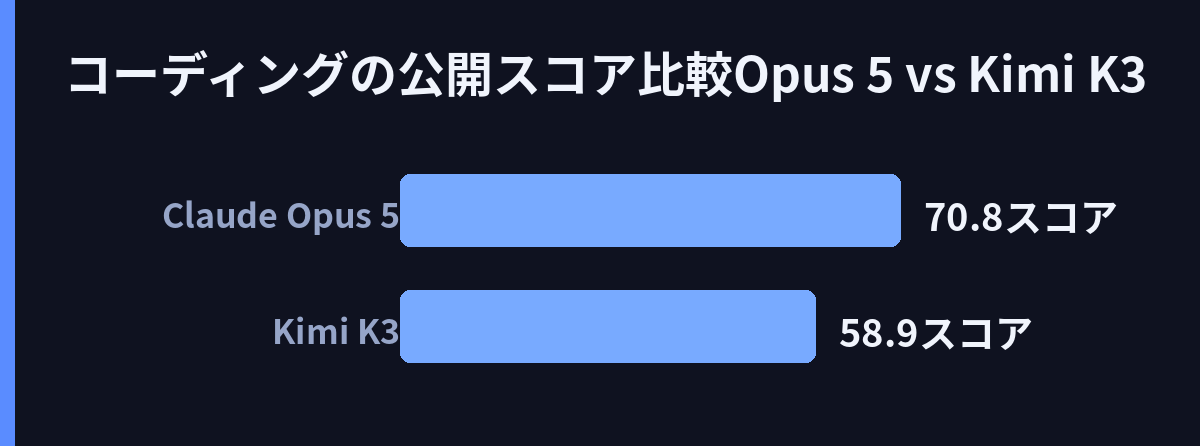
しかし、コーディングの指標では差がはっきり残ります。BenchLM.aiの比較では、Claude Opus 5の公開コーディング推定値は70.8。Kimi K3は58.9で、約12ポイントの開きです[4]。同サイトは、条件付きの数値幅からは順位を確定できない旨も添えています[4]。ペリカン課題でも、Opus 5.5との差は「まだ大きめ」とされました[1]。難問とコーディングの頂点は、まだClaude側にあるようです。
この比較の熱気自体が、いまの流行を映しています。7月時点のOpus 5対K3の検証記事[5]や、2026年の決着を扱う総括[7]など、同種の比較が複数公開されました。いずれも「Kimi K3対Claude」という同じ枠組みで、関心の高さがうかがえます。Opus 4.6以降の「エージェントシフト」を追う解説[6]や、Claudeエージェントの構築・運用ガイド[8]も出ています。日本のXでは「パーソナルAIエージェント」がトレンド語に入りました[3]。モデル比較の関心は、AIエージェントを自分の作業に取り込む流れとつながっていると思われます。
まとめると、勝敗はタスク次第で入れ替わります。長時間のエージェント作業とコストならK3、難問・専門業務・視覚推論ならFableという分担です。オープンウェイト側の進歩は速く、ペリカン課題でも差は縮まりつつあります。それでも最上位モデルとの壁は残り、Claudeはキャッシュ値下げで応戦しました。用途とコストで使い分ける時代が、さらに鮮明になったといえます。
引用ソース
- Reddit Reddit r/LocalLLaMA: Kimi K3.1 Pro: “Create a high fidelity scene of pelican riding a bicycle” — https://www.reddit.com/r/LocalLLaMA/comments/1xdmqvy/kimi_k31_pro_create_a_high_fidelity_scene_of/
Kimi K3.1 Pro: “Create a high fidelity scene of pelican riding a bicycle”
- Web記事 記事全文: Kimi K3 vs Claude Fable 5: Full Benchmark Scorecard — https://aitoolsreview.co.uk/insights/kimi-k3-vs-claude-fable-5
Update, checked 25 September 2026: Claude Fable 5.1 has since launched.
Anthropic launched Claude Fable 5.1 on 1 September 2026, six weeks after this comparison published. Base API pricing is unchanged at $10/$50 per mil - X Xトレンド: パーソナルAIエージェント — https://trends24.in/japan/
パーソナルAIエージェント
- Web記事 記事全文: Claude Opus 5 vs Kimi K3: Benchmarks & Cost | BenchLM.ai — https://benchlm.ai/compare/claude-opus-5-vs-kimi-k3
Coding work
Code generation, repair, and software-engineering tasks
Claude Opus 5
Claude Opus 5 has the higher public coding point estimate, 70.8 to 58.9, with Supported evidence for both models. The conditional ranges d - Web記事 Web検索: Claude Opus 5 vs Kimi K3: Full Benchmark Comparison (July 2026 … — https://codingfleet.com/blog/claude-opus-5-vs-kimi-k3/
Claude Opus 5 vs Kimi K3: Full Benchmark Comparison (July 2026 …
- Web記事 Web検索: Claude Opus 4.6: Benchmarks, Capabilities, and the Agentic Shift — https://deepreviewai.com/reviews/2026-02-05_claude-opus-4-6-technical/
Claude Opus 4.6: Benchmarks, Capabilities, and the Agentic Shift
- Web記事 Web検索: Kimi K3 vs Claude: Benchmarks & 2026 Verdict | Zentor Blog — https://zentor.ai/blog/kimi-k3-vs-claude
Kimi K3 vs Claude: Benchmarks & 2026 Verdict | Zentor Blog
- Web記事 Web検索: Claude AI Agents | Architecture & Deployment Guide 2026 — https://dextralabs.com/blog/claude-ai-agents-architecture-deployment-guide/
Claude AI Agents | Architecture & Deployment Guide 2026
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。

RECENT COMMENTS