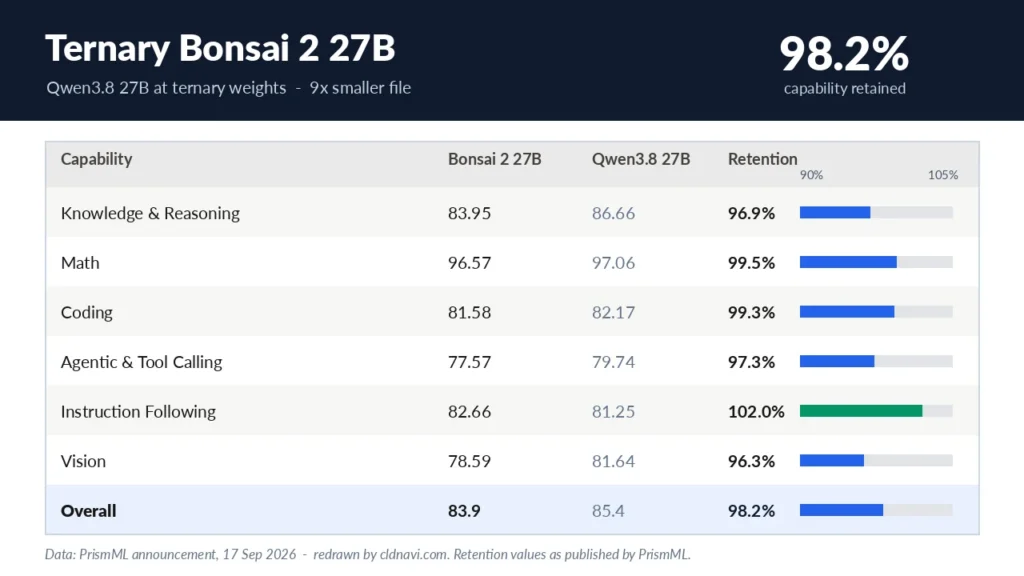
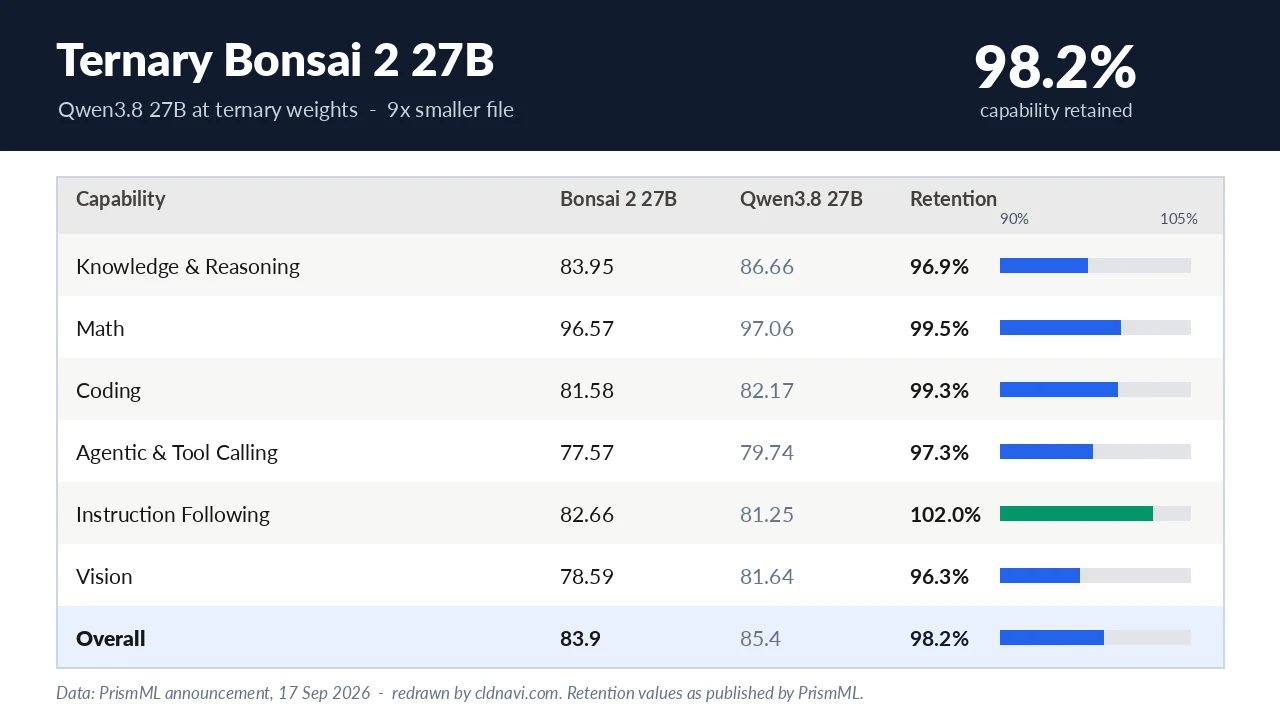
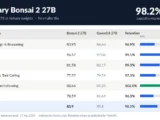
AIモデルをデスクトップで動かす話では、27B級の推論がローカルで現実味を帯びてきました。PrismMLのTernary Bonsai 2は、Qwen3.8 27Bを三値量子化し、重みを-1、0、+1で保持します。実効1.72ビットでファイルサイズは5.9GBとなり、フル精度の53.8GBと比べると約9分の1に縮みました[2]。2026年9月17日に公開され、20件の思考モードベンチマーク(推論の質を測る試験)で平均83.9を記録し、元モデルの85.4に対する保持率は98.2%とされています[2]。
話題の中心は、この圧縮モデルをどのランタイムで動かすかです。従来のllama.cpp系では、量子化ブロックの大きさ(QK)がPrismMLの128と上流の256で一致せず、噛み合いませんでした。そのため、CUDA(GPU計算)に層を逃がすと詰まるか壊れるという報告がありました[1]。flashのような軽量AIではなく、27B級を小型化した点が面白いところです。初代Bonsai 27Bがスマホで動くことで注目されましたが、第2世代はエージェント型コーディング、マルチモーダル推論(画像なども含む推論)、長いツール利用時の品質に力点を置いています[2]。
llama.cppの派生版ik_llama.cppでは、上流の量子化形式(TQ2_0やTQ1_0)をPrismML向けのPQ2_0へ無損失で再パックするスクリプトが使えるようになりました。trit(三値の重み)をそのまま保つため再量子化は不要で、CUDAとCPUの両方でネイティブに動くというガイドがRedditに投稿されています[1]。一方、公式のllama.cppや現在のOllamaでは動かない点に注意が必要です[2]。llama.cpp本体での対応の議論もあり、group-128 ternary(128グループごとの三値量子化)の扱いが論点になっています[6]。
セットアップの選択肢も増えました。Docker(コンテナで動かす仕組み)イメージでは、OpenAI互換API(同じ形式で呼び出せるAPI)で起動し、12GBカードで262144トークンのコンテキストを載せられる実験版があります[3]。ただし、GPUに置く層とCPUに置く層を分ける指定を忘れると、サーバーは動くのに約10倍遅くなるという落とし穴も書かれています[3]。
8GBのNVIDIAカード向けには、専用ビルドが公開されています。RTX 5060 8GBでは、decode(トークンを1つずつ生成する段階)が54.3 tok/sで、MTP speculative decoding(次のトークンを先読みして速める仕組み)を加えると65〜73 tok/sになります。prefill(プロンプト全体を一括処理する段階)は512トークン処理で680でした。公式バイナリの39.6 tok/s、512トークン処理で267と比べると、報告ではdecodeで約37%、prefillで約95%の改善が示されています[4]。上流mainline(開発の本体系統)への再統合版では、同じ40Kコンテキストで12MiB少ないVRAM(GPUメモリ)で済むとされています[4]。
実用面では、思考の長さを調整すると扱いやすくなります。ある利用者は、思考の強さをxhighからmediumに変更し、自己推測デコーディング(直前に出たトークンを活かして速める仕組み)を加えました。これにより、エージェント型コーディングで生成が速まり、量子化由来の誤りが少ないと評価しています[5]。別のローカル実測記事やセットアップガイドも出ており、話題は拡散しています[7][6]。
ただし、速さの裏に制約があります。8GB向けビルドは未統合のカーネルに依存し、上流mainlineへの再統合ではMetalとVulkan(別のGPU向けAPI)の不備が残るとされています[4]。Dockerの実験版も、KVキャッシュ(生成に使う中間記憶)の扱いに制約があり、モデルファイル自体は同じです[3]。DSparkのdrafterは、限られたVRAMでは推奨外と書かれています[3]。
つまり、Ternary Bonsai 2は「AIをローカルで動かす」話で、単なる圧縮ではなく、ランタイムの壁を越える工夫が話題になっています。16GB Apple Silicon、12GB VRAM(GPUメモリ)、32GB CPUメモリといった目安はありますが、使うバージョンと設定で結果が変わります[2][3][4]。今後のllama.cpp本体への反映が、hacker的な試行から日常の推論へ進む鍵になりそうです[1][6]。
引用ソース
- Reddit Reddit r/LocalLLaMA: [Guide] Ternary Bonsai 2 is finally 100% working on ik_llama.cpp (Native CUDA offload + Fast CPU -rtr) — https://www.reddit.com/r/LocalLLaMA/comments/1xkcg2y/guide_ternary_bonsai_2_is_finally_100_working_on/
[Guide] Ternary Bonsai 2 is finally 100% working on ik_llama.cpp (Native CUDA offload + Fast CPU -rtr)
- Web記事 記事全文: Ternary Bonsai 2 27B Local Guide 2026: Specs, Quantization and Hardware … — https://cldnavi.com/en/blog/bonsai-2-27b-local-2026/
← Back to articles
Summary
you need 16 GB of unified memory on Apple Silicon, or 12 GB of VRAM on Windows and Linux, or 32 GB of system memory for CPU-only inference. There is one big catch: stock llama.cpp and current O - Web記事 記事全文: ternary-bonsai-27b-gguf-llamacpp-cuda – GitHub — https://github.com/mahald/ternary-bonsai-27b-gguf-llamacpp-cuda
Docker image and compose setup for serving prism-ml/Ternary-Bonsai-27B-gguf with CUDA and an OpenAI-compatible API.
:v4 is experimental. It no longer builds official llama.cpp but
buun-llama-cpp, a research
fork whose ow - Web記事 記事全文: GitHub – snailium/bonsai2-8gb: Prebuilt llama.cpp for Ternary Bonsai 2 … — https://github.com/snailium/bonsai2-8gb
Prebuilt llama.cpp binaries for Ternary Bonsai 2 27B on 8 GB NVIDIA cards, with working MTP speculative decoding.
Measured: 54.3 tok/s kernel-only, 65–73 tok/s with MTP, pp512 680 on an RTX 5060 8 GB. The stock PrismML r - Web記事 記事全文: Ternary Bonsai 2 Usage Tips [2026] – Dot Net Perls Blog — https://www.dotnetperls.com/2026_9_19_ternary-bonsai-2-usage-tips
I spent some time using llama-cpp with Ternary Bonsai 2. Over the last couple days I had determined that this model, based on Qwen 3.8 27B, has potential for agentic coding, so I decided to try to improve its performance
- Web記事 Web検索: Supporting Ternary Bonsai in llama.cpp; group-128 ternary … – GitHub — https://github.com/ggml-org/llama.cpp/discussions/22019
Supporting Ternary Bonsai in llama.cpp; group-128 ternary … – GitHub
- Web記事 Web検索: How to Run Bonsai 2 Locally: 2026 Setup Guide | AINovaTools — https://ainovatools.com/guides/how-to-run-bonsai-2-locally
How to Run Bonsai 2 Locally: 2026 Setup Guide | AINovaTools
- Web記事 Web検索: Tested Bonsai 2 27B Locally (Ternary Model) – Dot Net Perls — https://www.dotnetperls.com/2026_9_18_tested-bonsai-2-27b-locally
Tested Bonsai 2 27B Locally (Ternary Model) – Dot Net Perls
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS