📌 エグゼクティブサマリー
NVIDIAがGemma 4ベースの小型モデル「Nemotron 3.5 Bolt E4B 4GB」を公開しました。約4GBのメモリで動き、先行モデル比で品質は平均約40%向上、出力トークンは最大約80%削減です。簡潔さ重視の設計とDFlashとの併用で、ローカル音声アシスタントの現実味を高めています。
音声アシスタントをクラウドに頼らず、手元のGPUで動かす。そのための専用モデルとして、NVIDIAの「Nemotron 3.5 Bolt E4B 4GB」が話題です。4GBという小ささでありながら、エージェントとしての振る舞いを磨いた点がポイントです。ローカルLLM好き、いわゆるハッカーカルチャーのコミュニティr/LocalLLaMAでも、いち早く共有されました[1]。
前回取り上げたNemotron 3.5ファミリーの、さらに小さい側に当たるモデルです。GoogleのGemma 4 E4B-itをベースに、NVIDIAが追加学習を施しました。全体は8Bパラメータですが、推論時に実際に動く部分は約4Bに抑えられています[3]。重みを圧縮してメモリを節約する量子化(Q4_K_M)の形式で配布され、目標は約4GBのメモリに収めることです[2][3]。これは同じパイプライン上のアプリや別のモデルに、メモリの余裕を残すためです[2]。同ファミリーには74B-A9Bの大型モデルもあり、Bolt E4BはスマートフォンやJetsonボードなど、メモリの少ない機器を狙う小型側です[3]。モデルカードは2026年10月23日付、学習データのカットオフは2026年5月でした[3]。
用途は音声・デバイスアシスタント、ゲームのキャラクター、ロボットやIoTのインターフェースです[2]。PCやモバイル、家電、OSの操作からカスタマーサポート、車載の体験までが想定されています[2]。会話のセッションをまたいでアプリのAPIを呼べるツール使用を改善した点も特徴です。短く答えるよう促す「会話モード」も備えます[2][3]。さらに複雑な要求のときだけ思考を有効化し、その上限を遅延目標に合わせて設定できる仕組みがあります[2][3]。コンテキスト長は64k、対応言語は35です。ベースモデルは140以上の言語で学習されています[2]。
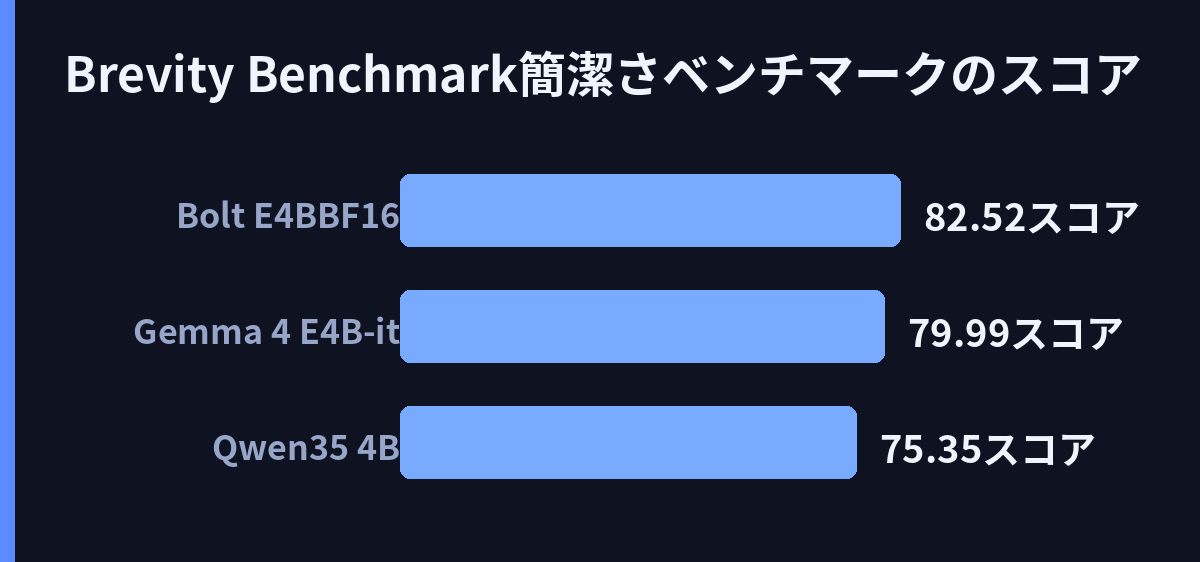
性能で目を引いたのは2つの数値です。自社の先行モデル比で平均約40%高い品質。そして出力トークン数が同クラスの他モデル比で最大約80%少ないことです[2]。トークンが少なければ応答は短く、音声のやり取りも速くなります。NVIDIAが報告する「Brevity Benchmark(簡潔さのベンチマーク)」では、フル精度(BF16)のBolt E4Bが82.52を記録しました。ベースのGemma 4 E4B-itが79.99、Qwen3.5 4Bが75.35です[3]。
鍵になる指標はTTFT、つまり最初の一言が出るまでの待ち時間です。音声アシスタントでは、推論ベンチマークの数点よりも、この遅延のほうが体感を左右します[3]。速度向上のためのspeculative decoding(推測的デコーディング)にも対応します。小さな下書きモデルが候補を先回りさせ、本体が検証することで生成を速める仕組みです。専用の下書きモデル「DFlash」も一緒に公開されました[1][6]。GGUF版はggml-orgとunslothから出ており、フル精度(BF16)版も用意されています[1]。
一方で、このモデルは賢さを競うために作られていません。モデルカードは目的を「生の知性ではなく」と明言し、簡潔さと道具扱いの改善に絞っています[3]。簡潔さスコアも、ベースモデルとの差は2.5ポイントほどです。差が開いているのはQwen3.5 4Bとの比較のほうです[3]。また、公開情報はベンチマーク値が中心で、TPS(1秒あたりのトークン処理数)やTTFTの実測値は素材には見つかりませんでした。速度の実感は、GGUF版を動かしたユーザーの報告を待つ段階のようです。
重みだけでなく、学習データやレシピも公開する方針です[3]。Artificial Analysisの分析ページ[4]や技術レポート[5]、リリースを追う追跡サイト[6]もすでに整っています。エッジ(手元のデバイス)向けAIでは、モデルの大きさよりも「1GBあたりでどれだけ賢く、どれだけ速く答えるか」が勝負になっているようです。4GBに収まるモデルで音声アシスタントをローカルで完結させる——その選択肢を現実的にした点が、この小型モデルのいちばん大きな意味でしょう。
RECENT COMMENTS