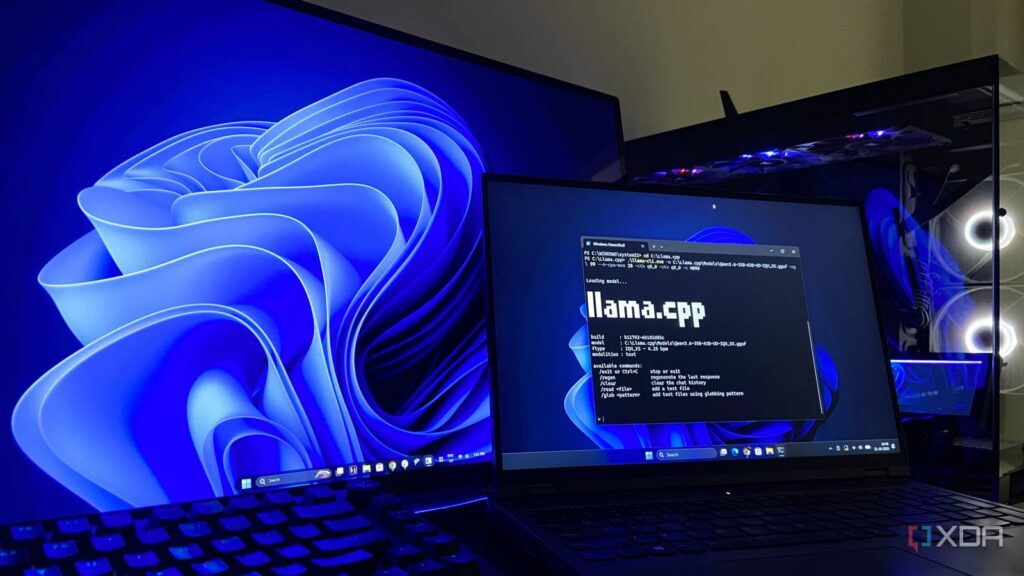
「スマホ1台で350億パラメータのAIモデルを動かす」——そんな試みが、名前のついた道具になりました。Hacker Newsに「Show HN」形式で投稿されたのは、llama.cppの上に重ねるレイヤー「BigMoeOnEdge」です[1]。ソースコードはGitHubで公開されています[1]。名前からして、エッジデバイス(ネットワークの端にあたるスマホやノートPCなどの端末)での巨大MoE実行を狙ったもののようです。個人の設定工夫にとどまっていた動きが、専用の道具という形を見せ始めました。
なぜスマホでも巨大モデルが動くのか。鍵はMoE(Mixture-of-Experts、混合エキスパート)という構造です。モデル内の「専門家」役のうち、質問ごとに必要な一部だけを計算に使う仕組みで、XDAが取り上げたQwen3.6-35B-A3Bでは、35Bのパラメータのうち推論時に活性化するのは約3B、残りは休眠しています[2]。使わない部分は計算されないため、メモリに「置いておく」だけで済みます。
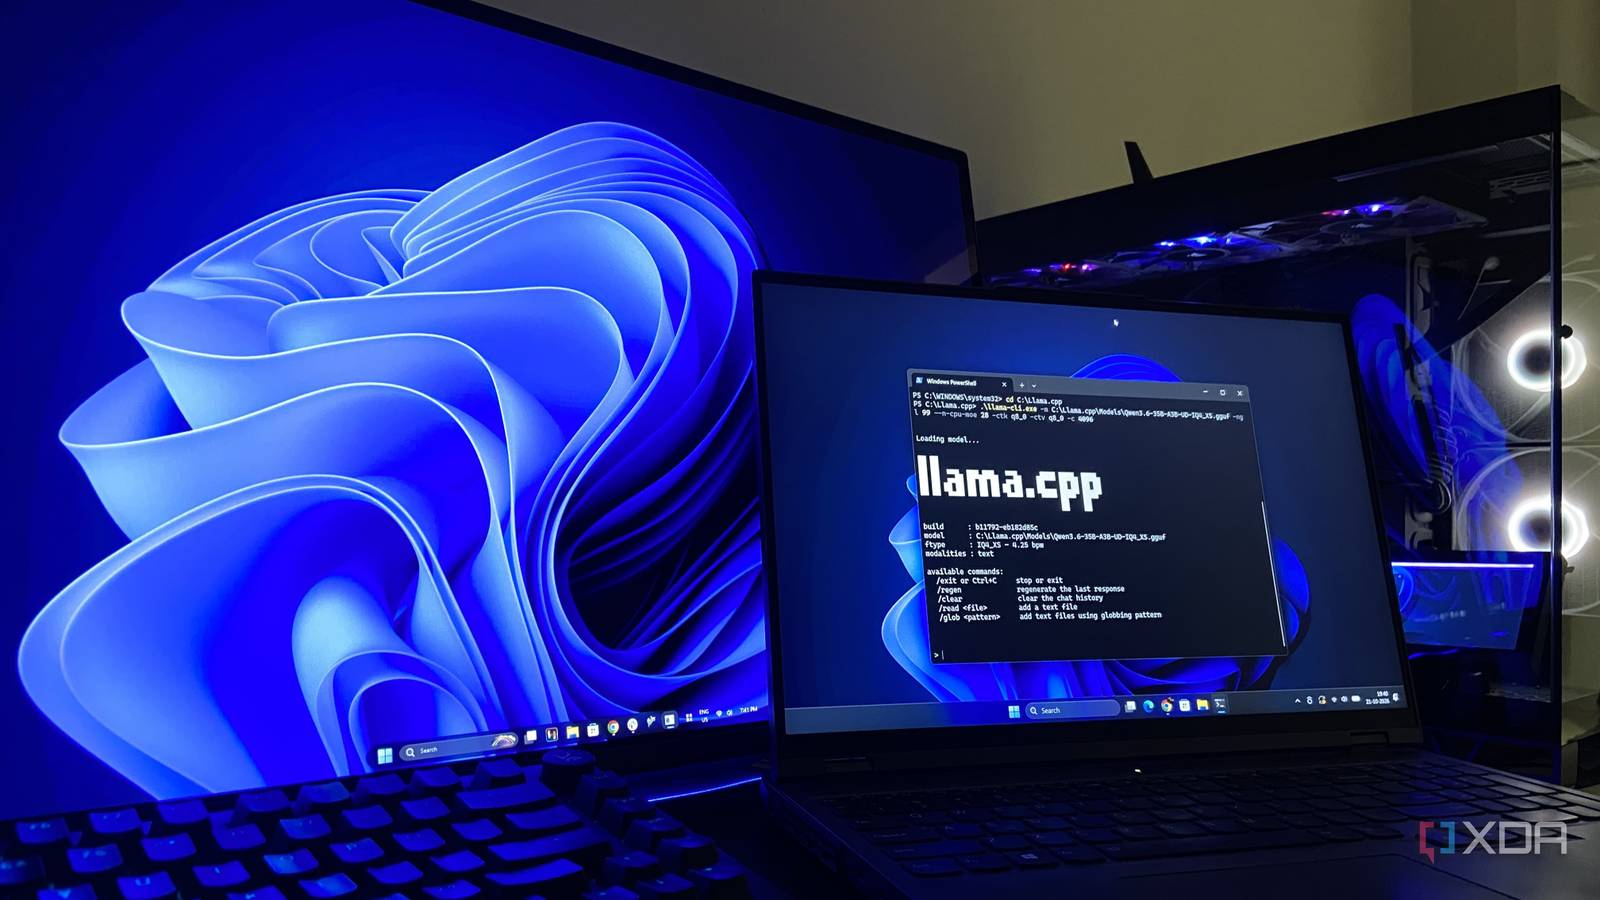
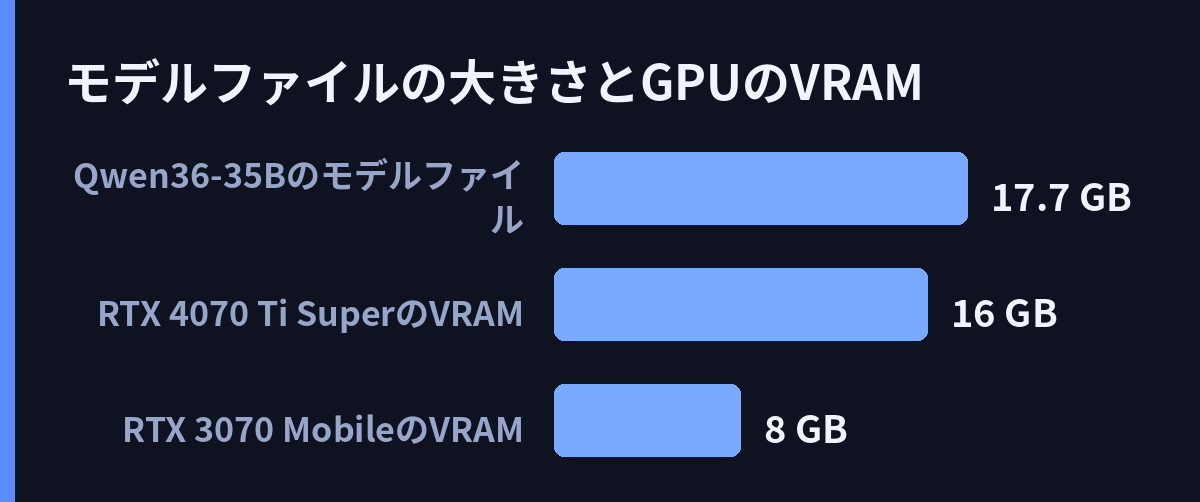
この休眠部分をどこに置くかが肝になります。XDAのライターは、8GBのRTX 3070 Mobileを搭載したノートPCで、約17.7GBのモデルファイル(4ビット台の量子化、32Kコンテキスト)を動かしました[2]。量子化とは、重みを圧縮してメモリを節約する仕組みです。著者は当初、このモデルは16GBのVRAMを持つRTX 4070 Ti Super向けで、8GBのノートPCは「最初から対象外」と決めつけていました[2]。ところが、全層をいったんGPUに載せてから、エキスパート部分だけをRAMへ剥がして戻す指定(–n-cpu-moe)を使えば、常時使う部分はGPUに、休眠層はRAMに置けます[2]。デスクトップでは、このモデルが著者がテストした中で最速だったといいます[2]。本来ならVRAMに収まらないはずのサイズですが、MoEがその計算を変えてしまったのです[2]。VRAMの壁は、設定次第で越えられるわけです。
こうした動きを支える解説や研究も増えてきました。VRAMが少ない環境で大きなモデルを動かすためのMoEオフロードのガイド[4]や、llama.cpp内部のMoEアーキテクチャを整理した解説[7]、大規模MoEモデルの推論性能を最適化するためのガイド[6]が公開されています。スマホ側の基礎資料としては、モバイルプラットフォームでのLLM性能を計測したarxivの研究[5][8]もあります。XDAの著者自身、ローカルAIの土台をOllamaからllama.cppへ移したと書いており[2]、llama.cppがそうした実験の共通の土台になっているようです。
しかし、話題の熱量にはまだ温度差があります。「Show HN」は自分で作ったものを紹介する投稿形式で、関心の高さはポイントとコメント数に表れます。今回の投稿は、現時点で1ポイント・コメント0件にとどまっています[1]。ツール紹介サイトのカタログでも、料金や詳細プランは未確認とされ、機能欄はAIアシスタント、自然言語インターフェース、ワークフロー自動化といった一般的な記載にとどまります[3]。レビューもまだ投稿されていません。
数字の面でも、控えめに見るべき点があります。トークン速度は、回答が1秒間にどれだけ生成されるかを示す指標ですが、今回の素材にはスマホでこのレイヤーを動かした実測値は見つかりませんでした。PCでの実証[2]は積み上がっていても、スマホという制約の強い環境でどこまで出せるかは、まだ検証の途中のようです。「ストリーミング」と銘打つ以上、速度とメモリ使用量の公開が次の関門になるでしょう。
それでも流れははっきりしています。VRAMの壁を「設定で越える」段階から、「専用レイヤーでスマホまで届く」段階へ進んだように見えることです。BigMoeOnEdgeそのものの評価はこれからのようですが、休眠層をRAMへ追い出す発想がエッジデバイスでも通用することを示す材料になりました。次に注目したいのは、スマホでの実測速度と、どのモデルが快適に動くかの検証です。
引用ソース
- Hacker News Hacker News: Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop — https://github.com/Helldez/BigMoeOnEdge
Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop
- Web記事 記事全文: I changed one llama.cpp flag, and my 8GB laptop GPU now runs a 35B … — https://www.xda-developers.com/i-stopped-thinking-my-8gb-gpu-was-too-small-after-learning-to-offload-moe-llm-layers-to-ram/
A lot of what you can do with your PC seems to be limited by the VRAM its GPU has. It decides what resolution your games run at, how large a video project you can edit without the timeline stuttering intermittently, and
- Web記事 記事全文: A layer on top llama.cpp enabling big MoE streaming on phone and laptop — https://www.toolcenter.ai/en/tools/a-layer-on-top-llama-cpp-enabling-big-moe-streamin
Pricing
Detailed plans have not been confirmed in our catalog. Check the official website for current limits and billing terms.
Visit Website
Prices and limits may change. Confirm the currency, billing period, seat minim - Web記事 Web検索: Run Bigger Local AI Models on Less VRAM: llama.cpp MoE Offloading Guide … — https://aliteq.com/llama-cpp-moe-offloading-run-bigger-models-less-vram
Run Bigger Local AI Models on Less VRAM: llama.cpp MoE Offloading Guide …
- Web記事 Web検索: Understanding Large Language Models in Your Pockets: Performance Study … — https://arxiv.org/html/2410.03613v2
Understanding Large Language Models in Your Pockets: Performance Study …
- Web記事 Web検索: Guide to optimizing inference performance of large MoE models across … — https://gist.github.com/DocShotgun/a02a4c0c0a57e43ff4f038b46ca66ae0
Guide to optimizing inference performance of large MoE models across …
- Web記事 Web検索: Mixture-of-Experts (MoE) Architectures | alesha-pro/llama.cpp | DeepWiki — https://deepwiki.com/alesha-pro/llama.cpp/5.2-mixture-of-experts-(moe)-architectures
Mixture-of-Experts (MoE) Architectures | alesha-pro/llama.cpp | DeepWiki
- Web記事 Web検索: Large Language Model Performance Benchmarking on Mobile Platforms: A … — https://arxiv.org/html/2410.03613v1
Large Language Model Performance Benchmarking on Mobile Platforms: A …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS