「AIは結局、すべてローカルで動くようになる」。こんな主張が、RedditのローカルAIコミュニティに投稿されました[1]。投稿者は、用途に特化した小さなモデルこそが未来だと論じます。今回の素材を見ると、この主張を裏づける報告が相次いでいます。ローカルAIをめぐる話が、思想から実際の動きへ進み始めたように見えます。
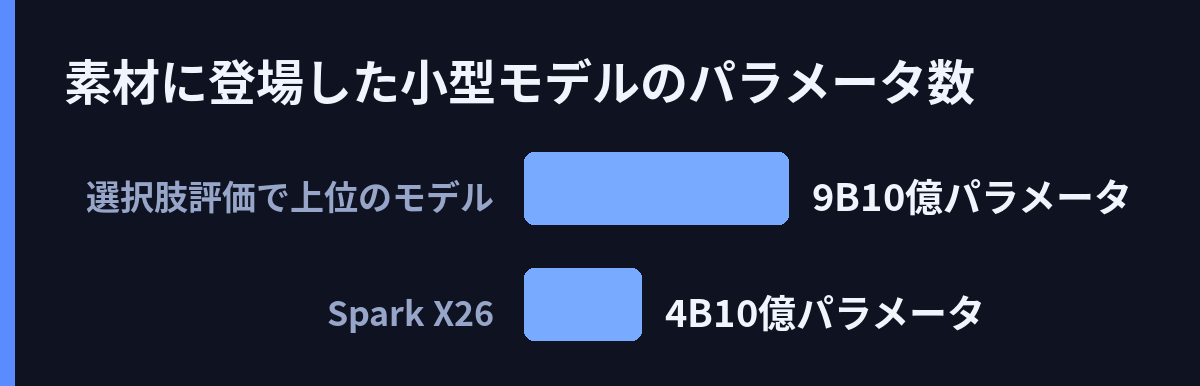
まず、小型モデルの実力を示す報告です。Redditユーザーが、4B(40億パラメータ)のモデル「Spark X2.6 4B」を試した結果を投稿しました[7]。目立つのはツール呼び出し(モデルが外部ツールを使って作業を進める機能)の正確さです。Blender用のPythonスクリプトを書かせると、赤い立方体の作成から回転、レンダリングまでこなしたといいます。複雑なRustコードベースも読み解き、アプリのある部分と別の部分で、同じ仕組みが少し違う動きをする点まで説明できたと報告されています。ツール呼び出しは12回で、無駄なく要点に直行しました。スキルや拡張を外した状態でも、グローバル設定ファイル(agents.md)を見つけ、毎回変更ファイルの一覧を書き出しています。
軽さも売りです。KVキャッシュ(会話の文脈を保持するメモリ領域)が小さく、速くて軽いと投稿者はまとめました。ただし画像を見る機能は備えておらず、設定は温度1.0だけで他はいじっていません。生成を速めるMTP(複数のトークンを一度に予測する仕組み)への対応も近いと書かれています。
この報告を支えるのが、冒頭の主張です。OCR(画像から文字を読み取る処理)は、すでに一桁Bのモデルで解かれつつあります[1]。セグメンテーション(画像を領域ごとに切り分ける処理)も同様です。選択肢の評価のような作業なら、9Bのモデルがベンチマークで上位に立つ例も挙げられました。経済的な事情も背景にあります。Opus 5.5のような現行モデルは群を抜く一方、サブスクリプションでは多額の赤字を出していると投稿者は指摘します。仮に「1つのモデル」と呼び続けるとしても、中身は百個のモデルの集まりになるかもしれない、という予測まで書かれていました。
学術側も同じ方向を向いています。端末内言語モデルの包括レビューでは、遅延の減少、データを端末内に留めること、パーソナライズした体験が、端末搭載の動機と整理されました[3]。鍵となるのは量子化(重みを圧縮してメモリを節約する仕組み)です。もうひとつの知識蒸留は、大きなモデルの知識を小さなモデルに教える手法です。端末とクラウドが分担する形態も分析対象になりました。
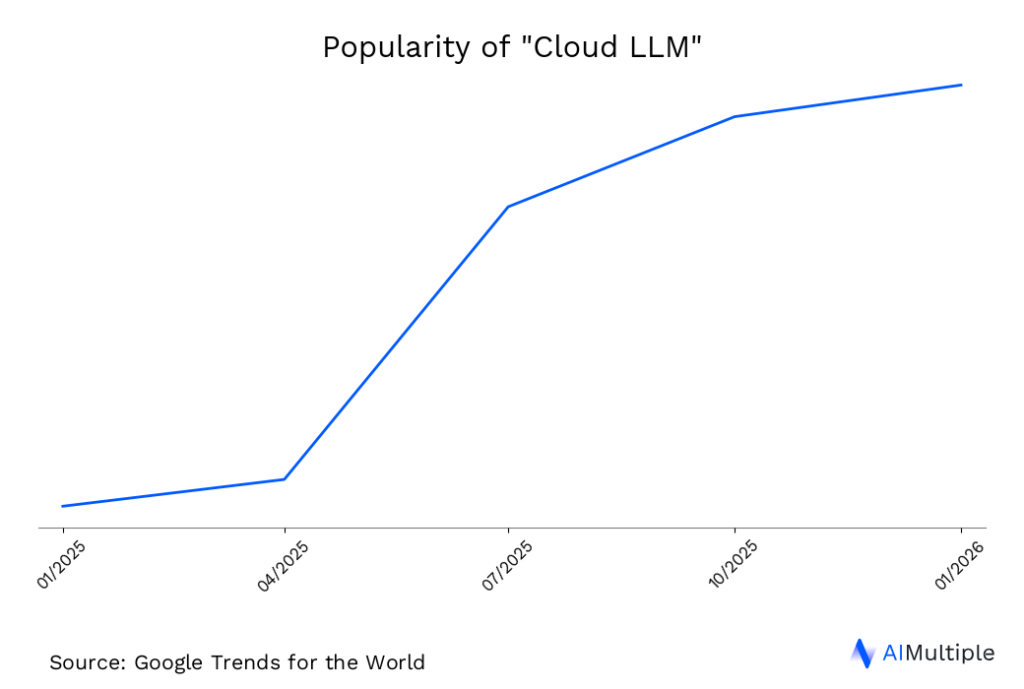
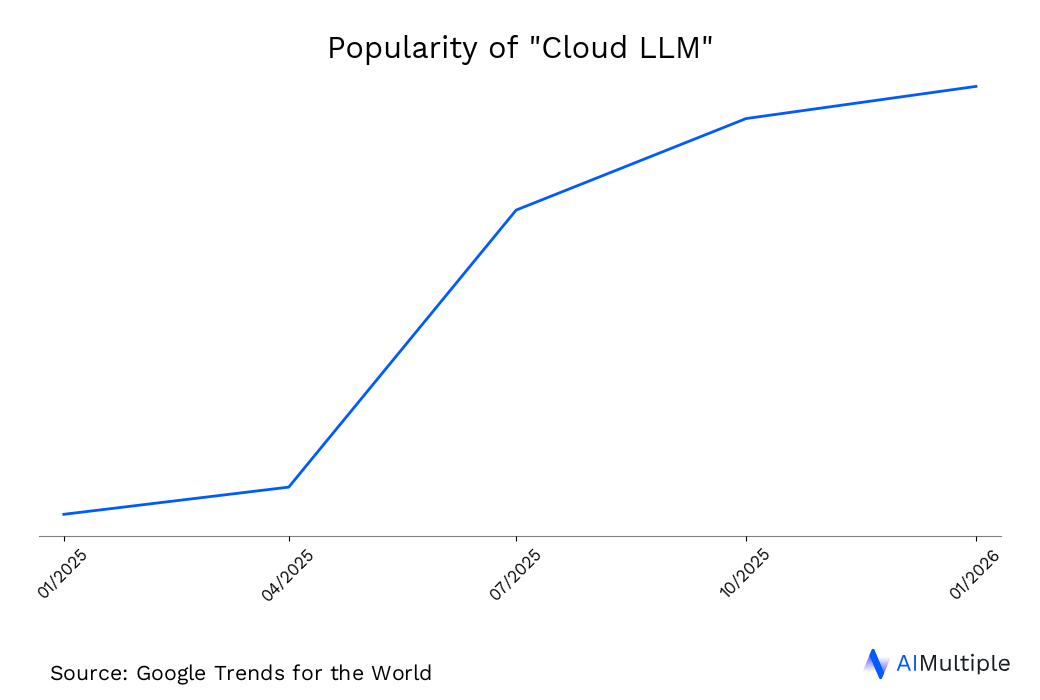
実務向けの解説記事も、GPT-5.5やClaude Opus 4.7、Gemini 3のPro/FlashシリーズといったクラウドLLMと、Llama 4やDeepSeek V4などのローカルLLMを対比しています[6]。クラウドは使った分だけ払う方式で、利用が増えると費用がかさみます。ローカルはプライバシーとカスタマイズで優位とされます。そして象徴的なのがmacOS 27の報告です。ターミナルから呼び出せるオフラインLLMが、OSに標準で組み込まれたという投稿がハッカーニュースに上がりました[5]。OSメーカーまでが端末内推論に踏み込んだことになります。
しかし、手元で動かす未来には課題も見えてきます。Redditでは「Hugging Faceからモデルが消える」という報告が上がりました[4]。ダウンロードが途中で止まって再開できず、確認すると、検閲を外した派生モデルや攻撃的なサイバー用途を名乗るモデルが消失していたといいます。どこへ消えたのか、投稿者自身にも分からない状態です。安全面の不安も出ています。ハッカーニュースでは「ローカルLLM向けの、安全で最小構成のWebフロントエンドは?」という質問が立ちましたが、回答はまだ付いていません[8]。手元のモデルを外部に安全に公開する方法は、まだ確立していないようです。こうした中、オープンソースのテストツール「Dánwò」が公開されました[2]。E2Eテストは、アプリ全体の動きを自動で確認する手法です。Dánwòでは、実機の代わりに動作を再現するエミュレータと、障害をわざと起こすフォルト注入を組み合わせられます。品質を支える道具も、少しずつ揃い始めています。
小型特化モデルの実力証明と、OSレベルでの搭載。ローカルAIは着実に現実味を増しています。一方で、モデルの供給元が不安定になり、安全な使い方を問う声が増えたのも事実です。汎用の巨大モデルはクラウドへ、日常の定型タスクは手元の小型モデルへ。そんな役割分担が進む中で、次に注目したいのは、モデルの流通と安全性を支える土台が追いつくかどうかです。
引用ソース
- Reddit Reddit r/LocalLLaMA: everything will be local eventually — https://www.reddit.com/r/LocalLLaMA/comments/1xdcpxb/everything_will_be_local_eventually/
everything will be local eventually
- Hacker News Hacker News: Show HN: Dánwò – Open-source E2E testing with emulators and fault injection — https://github.com/carbonmeai/danwo
Show HN: Dánwò – Open-source E2E testing with emulators and fault injection
- Web記事 記事全文: On-Device Language Models: A Comprehensive Review — https://arxiv.org/html/2409.00088v1
On-Device Language Models: A Comprehensive Review
Abstract
The advent of large language models (LLMs) revolutionized natural language processing applications, and running LLMs on edge devices has become increasingly attr - Reddit Reddit r/LocalLLaMA: Models disappearing from Huggingface — https://www.reddit.com/r/LocalLLaMA/comments/1xd7ptj/models_disappearing_from_huggingface/
Models disappearing from Huggingface
- Hacker News Hacker News: macOS 27 has a built-in, offline LLM you can call from Terminal — https://news.ycombinator.com/item?id=50185265
macOS 27 has a built-in, offline LLM you can call from Terminal
- Web記事 記事全文: Cloud LLM vs Local LLMs: Examples & Benefits — https://aimultiple.com/cloud-llm
Cloud LLMs, powered by advanced models like GPT-5.5 and Claude Opus 4.7, offer scalability and accessibility. Conversely, Local LLMs, driven by open-source models such as Llama 4, DeepSeek V4, and Qwen3.6-Plus, ensure st
- Reddit Reddit r/LocalLLaMA: Spark X2.6 4B is the best of it’s size — https://www.reddit.com/r/LocalLLaMA/comments/1xe1kkh/spark_x26_4b_is_the_best_of_its_size/
Spark X2.6 4B is the best of it’s size
- Hacker News Hacker News: Ask HN: Secure minimalistic web front-ends to Local LLM’s? — https://news.ycombinator.com/item?id=50210227
Ask HN: Secure minimalistic web front-ends to Local LLM’s?
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS