ローカルでAIモデルを動かす定番ツールllama.cppで、NVIDIA GPU向けの推論速度を底上げする改造が相次いでいます。中でも目を引くのは、モデル内部の行列計算を「融合」して1つにまとめるPRです。DGX Sparkでは最大10.7%の速度向上が報告されました[1]。
このPR(#29948)が手を入れたのは、FFN(モデル各層にある中間の行列計算部分)の処理です。ゲートとアップという2つの行列計算を別々に行い、GLU(ゲートの値で情報の流れを調整する活性化処理)で組み合わせます。今回ベンチマークされた27B級や8B級のモデルも、この構造を持っています。従来は2つの計算とGLUを、別々のカーネル(GPU上の計算の単位)で処理していました。PRが手を入れるのはMMQという経路です。MMQは、量子化した重みの行列計算をGPUでまとめて処理するカーネル群です。量子化は、重みを圧縮してメモリを節約する仕組みです。このMMQで2つの行列計算とGLUを1つにまとめ、ゲートとアップの行を交互に並べ替えて、1回の処理で両方を扱えるようにしました[1]。
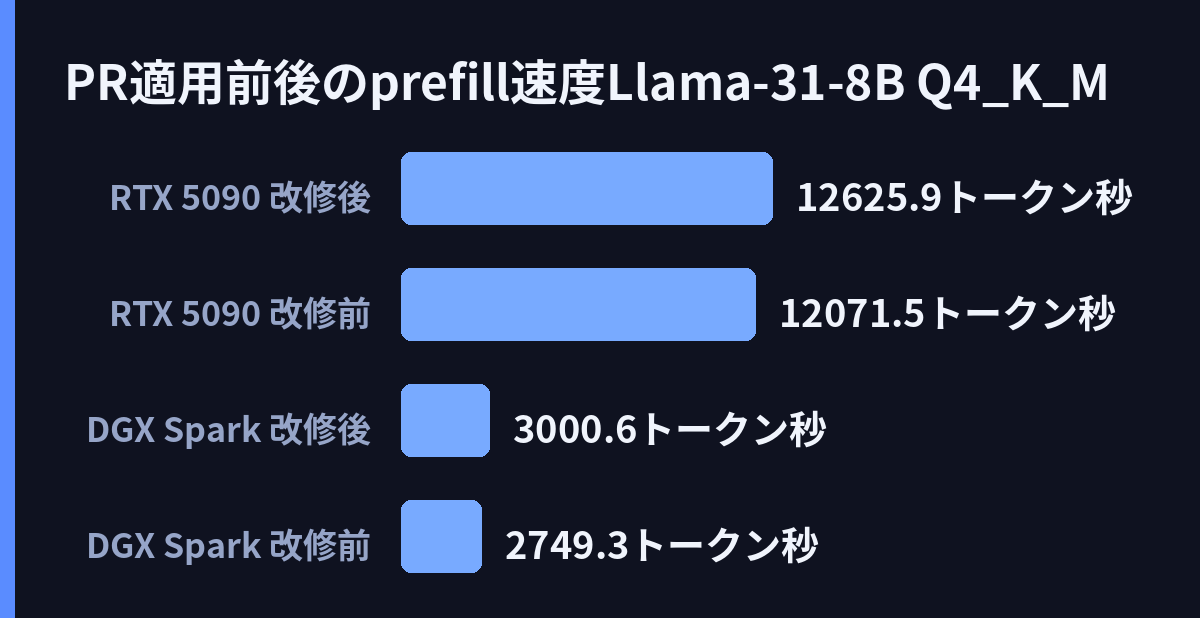
実測を見てみましょう。投稿者はllama-benchという測定ツールを使い、プロンプト16384トークン・生成トークン0という条件で測りました。つまりprefill(プロンプト全体を一括処理する段階)の速度です。DGX Spark(GB10)では、Qwen3.8-27BのQ4_K_Mが840.1から899.9トークン/秒へと+7.1%です。Llama-3.1-8BではQ4_K_Mが2749.3から3000.6トークン/秒(+9.1%)、IQ4_XSでは+10.7%に達します。Qwen3.6-27Bでも+6.0〜7.5%の改善が並びました[1]。
RTX 5090でも同じ条件で測定されています。Qwen3.8-27BのQ4_K_Mは3688.4から3790.9トークン/秒(+2.8%)。Llama-3.1-8BのQ4_K_Mは12071.5から12625.9トークン/秒(+4.6%)でした[1]。同じ改造でも、改善幅は機械によってかなり違います。
ここが面白いところです。DGX Sparkでは+4.6〜10.7%と大きく効く一方、RTX 5090では+1.9〜4.6%程度にとどまります。素材では理由の説明がありませんが、計算の融合が効きやすい環境と、そうでない環境があるようです。また、この種の最適化はNVIDIA専用の話でもありません。AMD GPU向けのPRでも、MMQとMoE(複数の小さな専門家モデルを切り替えて計算する構造)の整理が議論されています[7]。古いP100向けのパッチ集では、CUDAの量子化カーネルそのものが取り上げられています[6]。
llama.cppは2023年に公開された軽量な推論フレームワークで、C/C++製で依存が少ないことが人気です[2]。そのCUDA最適化については、NVIDIA自身のブログも解説しています。GPUが速くなるほど、カーネル1つ1つをCPUが起動するオーバーヘッドが積み重なり、ボトルネックになりがちです。CUDA Graphsは複数のGPU処理を1つの計算グラフとしてまとめて予約する仕組みで、llama.cppへの導入により性能が向上したと紹介されています[2]。計算の融合もCUDA Graphsも、処理のつなぎ目で失う時間を減らす点で共通しています。
動きは日本語圏にも届いています。16GB GPU向けに、v0.5.0の新機能による推論改善を解説した記事[4]や、decode(トークンを1つずつ生成する段階)で従来方式(MVQ)からMMQへ切り替わる境界を実行時に調整する機能を取り上げた記事[5]が投稿されました。推論速度を最大まで引き上げるノウハウをまとめた解説も出ています[8]。
llama.cppでは現在も多数のPRが開かれたまま開発が続いており[3]、CUDAまわりのコード(ggml-cuda)を中心に改良が積み重なっています。量子化した重みをそのまま速く回す工夫で、ハードを変えずに最大1割を超える速度向上が得られた例です。ローカル推論の速度は、モデルやGPUの買い替えだけでなく、こうした地味な最適化の積み重ねでも伸びることを、今回のPRは示しています。
引用ソース
- Reddit Reddit r/LocalLLaMA: CUDA: fuse FFN gate/up matmuls and GLU in MMQ with interleaved gate/up rows by anujj · Pull Request #29948 · ggml-org/llama.cpp — https://www.reddit.com/r/LocalLLaMA/comments/1xey0uw/cuda_fuse_ffn_gateup_matmuls_and_glu_in_mmq_with/
CUDA: fuse FFN gate/up matmuls and GLU in MMQ with interleaved gate/up rows by anujj · Pull Request #29948 · ggml-org/llama.cpp
- Web記事 記事全文: Optimizing llama.cpp AI Inference with CUDA Graphs — https://developer.nvidia.com/blog/optimizing-llama-cpp-ai-inference-with-cuda-graphs/
The open-source llama.cpp code base was originally released in 2023 as a lightweight but efficient framework for performing inference on Meta Llama models. Built on the GGML library released the previous year, llama.cpp
- Web記事 記事全文: Pull requests · ggml-org/llama.cpp · GitHub — https://github.com/ggml-org/llama.cpp/pulls?q=is%3Apr+state%3Aopen+sort%3Aupdated-desc
You signed in with another tab or window. Reload to refresh your session.You signed out in another tab or window. Reload to refresh your session.You switched accounts on another tab or window. Reload to refresh your sess
- Web記事 Web検索: [For CUDA 16GB] llama.cpp v0.5.0 and New Features: Improved Inference … — https://note.com/samehadaonsen/n/n186e41b6e994?hl=en
[For CUDA 16GB] llama.cpp v0.5.0 and New Features: Improved Inference …
- Web記事 Web検索: [For 16GB CUDA] llama.cpp MVQ→MMQ decode crossover runtime adjustment … — https://note.com/samehadaonsen/n/n6f61248c96e0?hl=en
[For 16GB CUDA] llama.cpp MVQ→MMQ decode crossover runtime adjustment …
- Web記事 Web検索: CUDA Quantization Kernels | shinbunbun/llama-cpp-p100-patches | DeepWiki — https://deepwiki.com/shinbunbun/llama-cpp-p100-patches/3-cuda-quantization-kernels
CUDA Quantization Kernels | shinbunbun/llama-cpp-p100-patches | DeepWiki
- Web記事 Web検索: AMD PR Set 2 of 6 — Review and Summarization of MMQ and MoE – GitHub — https://github.com/ggml-org/llama.cpp/discussions/26349
AMD PR Set 2 of 6 — Review and Summarization of MMQ and MoE – GitHub
- Web記事 Web検索: How to Optimize llama.cpp for Maximum Inference Speed in 2026 — https://docs.bswen.com/blog/2026-03-15-llamacpp-optimization-speed/
How to Optimize llama.cpp for Maximum Inference Speed in 2026
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS