MoEの遅さは、計算そのものより「小分けにした処理の待ち合わせ」から来ることがあります。話題になっているのは、CUDA MoE kernelの融合です。CUDA MoE kernelは、NVIDIA GPU向けのMoE計算カーネルです。llama.cppでは、MoEのgateとupという2つの行列積を、GLUというゲート付きの活性化とまとめて処理するPull RequestがRedditで共有されています [1]。これはprefill、つまりプロンプト全体を一括処理する段階の速度を狙った改良です。MoEは、入力ごとに使う専門家expertを切り替える仕組みで、専門家が増えるほど処理が細かくなります。
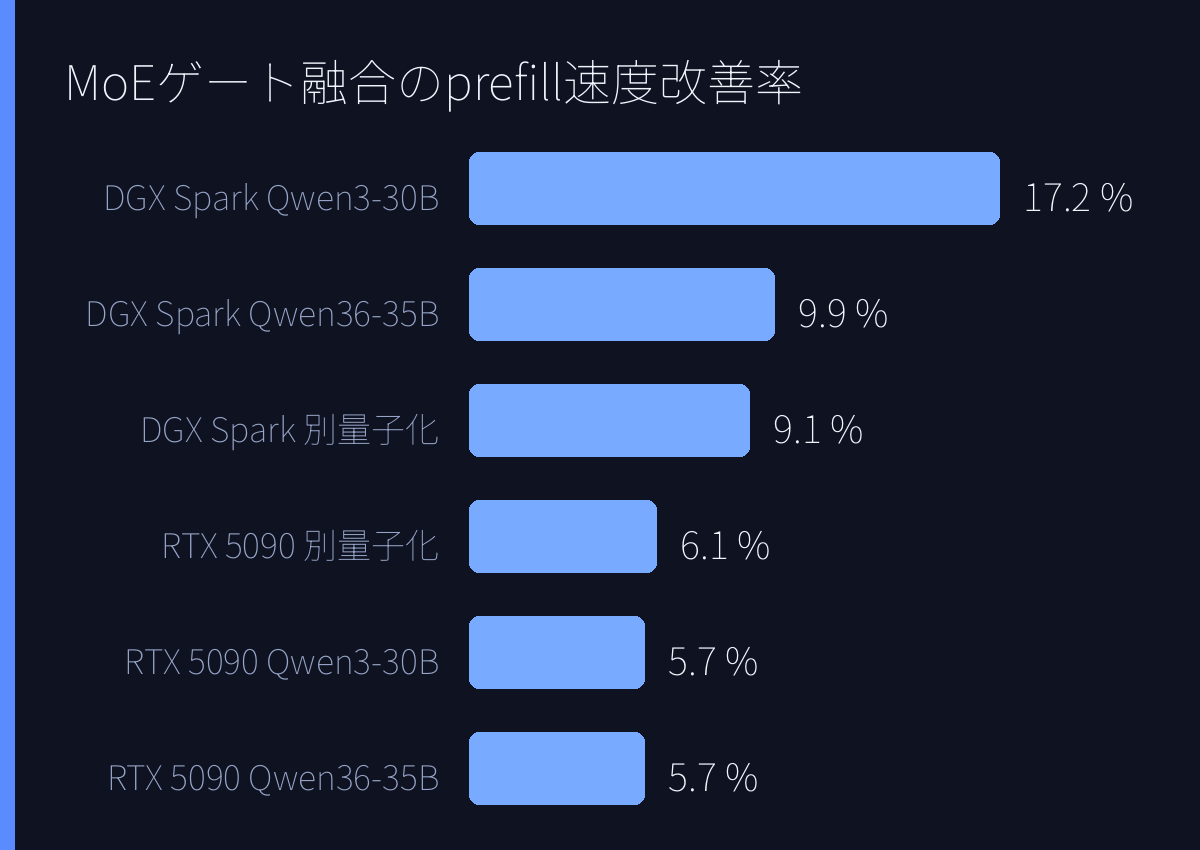
以前取り上げたCUDA MoEゲート融合の実測では、DGX SparkのGB10でQwen3-30B-A3Bを4ビット台の量子化、つまり重みを圧縮してメモリを節約する仕組み(例:Q4_K_M)で動かすと、2911.4から3410.8へ17.2%伸びました [1]。RTX 5090では同じ設定が12611.7から13330.3へ5.7%でした [1]。Qwen3.6-35B-A3Bでは、DGX Sparkで9.9%、RTX 5090で5.7%、別の量子化形式で9.1%と6.1%の改善が報告されています [1]。同じ改良でもGPUとモデルで伸び幅が違う点が面白いです。
GitHubのFused-MoEは、MoEの全体像をより細かく融合しています [2]。まずルートのsoftmaxとtop-k選択をまとめます。softmaxは重みを確率に変換する処理、top-kは上位k件を選ぶ処理です。次にgateとupの行列積、downの行列積をまとめます。活性化にはSiLUという関数を使います。さらに、散らした結果を重み付きで足すscatter加算も1回の呼び出しにまとめるという設計です [2]。unfused、つまり融合していない実装なら、ルーター、top-k、トークンの散らし、gate、up、活性化、downなどで5〜7回のカーネル起動が必要になります [3]。カーネル起動はGPUに作業を依頼する回数です。回数が減ると、途中結果をメモリに書き戻す往復が減ります。
注目したいのは、prefillとdecodeで分ける点です。decode、つまりトークンを1つずつ生成する段階では、処理するトークン数Mが小さいため、パディングで行列を大きくすると、埋め後の行列サイズM_padが膨らみます [2]。Fused-MoEでは、大きなM向けの並び替えはprefillに有利ですが、小さなMではM_padが膨らむという弱点を認めています [2]。そこでMが128以下のときはPyTorchの簡易経路を使い、GPUとCPUが待ち合わせする同期を1回に抑えます [2]。M=1、expert 64、top-k=6なら、6回の専門家処理と1回の同期で済み、素朴な実装の64回同期より軽くなります [2]。
別の解説記事では、FlashInferという公開MoE評価資料を踏まえ、gate-upの二重の行列積を1つのカーネルに寄せる戦略を説明しています [3]。活性化にはSwiGLUを使います。SwiGLUは、SiLUという活性化関数を使ったゲート付きの掛け算です。ルーターが32のexpertから8を選び、8グループから4グループを選ぶような構成も例に挙がっています [3]。vLLMでは7回、SGLangでは5回、理想の完全融合なら1〜2回にできるという説明です [3]。この解説では、活性化メモリの通信を最大21.9%節約できるとしています [3]。
ただし、融合は万能ではありません。Fused-MoEの設計でも、速くしたい段階ごとに最適化する必要があります [2]。さらに、この実装はTritonというGPUカーネルを書くための仕組みで行列積を計算します。32ビット浮動小数点で累算し、16ビットのbfloat16形式で保存する構成です。AscendやMUSAといった異なるハードウェア向け環境も名指しされています [2]。融合は速さだけでなく、移植のしやすさも狙いになっています。Web検索では、同じFused-MoEのGitHub とcuda-kernel-wikiの解説 がそのまま関連結果として出てきます。
Web検索では、MoEの融合が推論だけを狙った話ではないことも見えます。分散機械学習の通信を計算と融合する研究 [4]、NVIDIAがMoE訓練のスループットを融合カーネルで高める記事 [5]、llama.cppでのCPU/GPU推論時のMoE行列積の順序に関する議論 [4]、Tritonで異なるハードウェア向けのMoEディスパッチを扱う検索結果 [5] が並んでいます。CUDA MoE kernelは、単に1つのPRの速度改善にとどまらず、prefillとdecodeの使い分け、メモリ往復の削減、複数ハードウェアへの移植という流れの中で試されています。次に見たいのは、どのGPUでどの量子化形式を使い、どの段階を融合すると、どれだけの待ち時間が消えるかという具体的な設計指針です。
引用ソース
- Reddit Reddit r/LocalLLaMA: CUDA: fuse MoE gate/up matmuls and GLU in MMQ by anujj · Pull Request #31188 · ggml-org/llama.cpp — https://www.reddit.com/r/LocalLLaMA/comments/1xhodj3/cuda_fuse_moe_gateup_matmuls_and_glu_in_mmq_by/
CUDA: fuse MoE gate/up matmuls and GLU in MMQ by anujj · Pull Request #31188 · ggml-org/llama.cpp
- Web記事 記事全文: GitHub – lvy010/Fused-MoE: A fused Mixture-of-Experts CUDA kernel that … — https://github.com/lvy010/Fused-MoE
fused_moe.py 将完整的 MoE 前向传播——softmax 路由、top-k 选择、gate-up GEMM、SiLU 门控激活、down GEMM 以及加权 scatter 归约——融合为一次优化调用。
hidden_states [M, K] ──► softmax + topk ──► 排序分发
│ - Web記事 記事全文: skills/skills/cuda-kernel-wiki/wiki/kernels/fused-moe.md at main … — https://github.com/Adversarr/skills/blob/main/skills/cuda-kernel-wiki/wiki/kernels/fused-moe.md
Fused MoE kernels combine the full Mixture-of-Experts forward pass into minimal kernel launches: routing, token dispatch, gate-up dual GEMM, SwiGLU activation, down projection GEMM, and token combine. In unfused implemen
- Web記事 Web検索: Optimizing Distributed ML Communication with Fused Computation … — https://arxiv.org/html/2305.06942v2
Optimizing Distributed ML Communication with Fused Computation …
- Web記事 Web検索: Boosting MoE Training Throughput with Advanced Fusion Kernels — https://developer.nvidia.com/blog/boosting-moe-training-throughput-with-advanced-fusion-kernels/
Boosting MoE Training Throughput with Advanced Fusion Kernels
- Web記事 Web検索: Questions about order of MoE matmul for CPU/GPU inference — https://github.com/ggml-org/llama.cpp/discussions/4628
Questions about order of MoE matmul for CPU/GPU inference
- Web記事 Web検索: Cross-Platform Fused MoE Dispatch in Triton: – arXiv.org — https://arxiv.org/html/2605.23911
Cross-Platform Fused MoE Dispatch in Triton: – arXiv.org
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。

RECENT COMMENTS