AI、flash、hackerといった語が並ぶ技術コミュニティでも、ローカルRAGの話題は尽きません。AI(人工知能)のローカルRAGについて、「0.1Bが8Bを殺した」という投稿が話題になりました。投稿者はRAGエージェントを開発中で、最大の懸念はローカル推論の計算力でした。外部APIを使えない用途では、埋め込みモデルを自分のPCで動かす必要があるからです[1]。
その環境は、新しいMac StudioやDGX Sparkではなく、8GB RAMのWindows PCや5年前のM1 MacBook Airです。投稿者は、Qwen3-Embedding-0.6Bのような密な埋め込みモデルでも、小さなPCでは重いと感じていました[1]。
そこで登場したのがSPLADEです。投稿者が使ったのはSPLADEで、BM25のようなスパース検索(語の出現で文書を絞る仕組み)に似ていますが、意味も扱います。投稿者はSPLADEを試しました。実験では、SPLADEで密な埋め込みモデルを置き換えられたと報告されています[1]。
この話題は、小モデルの実用性を測るベンチマークとも重なります。GitHubのONNX埋め込みベンチマークは、1B未満のモデルを同じRAGパイプラインで比較し、検索品質と速度のトレードオフを調べています[2]。評価セッションでは3文書と15問を使い、RAGCheckerで採点します[2]。ONNX形式やq4量子化(重みを圧縮してメモリを節約する仕組み)も扱い、対象には22Mや33Mのall-MiniLM、143MのModernBERT-base、572MのQwen3-0.6Bなどが入っています[2]。
ただし、小さければ何でも強いわけではありません。公開重みを持つ11モデルの検索ベンチマークでは、PPLX Embed v1 4BがnDCG@10で0.741、PPLX Embed v1 0.6Bが0.698でした[3]。nDCG@10は、上位10件の並びの良さを示す指標です。4Bは0.6Bよりスコアが高いものの、差は統計的に有意ではなく、Recall@10も90.46%と86.71%で有意差はありませんでした[3]。Recall@10は、正解文書を上位10件にどれだけ含められるかを示す指標です。この評価はBM25を挑発する問題で、BM25は0点でした。通常の検索トラフィックでは未検証です[3]。
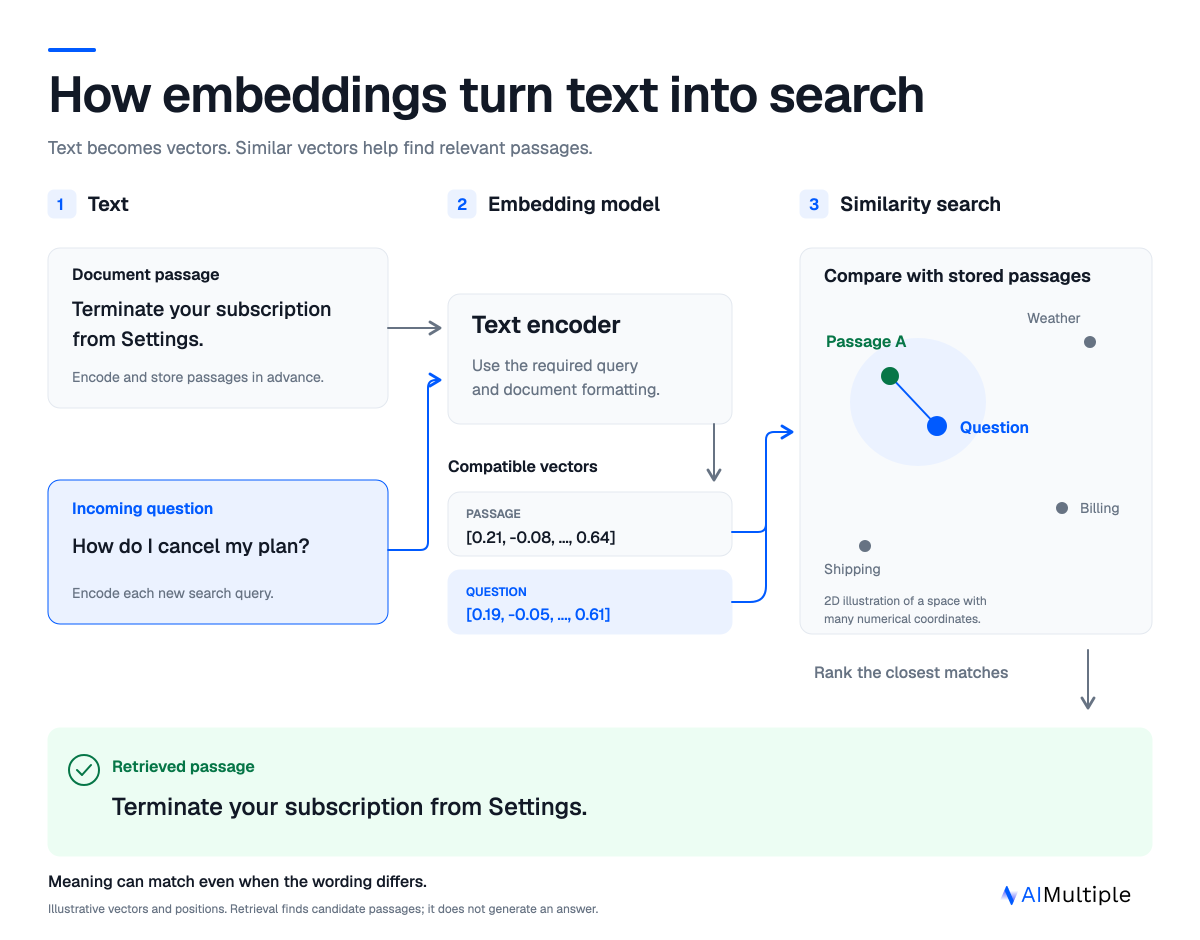
意外なことに、ドメインによって順位も変わります。BGE Largeは金融で0.604、PPLX 4Bは0.596で、差は有意ではありませんでした[3]。医療ではGTE LargeがRecall@10で100%を出し、PPLX 4BのnDCG@10は0.954、GTE Largeは0.894でした[3]。これは正解文書を見つける力と、1位に置く力の差です[3]。なお、この評価は検索指標であり、生成回答の正しさは測っていません[3]。
ローカルRAGの評価では、MTEB(埋め込みモデルの大規模評価)のようなベンチマークやモデル一覧の比較も進んでいます[4][5][8]。2026年の実務向け比較や、335M埋め込みモデルと1Bの小モデルを扱うミニマルRAGの研究も出ています[6][7]。レビューでは、RAGのベクトル検索や出典表示に埋め込みが不可欠だと整理され、訓練データの量と質、合成データ、LLMを基盤として使う動きも挙げられています[4]。
つまり0.1B級の話題は、「巨大モデルを置き換えた」というより、小さなPCで動かせる検索の選択肢を増やした点で意味があります。投稿タイトルは派手ですが、実験は0.6Bの密な埋め込みモデルの代替です[1]。実務では、自分のドメインで検索品質と速度を測り、スパースと密を組み合わせる判断が求められます。
引用ソース
- Reddit Reddit r/LocalLLaMA: A 0.1B model just killed 8B embedding models… I tried it out. — https://www.reddit.com/r/LocalLLaMA/comments/1xpdk0i/a_01b_model_just_killed_8b_embedding_models_i/
A 0.1B model just killed 8B embedding models… I tried it out.
- Web記事 記事全文: GitHub – iam-tsr/onnx-embed-benchmark — https://github.com/iam-tsr/onnx-embed-benchmark
A benchmark suite for comparing ONNX-optimized embedding models under 1B parameters on a small retrieval-augmented generation (RAG) evaluation set.
This project measures how different embedding models behave inside the s - Web記事 記事全文: Open Source Embedding Models: 11 Models Benchmarked for Retrieval — https://aimultiple.com/open-source-embedding-models
Open Source Embedding Models: 11 Models Benchmarked for Retrieval
We benchmarked 11 open-weight embedding models, 200 questions and 341,040 text passages across four corpora. Finance, legal contract, technical support an - Web記事 記事全文: Recent advances in text embedding: A Comprehensive Review of Top … — https://arxiv.org/html/2406.01607v1
Recent advances in text embedding: A Comprehensive Review of Top-Performing Methods on the MTEB Benchmark
Abstract
Text embedding methods have become increasingly popular in both industrial and academic fields due to the - Web記事 記事全文: Models · MTEB Leaderboard — https://leaderboard.mteb.org/models
Every model in the leaderboard with its architecture type, parameter count, embedding
dimension, max context, and release date. Filters here share state with the leaderboard on
every benchmark detail page. - Web記事 Web検索: Which Embedding Model Should You Actually Use in 2026? I Benchmarked 10 … — https://zc277584121.github.io/rag/2026/03/20/embedding-models-benchmark-2026.html
Which Embedding Model Should You Actually Use in 2026? I Benchmarked 10 …
- Web記事 Web検索: Models for minimalist RAG: B1ade 335M Embedding and 1B Parameter Small … — https://arxiv.org/pdf/2607.27506
Models for minimalist RAG: B1ade 335M Embedding and 1B Parameter Small …
- Web記事 Web検索: GitHub – embeddings-benchmark/mteb: MTEB: State-of-the-art evaluation … — https://github.com/embeddings-benchmark/mteb
GitHub – embeddings-benchmark/mteb: MTEB: State-of-the-art evaluation …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS