llama.cppチームのMac/Windows向けアプリが話題です。1MBでOpenAI互換APIや自動設定を提供し、Vulkan最適化やベンチマークも続いています。AIバブルの話題の中で、ローカル推論の実用性が見えてきます。
llama.cppチームのMac/Windows向けアプリが話題です。1MBでOpenAI互換APIや自動設定を提供し、Vulkan最適化やベンチマークも続いています。AIバブルの話題の中で、ローカル推論の実用性が見えてきます。
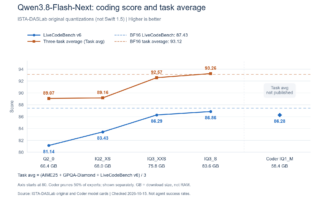
StrataでQwenの小型から大型まで試した結果、VRAMを超える構成でprefillとdecodeが伸びる分岐点が示されました。RTX 3060では35B以上のMoEで最大約2倍、RTX 5060 Tiでは軽い量子化が65.55トークン/秒です。
NVIDIAのBlackwellがMLPerf Training v5.1で全項目で最速を発表しました。H200比ではResNet-50が1.85倍、GPT-1.3Bが1.55倍、電力効率は32%改善しました。FP4と接続仕様からAI推論と学習の変化を解説します。
Qwen3.8 Flash-Nextのローカル推論で、RTX 5080と64GB RAMの構成が話題です。実測はエージェント作業で平均195.6トークン/秒、prefill約5700トークン/秒と報告されました。27Bの推定速度や不満もあり、構成とエンジン次第で評価が分かれています。
2026.11.06
llama.cpp、ローカルAIを1MBアプリに
2026.11.06
続・Strata:Qwenの全サイズで速度の分岐点
2026.11.06
続・NVIDIA:Blackwellが全項目で最速、H200比の実測差
RECENT COMMENTS