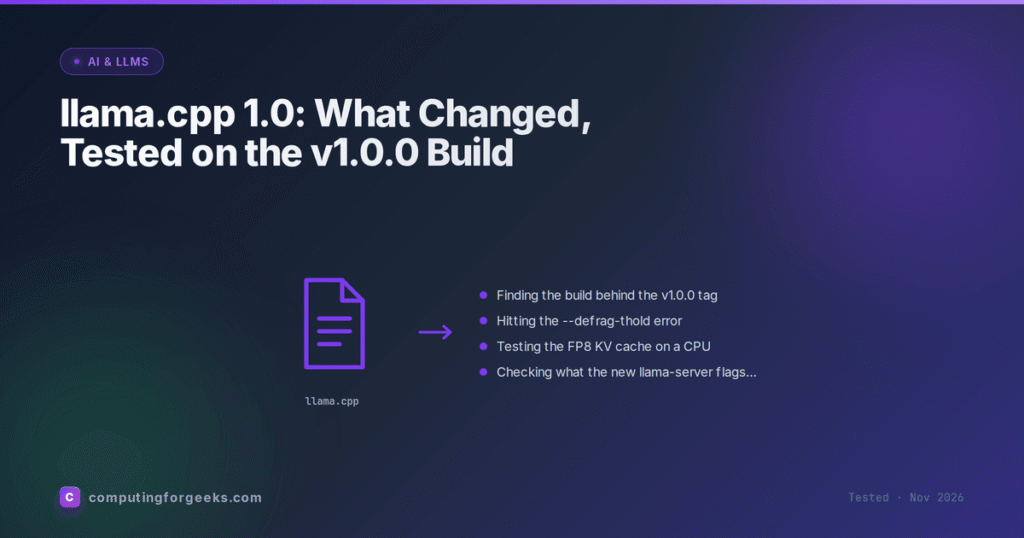
派手なフラッシュより地道な契約の話で、llama.cppがv1.0になり、Hacker NewsではmacOS向けネイティブアプリと安定版のリリースが話題になりました[1]。GitHubのリリースページもHNに上がりました[5]。3年半の発展を経て、今後はmajor・minor・patchで壊れ方を示す方針です[4]。
しかしv1.0は「安全に動く」だけではありません。UbuntuのCPU環境でv0.9.0からv1.0.0へ移した報告では、削除されたフラグ、共有ライブラリの名前(soname)変更、36個のC APIシンボル(呼び出し口)の消失、旧版では警告だけだった設定をllama-serverが拒否するようになった変化が確認されました[2]。最小構成ではlibgomp1が必要で、バージョン表示には-devと出ますが、実体はb12359であることをコミットで確認しました[2]。
これは下流のローカルAIツールにとって重要なサインです。v1.0では公開C APIの非推奨関数35個が削除され、NextNの先読み推論API(次のトークンの生成を速める仕組み)がllama.hへ移りました[6]。ggmlも同時にv1.0へ到達し、推論ライブラリlibllamaとテンソルライブラリlibggmlの両方が1.0になったことがHNコメントで共有されています。関連するggml v1.0.0の話題もHNに上がっています。プロジェクト側は、150以上のモデル構造と主要な先読み推論を支えると説明しています[6]。
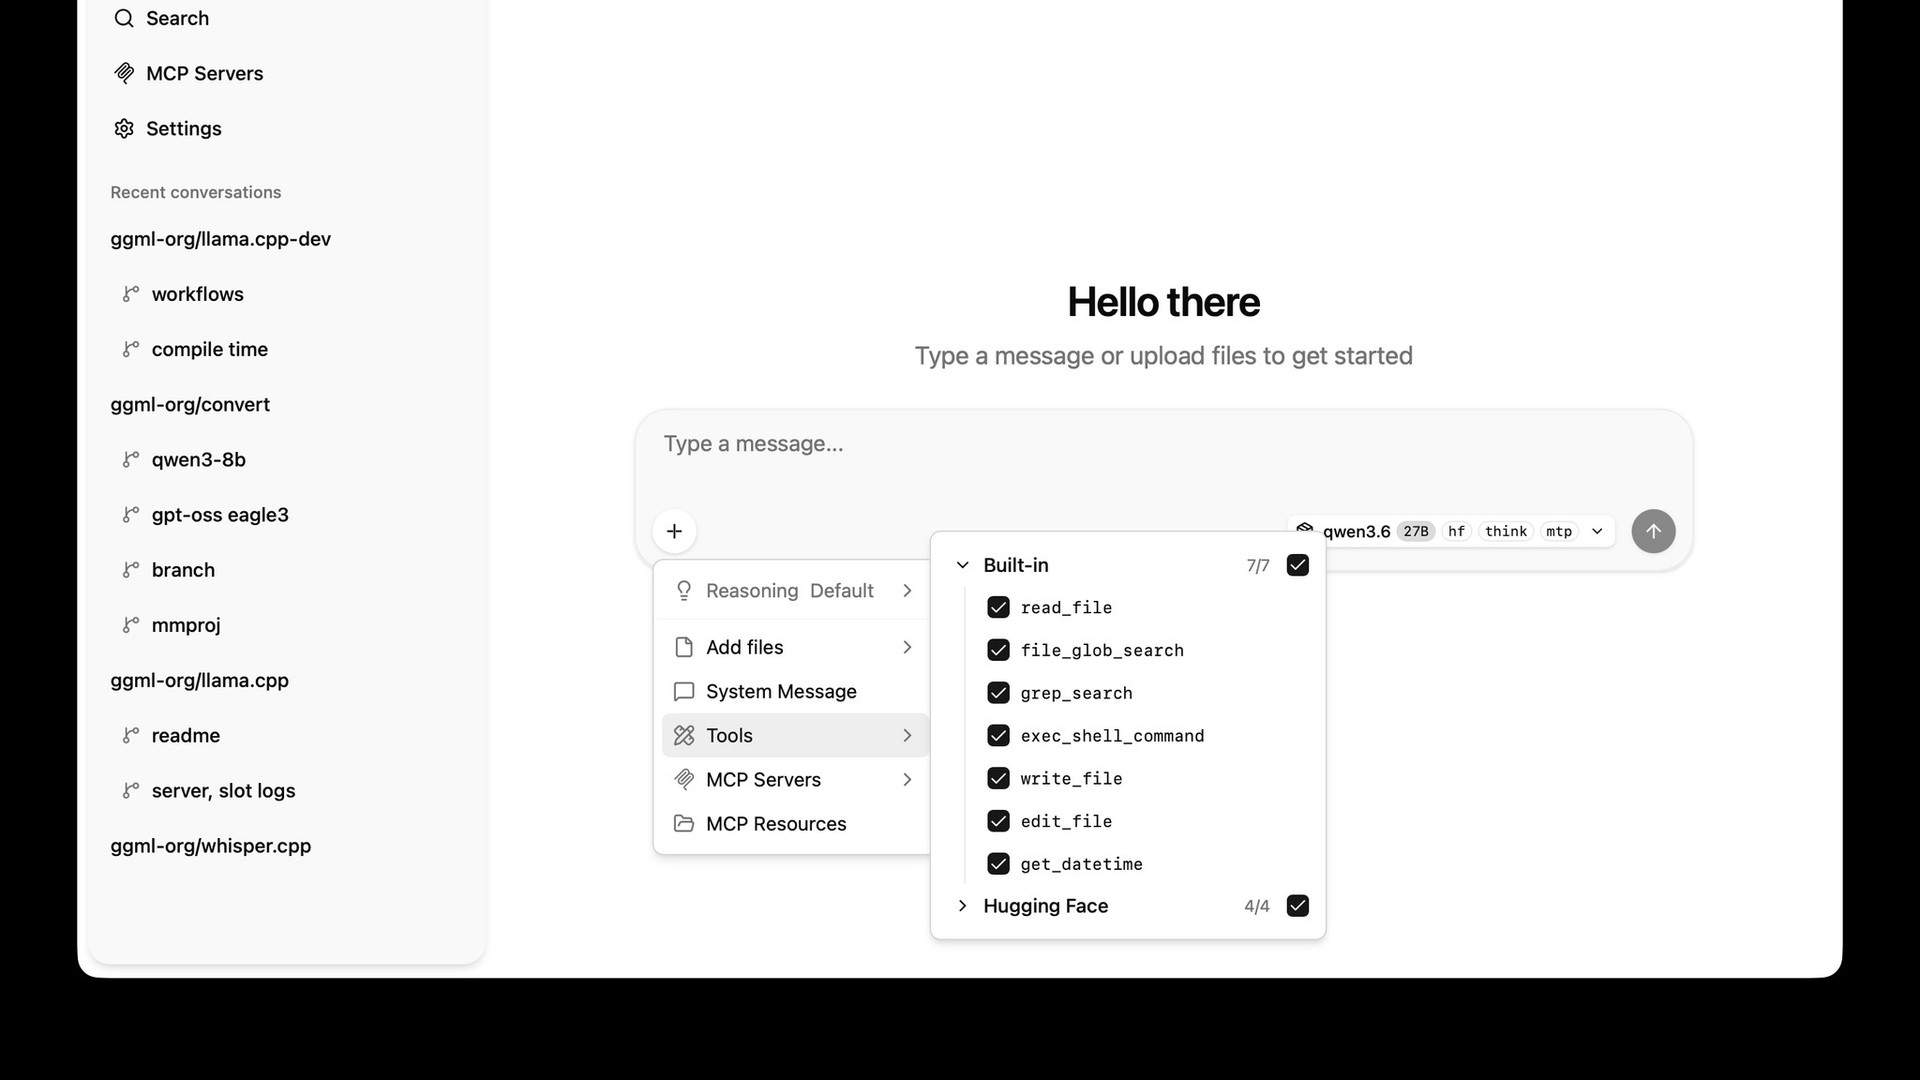
リリースの作り方も癖があります。v1.0.0タグ自体にはバイナリがなく、nightly-tag.txtが指すb12359を辿る必要がありました[2]。公式タグは、内部のggmlが公開ggmlと一致するときにだけ作られるため、DebianやHomebrewのようなパッケージのセットとの相性が考慮されています[6]。各ggmlバックエンドは動的ライブラリとして実行時に読み込めるため、必要な部品だけ後から読み込む構成も柔軟になります[6]。
研究・業務の維持者向けには、バージョンの約束がより明確になりました。majorはソースとバイナリの破壊、minorは追加、patchは修正を示します[7]。依存レビューでは、このバージョンの約束が更新判断の材料になります[7]。ggmlのRPCではプロトコル9で非互換のピアを拒否するため、接続先も確認対象です[7]。
XのトレンドにはAIメカも上がっていましたが、今回の中心はAIメカというより、AI推論の運用契約でした[3]。RTX 3090で最大55%速くなった報告もHNにありましたが[7]、170 tok/sは別構成の参考値です。Qwen3.8の先読み推論の試行や最適化記事も周辺にあり、速度の話よりも、更新で壊れる箇所を先に読むべき段階です。
解説記事では、ローカルAIにセマンティックバージョニングが導入されたと整理されています。安定版への到達を報じる記事もあり、リリース追跡フィードにも載りました。llama.cpp v1.0は、ローカルAIを「動く」から「壊れ方を説明できる」へ進めたリリースです。macOS向けネイティブアプリの話題は入口にすぎず、実務ではAPI削除、サーバーの厳格化、ggmlの同時1.0化をセットで確認したほうが安全です[1][2][6]。
引用ソース
- Hacker News Hacker News: Llama.cpp hits v1.0 with a native app for macOS — https://huggingface.co/blog/ggml-org/llama-cpp-v1
Llama.cpp hits v1.0 with a native app for macOS
- Web記事 記事全文: llama.cpp 1.0: What Changed, Tested on the v1.0.0 Build — https://computingforgeeks.com/llama-cpp-1-0-whats-new/
I moved a CPU box from the previous stable tag to llama.cpp 1.0 the day it was tagged. What broke was a removed flag, a new libllama soname, 36 C API symbols gone, and a llama-server that now refuses setups the old build
- X Xトレンド: AIメカ — https://trends24.in/japan/
AIメカ
- HNコメント HNコメント: ama.cpp hits v1.0 with a native app for macOS — https://news.ycombinator.com/item?id=50492877
The llama.cpp team at HuggingFace announced that the framework has reached a stable version of 1.0, spending 3.5 years in development since its inception. This version will have stabilized APIs and follow semantic versio
- Hacker News Hacker News: llama.cpp v1.0 — https://github.com/ggml-org/llama.cpp/releases/tag/v1.0.0
llama.cpp v1.0
- Web記事 記事全文: Llama.cpp V1.0.0 Sets API Stability Rules for Local AI Tools — https://www.unite.ai/llama-cpp-v1-0-0-sets-api-stability-rules-for-local-ai-tools/
Key PointsMajor-version bumps now publicly signal source and binary breakage for downstream…
View more
– Major-version bumps now publicly signal source and binary breakage for downstream llama.cpp integrators.
– Official - Hacker News Hacker News: Llama.cpp v1.0 on an RTX 3090: up to 55% faster with speculative decoding — https://homebrewserver.club/llama-cpp-v1.html
Llama.cpp v1.0 on an RTX 3090: up to 55% faster with speculative decoding
- Web記事 記事全文: llama.cpp and ggml 1.0: API version boundaries — CASRAI — https://casrai.org/news/llama-cpp-ggml-1-0-stable-api-release-2026
ggml-org released version 1.0.0 of llama.cpp and ggml on November 13, 2026, pairing the library releases with a commitment to mark API and ABI incompatibilities through major-version changes. For university research soft
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS