📌 エグゼクティブサマリー
llama.cppがCohereのMoE向け専用パーサを追加し、North Mini Codeの30B総パラメータ・3Bアクティブや256Kコンテキストをローカルで狙えるようになりました。VisionエンコーダやTINY_AYA語彙対応も進み、実測TPSは素材に見当たりません。続報として追跡します。
「動かない」が、ようやく「動く」に変わりました。aiの話題として、Cohereモデルがllama.cppで動くようになりました。以前はローカル推論への入口が狭く、hacker的な試行錯誤が求められていました。flashのように速いとは断定できませんが、壁を越える一歩です。Cohere側も、このコミュニティの要望を強く受け止めていたようです。
CohereのNickさんはRedditで、llama.cpp対応を望む声に応えたと報告しました。Command A+やNorth Mini Codeのベータで得たフィードバックが、モデルと提供方法の改善に役立ったと述べています。North Micro Vision Instructのビジョンエンコーダが統合されました。ビジョンエンコーダは、視覚情報を読み込む部品です。最新アーキテクチャがllama.cppで使えるようになったと説明されています。LLM部分はNorth Mini CodeやCommand A+と同じ構成で、すでに支えられていた点も重要です。[1] North Micro Visionは、いくつかの新リリースの基盤として使われているとも書かれています。コミュニティからの要望が、実装の優先順位を変えたようです。約束を果たすまで投稿を控えていた、という姿勢も伝わります。
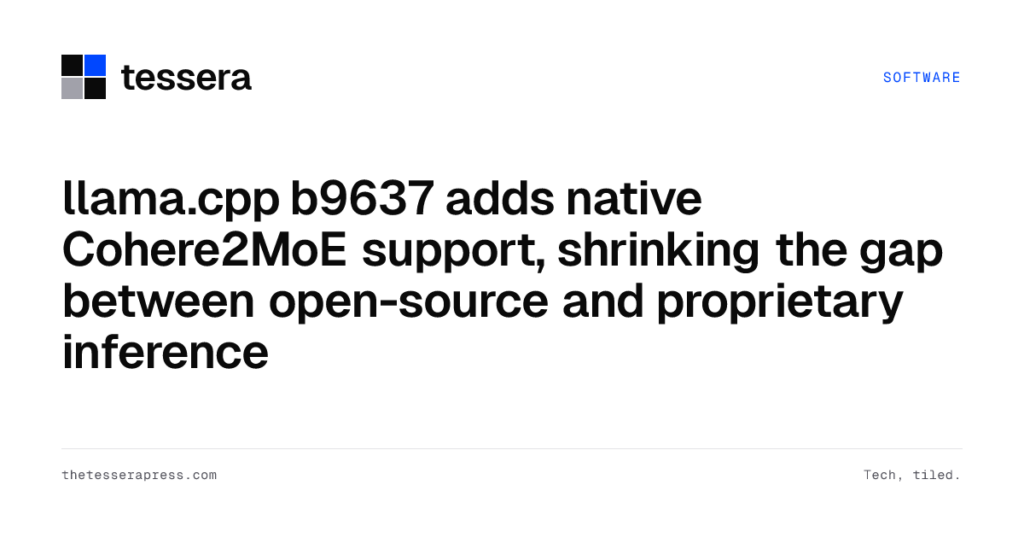
技術の中心は、Cohere2MoE向けの専用パーサです。パーサは、モデルの形を読み解く部品です。llama.cppのb9637で、North Codeとも呼ばれるCohere2MoEの解析が追加されました。Pull request #24615でマージされた、狭い修正です。しかしこの狭さが重要で、従来の汎用MoEパーサではCohereの形に合わなかったと説明されています。[2] リリースノートは短く、コミットメッセージも軽い口調です。それでも効果は構造的だと記事は指摘します。狭い修正は、大きな壁を小さく削る方法です。
何が違うのかを見ていきます。Mixtral型のMoEでは、8つの専門家から2つを選ぶtop-kが想定されていました。top-kは、上位の専門家を選ぶ方式です。Cohereは学習したゲート機構を使い、専門家数も違う構成です。そのため、Cohereの重みを読み込むと、静かな失敗、性能低下、クラッシュが起きていたと報告されています。[2] 翻訳層を挟まない形で処理できるようになり、読み込みの形そのものが整いました。ここでいうMoEは、複数の専門家ネットワークから一部を選ぶ仕組みです。
対応モデルの数値も目立ちます。North Mini Codeは総パラメータ30B、アクティブ3BのMoEです。アクティブとは、実際に動くパラメータの量です。コンテキストは256K、最大出力は64Kとされています。コンテキストは、一度に扱える文章の長さです。開発者は再コンパイルし、量子化されたGGUF重みを試すよう案内されています。GGUFは、llama.cpp向けの重みファイル形式です。量子化とは、モデルを圧縮してメモリを節約する仕組みです。[3] このセットで、エージェント型コーディングをローカルで狙う構想が見えます。標準的なハードウェアで、APIに頼らず動かすことが目的です。256Kという長い文脈は、コードベース全体を扱う場面で魅力です。
周辺も動いています。検索結果では、b9626でCohere2MoEのネイティブアーキテクチャ対応が示され、b9637でパーサ統合が追跡されています。[4][5] これらのバージョンの差は、段階的な統合を示しています。cohere2-MoEの概要記事も複数あり、TINY_AYAの語彙対応も確認できます。[6] llama.cpp support for Cohere modelsというまとめ記事も出ています。[7] 語彙対応は、トークン化のズレを減らす地味ですが重要な一歩です。
CohereはAPIも提供しますが、重みはpermissive(比較的緩い)ライセンスで公開されています。North CodeはDeepSeek CoderやCode Llamaと競う開発者向けコーディング助手として紹介されています。b9637以前は、パッチや劣化の受け入れが必要でした。[2] つまり今回の対応は、単なる追加ではなく、ローカル利用の前提条件を変える修正です。開発者向けモデルが、llama.cppの定番経路に乗るかどうかの分岐点になります。ローカル化の流れとして、検索結果にも現れています。API専用ではなく、重みを自分で動かせる点が狙いに見えます。
ただし、速さの証拠はまだ薄いです。素材にTPSや消費電力の実測値は見当たりませんでした。TPSは、毎秒いくつの語を生成できるかの目安です。Apple Silicon、Intel、ROCm、Vulkan、OpenVINO、SYCL、CUDAなど22プラットフォーム向けバイナリは出ていますが、プラットフォーム別の比較数値はありません。[2] UbuntuのROCm 7.2、WindowsのCUDA 12と13も含まれています。KleidiAI対応ビルドの話題もありますが、性能差を示す数値は素材に見当たりません。つまり「動く」ことと「速い」ことは、まだ別の話です。
それでも、この続報の意味は小さくありません。Cohereのモデルが、llama.cppの標準的な流れに乗る段階に入りました。ビジョン、MoE、語彙対応が少しずつ揃い、ローカル推論の選択肢が広がります。hacker的な試行錯誤は、次のベンチマークと安定版のセットで測られるべきでしょう。aiの現場では、動くこと自体が文化を作ります。追跡では、セットアップの再現性も注目されます。次の追跡では、実測値と失敗報告が主役になりそうです。
引用ソース
- [1] Reddit Reddit r/LocalLLaMA: llama.cpp support for Cohere models — https://www.reddit.com/r/LocalLLaMA/comments/1xa0cyz/llamacpp_support_for_cohere_models/
llama.cpp support for Cohere models
- [2] Web記事 記事全文: llama.cpp b9637 adds native Cohere2MoE support, shrinking the gap … — https://thetesserapress.com/articles/ggerganovllamacpp-b9637
The latest release of llama.cpp, tagged b9637, ships a dedicated parser for Cohere2MoE models, also known as North Code. The change, merged in pull request #24615, is a narrow technical fix. It adds a specialized code pa
- [3] Web記事 記事全文: llama.cpp Adds Support for Cohere's cohere2-MoE Architecture — https://tools4all.ai/trends/llamacpp-adds-support-for-coheres-cohere2-moe-architecture
TL;DR: Llama.cpp has added architectural support for cohere2-MoE, enabling developers to run Cohere’s new North Mini Code 30B MoE model locally with high efficiency.
Summary: A new pull request in llama.cpp introduces ar - [4] Web記事 Web検索: Llama.cpp Release b9637: Cohere2MoE Parser Integration and the Push for … — https://pseedr.com/edge/llamacpp-release-b9637-cohere2moe-parser-integration-and-the-push-for-localized-
Llama.cpp Release b9637: Cohere2MoE Parser Integration and the Push for …
- [5] Web記事 Web検索: llama.cpp Release b9626 Integrates Native Architecture Support for … — https://pseedr.com/stack/llamacpp-release-b9626-integrates-native-architecture-support-for-cohere2-moe
llama.cpp Release b9626 Integrates Native Architecture Support for …
- [6] Web記事 Web検索: Llama.cpp update adds Cohere2MoE vocabulary support for TINY_AYA — https://tools4all.ai/trends/llamacpp-update-adds-cohere2moe-vocabulary-support-for-tiny-aya
Llama.cpp update adds Cohere2MoE vocabulary support for TINY_AYA
- [7] Web記事 Web検索: llama.cpp support for Cohere models – bittide.aicompass.dev — https://bittide.aicompass.dev/article/9caf2afb-f83a-4997-a222-ee129a92d6d7
llama.cpp support for Cohere models – bittide.aicompass.dev
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS