AIエージェントを一度動かすのは、もう簡単な時代になりました。本当に難しいのは、失敗したあとにどう立ち直らせるかです。ハッカーニュースでは「gVisorでエージェントをサンドボックス化し、テックリードを演じる」という投稿が話題となりました[2]。日本のXでも「AI事業」という語がトレンドに浮上してい […]
AIエージェントを一度動かすのは、もう簡単な時代になりました。本当に難しいのは、失敗したあとにどう立ち直らせるかです。ハッカーニュースでは「gVisorでエージェントをサンドボックス化し、テックリードを演じる」という投稿が話題となりました[2]。日本のXでも「AI事業」という語がトレンドに浮上してい […]
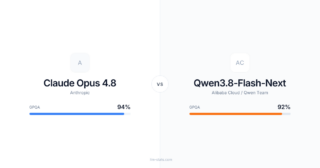
ローカルで動くモデルは、最上位のAPIモデルにどこまで迫れるのか。その一つの答えが、Redditのr/LocalLLaMAに投稿された検証です[1]。同じコーディングタスクを両者に解かせたところ、費用は0.32ドル対17.78ドル。約55倍の差がつきました。それでいて完成度は69%対87%。この数字 […]
🔁 前回の続き: 続:Qwen3.8 27Bの推論設定と速度のその後 📌 エグゼクティブサマリーai(AI)開発者の間で、Qwen3.8 27Bの低量子化をSSD推論で補う試しが話題です。MMLU-Proの精度回復と、4k超で速度ペナルティなしが示されました。推論設定と量子化の最新動向を整理します。 […]
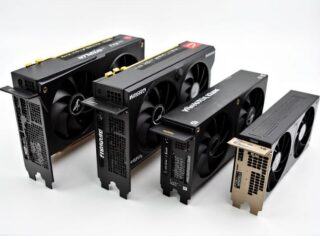
📌 エグゼクティブサマリーNVIDIAのRTX 50系は32Bモデルで最大213 tokens/secと速いが、70B超はVRAM不足が壁です。aiのローカル推論ではメモリ帯域とCUDA代替、中国製チップの動向が中心で、実測の差が読み取れます。買い替え判断も変わります。 「速い」だけでは足りない。a […]
🔁 前回の続き: llama.cppがCohere対応を進めた 📌 エグゼクティブサマリーllama.cppのCohere対応が、LLMから視覚エンコーダへ進みました。North Mini Codeは総30B、アクティブ3B、256Kコンテキストが示されていますが、実測TPSや電力は素材にありません […]
🔁 前回の続き: 続・Dots、中間公開と音声合成で変わるローカル推論 📌 エグゼクティブサマリーAI音声合成dots.ttsは2Bパラメータで、Seed-TTS-EvalのWERや初音遅延85/54msなど具体的な数値を示しました。音声編集やSGLang Omniの制約も追跡し、ローカル推論への影 […]
🔁 前回の続き: llama.cppがCohereモデルをローカル推論へ 📌 エグゼクティブサマリーllama.cppがCohereのMoE向け専用パーサを追加し、North Mini Codeの30B総パラメータ・3Bアクティブや256Kコンテキストをローカルで狙えるようになりました。Vision […]
🔁 前回の続き: llama.cpp MoE、複数専門家とキャッシュの追跡 📌 エグゼクティブサマリーllama.cppのMoEでは、専門家を実行メモリからCPUへ逃がす仕組みが注目されています。LLaMA-MoEは動いているパラメータを3.0〜3.5Bに抑え、専用フレームワークはllama-ser […]
🔁 前回の続き: llama.cppがCohere対応を進めた 📌 エグゼクティブサマリーllama.cppがCohereのcohere2-MoEをb9626/b9637で対応し、North Mini Code 30Bのローカル推論に近づきました。実測値は素材にありませんが、対応の進み方が見えます。 […]
🔁 前回の続き: llama.cppがCohere対応を進めた 📌 エグゼクティブサマリーCohereがllama.cpp対応を進め、North Micro Visionの視覚エンコーダやcohere2-MoEが対応に。30B総パラメータで3Bアクティブ、256Kコンテキストなど数値が示され、aiの […]
RECENT COMMENTS