30BクラスのMoEモデルが、16GBのGPUで動く。そんな工夫がローカルAI推論の定番ツール・llama.cppで現実のものになっています。しかも今は、専門家の重みをディスクから“流し込む”方式まで登場しました[2]。VRAM節約の設定は以前もお伝えしましたが、今回はその先の話です。
MoE(Mixture of Experts)は、トークンごとに一部の「専門家」ネットワークだけを動かす仕組みです。ローカルで動かす魅力はここにあります。重みは巨大でも、同時に動く部分は小さくて済むからです。例えばQwen3-Coderの30Bモデルは、一度に活性化するのはわずか3Bです[2]。ところがllama.cppは、使わない専門家も含めて全重みをどこかに置く必要があります。16GBや24GBの環境では、この「置き場所」こそが最大の壁でした[2]。
現時点で使えるのが–n-cpu-moeというオプションです。数値Nを指定すると、最初のN層分のMoEエキスパート重みをVRAMではなくシステムRAMに置きます[2]。Nを大きくすればVRAMは節約できる代わりにCPUの仕事が増え、小さくすれば専門家がGPUに残って生成が速くなります。解説記事[2]はこれを「ノブであって最適化ではない」と表現します。層ごとに速度と余裕を交換する、調整の道具だというわけです。
効果は具体的です。attention(トークン間の関係を見る処理)と、トークンごとの活性計算はGPUに残します。その一方で専門家重みの一部をシステムRAMへ逃がす。これだけで30BクラスのMoEが16GBカードでロードできるようになります[2]。専門家の全量をVRAMに載せられない環境では、この値の探り方がそのまま実力を左右します。ただし代償はトークン/秒に直接現れます。適切なNとは「OOM(メモリ不足によるロード失敗)で落ちないギリギリの値」であり、それより小さな値ではない、と記事は強調します[2]。
ここからが新しい動きです。専門家を事前にRAMへ載せず、ディスクから必要な分だけ読む「ストリーミング」。機能要望に加え、独立した実装だけでも少なくとも5つが存在します[2]。事前ロードしないぶん、VRAMもRAMも専門家の全量を抱えなくて済むはずです。鍵はタイミングです。専門家を選ぶ「ルーター」(振り分け役)は、必要な先を早めに算出できます。その判定が、現在の層のattention計算が終わる前に済むのです。この隙間が先回り読み込み(プリフェッチ)の窓になり、次の層の専門家を計算中にディスクから取得できます。あるプロジェクトの議論では、全量を事前ロードする方式比で約2倍のスループット向上が引用されています[2]。
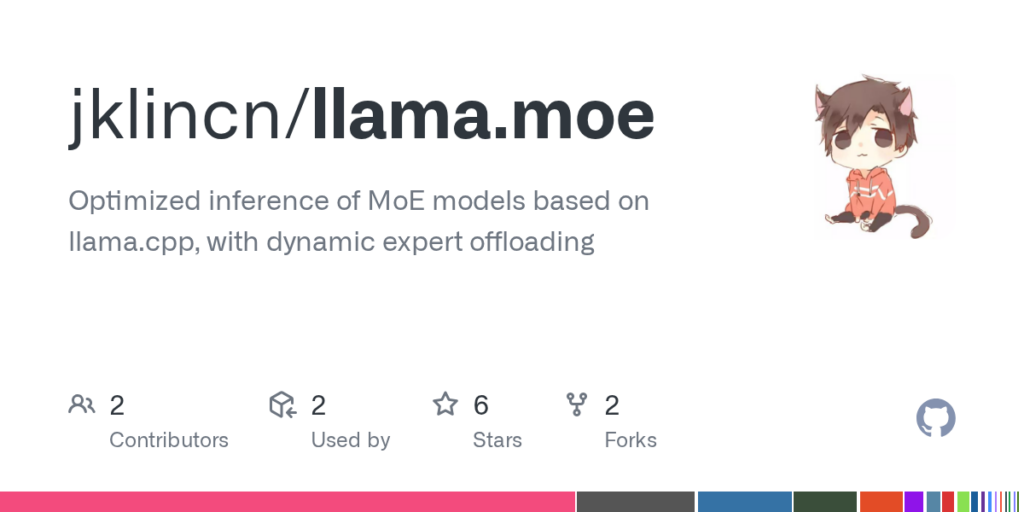
個別の試みも進んでいます。Hacker Newsには「BigMoeOnEdge」というShow HN(Hacker Newsの作品紹介投稿)が現れました。llama.cppの上に層を重ね、スマホとノートPCで大型MoEのストリーミングを可能にする、という内容です[1]。手元の小さな機器で大型モデルを流す発想です。GitHubではjklincn氏のllama.moe(zilong)も公開されています。llama.cppベースに動的な専門家オフロードを組み込んだ軽量推論フレームワークで、ビルドにはCUDA環境が必要です[4]。使い方はllama-serverと同じで、コマンドをzilongに置き換えるだけ。セットアップの手間が小さい点は、試しやすさにつながりそうです。
一方で、この流れはまだ初期段階です。ストリーミングは本家llama.cppに取り込まれた機能ではなく、機能要望と複数の独立実装が並走する状態にとどまります[2]。約2倍という数値も、ある一つのプロジェクトの議論から引用されたものです。複数の環境で結果がそろうまでは、楽観しすぎないほうがよさそうです。Hacker Newsでの反応も小さく、BigMoeOnEdgeの投稿は1ポイント・コメント0件でした[1]。複数専門家の活性化をめぐる別の議論も、同様に静かな出足です[3]。実装が乱立する今、どの方式が速くて安定するのか。共有された答えはまだないようです。
そんな中、知見をまとまった形にした資料も増えています。Hugging FaceブログにはGPU支援つきのローカルMoE・CPU推論ガイドが投稿され[6]、VRAMを節約してより大きなモデルを動かすガイド[5]、大規模MoEの推論性能を最適化するガイド[8]も公開されました。llama.cppのフォーク(派生版)を対象にしたMoEアーキテクチャの解説も整備されています[7]。実装競争の裏で、置き場所と速度の設計ノウハウが少しずつ共有され始めたようです。
MoEのローカル推論では、もはや「全部VRAMに載せるか諦めるか」の二択ではありません。層ごと、専門家ごとに置き場所を設計する段階に入っています。–n-cpu-moeが16GB環境の扉を開き、ストリーミングが実用化すればディスク速度まで含めた総合設計が問われるでしょう[2]。5つ以上の実装が競う状態から、どれが本家に凝集されるか。それが次の節目になると考えられます。スマホやノートPCまで視野に入った今、「家で動くモデルの上限」は、まだソフト側の工夫で伸びそうです。
RECENT COMMENTS