30B級のMoEモデルが、16GBのGPUで動くようになっています。さらに、エキスパート(専門家ネットワーク)を事前にメモリへ載せない方向まで進んできました。ローカル推論の定番llama.cppを巡るMoE最適化は、いま「オフロード(GPUに載らない重みをCPU側へ移す方式)」から「ストリーミング」へ一歩進もうとしています。Hacker Newsでは、拡張「BigMoeOnEdge」がShow HNとして投稿されました[1]。スマホとラップトップで、大きなMoEモデルをストリーミング実行する試みです。大きなモデルを小さな端末で動かす挑戦が、手法のレベルで語られ始めています。
まず前提を整理します。MoE(混合専門家)モデルは、トークンごとに多数の専門家ネットワークのうち一部だけを動かす仕組みです。ローカルで動かす魅力は、トークンごとに動くパラメータが全体のごく一部で済む点にあります[2]。詳解記事[2]によれば、Qwen3-Coderの30Bモデルは、同時に動くのは3Bだけです。ところがllama.cppは、動いていない専門家も含めて全重みをどこかに保持しなければなりません。16GBや24GBの環境では、この「置き場所」が最初の壁になります[2]。
現時点で使える指定があります。専門家の重みの一部を、GPUメモリ(VRAM)ではなくシステムRAMに移すものです。先頭のN層分をRAMに置く–n-cpu-moeがそれに当たります[2]。Nを増やせばVRAMは節約できる代わりに、トークンごとのCPU仕事が増えます。減らせば生成は速くなるものの、メモリは逼迫します。記事はこれを「最適化ではなくノブだ」と表現します。速度と余裕を層単位で交換していく調整です。30B級が16GBカードで破綻せずに動くのは、この仕組みのおかげです。attention(関連する部分に注目する計算)とトークンごとの計算はGPUに残し、専門家の重みの一部だけをRAMへ逃がします[2]。
ここからが今回の追跡ポイントです。専門家をRAMにすら事前ロードせず、ディスクから必要な分だけ流し込む「ストリーミング」方式です。この実装は、執筆時点で少なくとも5通り、コミュニティで独立に進んでいます[2]。鍵は時間差の作り方です。ルーターは、どの専門家を使うかを選ぶ部分です。この部分は、現在の層のattention計算が終わる前に、次の層で必要な専門家を先に判定できます。この隙間が先読み(プリフェッチ)の窓になります。現在の層を計算している裏で、次の層の専門家をディスクから取得すれば、読み書きと計算を重ねられます。あるプロジェクトの議論では、概ね2倍のスループット向上が見込めると報告されています[2]。スループットは、単位時間あたりの処理量です。RAMに事前ロードしない以上、RAM容量の壁も一段緩む可能性があります。
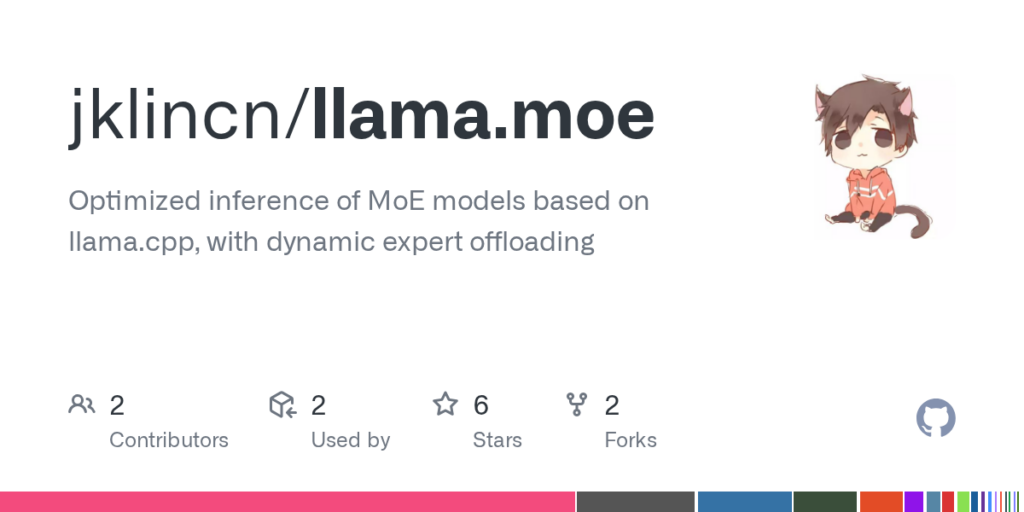
実装の姿も具体的になってきました。llama.cppの上に動的な専門家オフロードを載せた軽量フレームワークが「llama.moe」です。実行体はzilongという名前です。CUDA(GPU向けの開発環境)前提のビルドスクリプトが用意されています。llama-serverをzilongに置き換えるだけで、同じ使い方ができるのが特徴です。セットアップ手順や実行例スクリプトも公開されています[5]。Web検索でも同リポジトリが複数ヒットします。周辺資料も増えています。トークン生成の性能Tipsをまとめたllama.cpp-moe-streaming-coreのドキュメント[6]、llama.cpp内部のMoE構造を解説したDeepWikiのページ[7]、大規模MoEモデルの推論性能を最適化するガイド[8]などが見つかります。
一方で、期待だけでは語れない側面もあります。RAMへ逃がす指定は、Nを上げるほど生成速度(tokens/sec)が直接落ちるトレードオフです。実質的な正解は「モデルがOOM(メモリ不足)で落ちないぎりぎりに迫った値」です。それより下の値ではありません[2]。快適さを探る作業というより、限界との交渉です。ストリーミング方式も、2倍という数字はあくまで一プロジェクトの議論からの報告です。llama.cpp本体ではまだ、機能要望がオープンになっている段階です[2]。Hacker Newsでの反応も静かです。今回確認した2件の投稿は、いずれも1ポイント・コメント0件にとどまっています[1][4]。注目の方向性ではあっても、定番手法になるには時間が必要です。
また、専門家の数え方を変える試みも話題の種です。「llama.cppがMoEで複数の専門家を活性化できるようにしたら」という議論が投稿されています[4]。Hugging Faceには、専門家の活性化(アクティベーション)を設定・管理する方法を解説したDavidAUのガイドもあります。ただし、活性化の数や選び方を変えた場合の品質への影響までの検証は、素材からは読み取れません。なお日本のXでは「AI事業」という語がトレンドに上がっていました[3]。トレンド語だけでは中身は分かりませんが、ローカル推論への関心の広がりと並ぶ動きとして記しておきます。
まとめると、llama.cppのMoE運用は少しずつ変わろうとしています。VRAMに載る分だけ削って載せる方式から、載らない分をディスクと時間差で賄う方式への転換です。今日すぐ試せるのはRAMへの逃がし指定で、先読みの時間差設計が次の本丸です。まずは手元のVRAMとRAMの配分を確かめ、ストリーミング系実装の動向を追うのが現実的な一歩です。小型端末での大モデル実行が、手法のレベルで現実味を帯びてきた一段階といえます。



RECENT COMMENTS