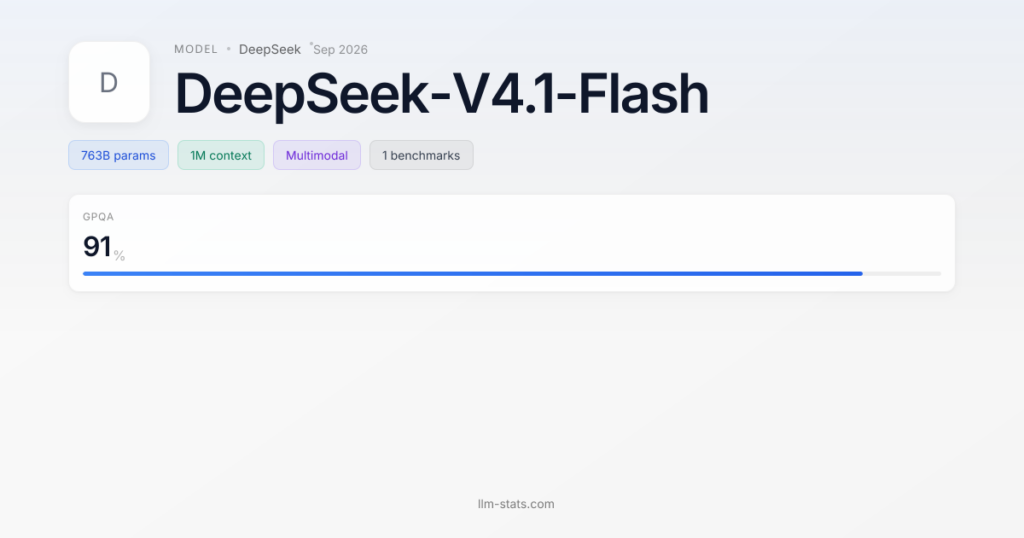
「Flash」の名を持つモデルが、自社の最上位モデルを引退させる——DeepSeek-V4.1-Flashをめぐる異例の展開が注目を集めています。DeepSeekは同モデルの公開とともに、フラッグシップだったDeepSeek-V4-Proの段階的廃止を発表しました[2]。前回記事では、Redditに投稿された748Bモデルを2千ユーロのPCで動かす実験を追いました[1]。今回はその後、公式が明かした設計と料金の内側を掘り下げます。
公式情報によると、V4.1-Flashは552BパラメータのMoEモデルです[2]。MoEは、大きなモデルの中から質問に応じて必要な一部だけを動かし、計算量を減らす構造です。新しいのは「Causal Encoder-Decoder」と呼ぶ構造で、入力を読む側と出力を書く側を分けています。入力の処理には8B、出力の生成には16Bだけを活性化する非対称設計です[2]。新方式の事前学習と大規模な強化学習(報酬をもとに振る舞いを改善する訓練)により、V4-Proを含むフラッグシップのベンチマークを上回ったと公式は説明します[2]。画像を理解するマルチモーダル対応も標準で備えました[2]。
料金に直結するのがKVキャッシュの削減です。KVキャッシュは、会話の履歴を保持して推論を速くするためのメモリ領域です。V4.1-Flashでは前世代比で、GPUメモリ(HBM)の使用は4分の1、SSDへの保存は8分の1になりました[2]。エージェント用途では、この履歴の再利用(キャッシュヒット)にかかる費用がコストの大きな割合を占めます。だからこそ圧縮がそのまま料金の削減になる、というのが公式の説明です[2]。
実際の単価を見てみます。提供元は3社が確認されており[4]、そのひとつFireworks経由では入力100万トークンあたり0.22ドル、出力は0.66ドルです[4]。キャッシュ済みの入力は0.0070ドルと、通常の約30分の1になります[4]。DeepSeek APIではオフピーク料金がピークの50%になる仕組みも続き、新しい料金は2026年9月10日04:00(UTC)に効力を持ちます[2]。モデル情報サイトのllm-statsによれば、総パラメータは763.2Bで、MITライセンスにより商用利用も可能です[4]。
一方で、巨大モデルを手元で動かす難しさは変わっていません。前回記事で取り上げた2千ユーロPCの実行について、投稿者がその後、技術詳細を明かしました。構成はRTX 3090(24GB)と128GBメモリです。量子化(重みを圧縮してメモリを節約する仕組み)は最小の1bitでも、ディスク上は233GBになります[1]。ポイントは、モデルが参照する110GBの「Engram table」の扱いです。このデータは最初から読み込まず、NVMe(高速SSD)に置いたまま、必要な行だけを随時読み出します[1]。llama.cppの開発版ビルドを用いた結果、速度は7.2 tok/sでした[1]。ただし出力には物理法則に関する誤りがあり、投稿者自身が「実用的な使い道はあまり見えない」と認めています[1]。同じ構成ではQwenモデルのほうがよく働くという指摘もあります[1]。
さらに、既存ユーザーへの影響も見過ごせません。2026年9月14日04:00(UTC)以降、deepseek-v4-proへのリクエストはV4.1-Flashの料金でV4.1-Flashへ振り替えられます[2]。旧モデルのV4-Flash系も、互換用の名前が一時的にV4.1-Flashへ接続されます[2]。こうした中、必要なGPUやメモリ、SSD容量を解説する記事がyottalabsやkingy.aiなど複数のサイトで公開されています[5][5][5]。公式も2000基のGPUとストレージクラスタを組み合わせた大規模展開を検討していると述べており[2]、自前運用の要件への関心の高さがうかがえます。なお、同時期のX(旧Twitter)日本のトレンドには「OpenAIのAI」[3]や「ClaudeDuet」が並んでおり、AI各社の動きへの関心が高い時期です。
まとめると、V4.1-Flashは「小さなモデルが最上位を置き換える」路線をはっきり示した事例です。入出力で活性パラメータを変える非対称設計とKVキャッシュの大幅圧縮が、性能とコストの両立を支えています[2]。API単価は下がり、MITライセンスでローカル挑戦の余地も残ります[4]。ただし手元のPCでは実用速度に届かず、本格運用はまだサーバー側の話のようです。Flashの名が示す「速くて安い」方向性が、次のV4.1-Proまでどう続くかが注目点になります。
RECENT COMMENTS