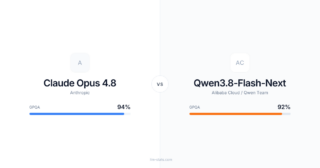
ローカルで動くモデルは、最上位のAPIモデルにどこまで迫れるのか。その一つの答えが、Redditのr/LocalLLaMAに投稿された検証です[1]。同じコーディングタスクを両者に解かせたところ、費用は0.32ドル対17.78ドル。約55倍の差がつきました。それでいて完成度は69%対87%。この数字 […]
ローカルで動くモデルは、最上位のAPIモデルにどこまで迫れるのか。その一つの答えが、Redditのr/LocalLLaMAに投稿された検証です[1]。同じコーディングタスクを両者に解かせたところ、費用は0.32ドル対17.78ドル。約55倍の差がつきました。それでいて完成度は69%対87%。この数字 […]
🔁 前回の続き: 続:Qwen3.8 27Bの推論設定と速度のその後 📌 エグゼクティブサマリーQwen3.8 Flash Nextは、ai推論で速度と精度の両立が話題です。hacker newsでのローカル報告では27Bが2枚のTesla p100sで約60tok/s、ベンチでは53tok/sです […]
🔁 前回の続き: 続:Qwen3.8 27Bの量子化とローカル推論の最新追跡 📌 エグゼクティブサマリーQwen3.8-Flash-Nextで、DFlash2が同時実行1でMTPより約20%速い報告や、53tok/s・262Kの公開値が話題です。英語限定の量子化版では多言語が犠牲になります。速度と能 […]
RECENT COMMENTS