📌 エグゼクティブサマリー
llama.cppのMoEオフロードをめぐり、8GBノートGPUで35Bモデルを動かした実験や、スマホで大型MoEをストリーミングする新プロジェクトが登場しました。エキスパート層をRAMへ退避させる手法の解説が増える一方、スマホ向けは注目が限定的で、実測速度の報告もまだ見当たりません。
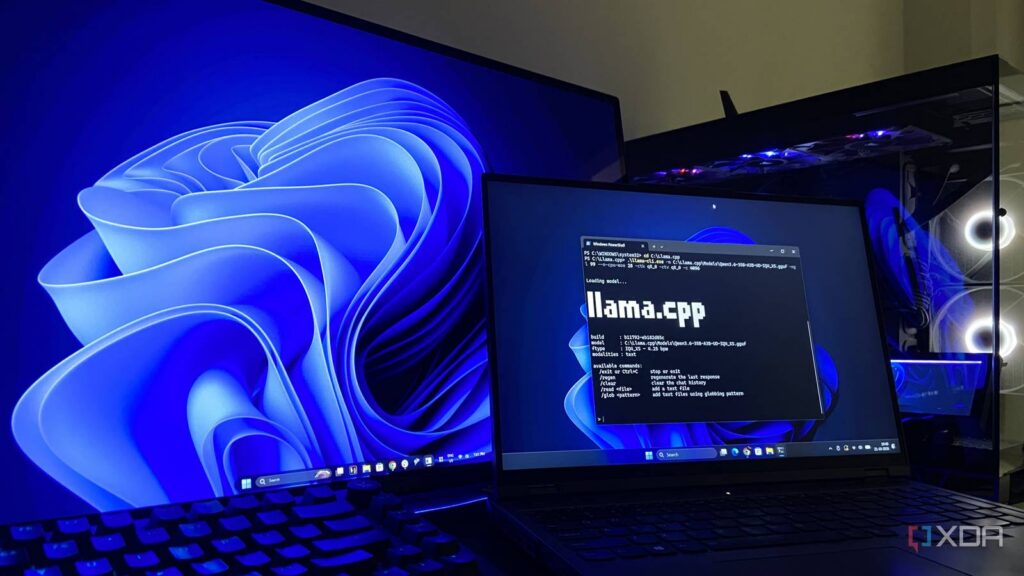
「VRAMが8GBのノートPCでは、35Bモデルは無理」——そう思い込んでいた機材が、設定を1つ変えるだけで動いたという実験報告が出てきました。XDA Developersが、llama.cppのMoEオフロード(エキスパート層をメインメモリ側へ逃がす手法)をノートPCで試した記事です[2]。またHacker Newsには、BigMoeOnEdgeというプロジェクトが投稿されました[1]。llama.cppの上に層を追加し、スマホとノートPCで大型MoEをストリーミングできるようにする試みです。エキスパート層をGPUの外に置く発想が、デスクトップからノート、さらにスマホへと広がりを見せています。
まずノートPCでの実験から見ていきます。XDAのライターは、8GBのRTX 3070 Mobileを搭載したLenovo Legion 5を使いました。この機材について著者は、16GBのRTX 4070 Ti Superで動かしているモデルの一部は「最初から対象外」と決めつけていたと明かしています[2]。試したのはQwen3.6-35B-A3Bです。量子化(重みを圧縮してメモリを節約する仕組み)はIQ4_XSで、コンテキスト長は32Kという構成になります。モデルファイルは17.7GBあり、単純計算では8GBのVRAMに到底収まりません[2]。著者はその前週、ローカルAIの実行環境をOllamaからllama.cppへ移した経緯も記事にしていました[2]。
それでも動く理由は、MoEという構造の特性にあります。このモデルは35Bのパラメータを持ちながら、推論時に実際に動くのは約3Bだけで、残りは待機しています[2]。llama.cppでは、常に動く部分はGPUに置いたまま、眠っているエキスパート層だけをシステムRAMへ退避させられます。具体的には、全層をGPUへ載せた上で、エキスパート部分だけをRAMに残す指定(–n-cpu-moe)を組み合わせます。指定した数の層からエキスパート部分を剥がし、RAMに保持する動きです[2]。デスクトップでも効果は確認されています。RTX 4070 Ti Super(16GB GDDR6X)では、この構成のQwen3.6-35B-A3Bがテストした中で最速だったと報告されています[2]。
こうした手法の解説も増えています。–n-cpu-moeとストリーミングの仕組みを解説する記事[6]をはじめ、少ないVRAMで大きなモデルを動かすためのガイド[4]、大規模MoEモデルの推論性能を最適化するガイド[7]、2026年版としてllama.cppの推論速度を最大限に引き出す方法をまとめた記事[8]などが並びます。1つのフラグの使い方が、これだけ多くの解説を生むテーマになっているようです。
GitHubでもMoE推論に特化した動きが続いています。llama.cpp-moeは「ローカルで、効率的で、理解しやすい」実用的なMoE推論を掲げ、エキスパートの挙動を可視化して調整しやすくする軽量な操作を備えています[3]。GPU側にエキスパートを受け入れる枠を設け、その数で管理する設計(–moe-gpu-expert-slot-num)も特徴です[3]。また、MoEモデルの推論を最適化するllama.moeというプロジェクトもあります[5]。
しかし、名目上の主役である「スマホ」は、まだ静かな状況です。BigMoeOnEdgeの投稿はポイント1・コメント0で、Hacker News上でほとんど反応を集めていません[1]。また、XDAの実験も「妥当な速度で動いた」という定性報告にとどまります。素材にはdecode(トークンを1つずつ生成する段階)の速度などの実測数値は見つかりませんでした[2]。RAMから必要なエキスパートを随時読み出すのがストリーミング方式の仕組みで[6]、その速度は機器のメモリ性能に左右されやすいと考えられます。
XDAの著者は、PCでできることはVRAMに制限されがちだが「回避策はほぼすべてにある」という趣旨を述べていました[2]。MoEオフロードはその代表格で、8GB級GPUでも大型モデルを試せる段階に入っています。一方で、スマホでの実用化はまだ構想段階で、実機の速度データは蓄積されていません。エキスパート層をRAMへ退避させる発想が、ノートPCからスマホへどこまで届くか。BigMoeOnEdgeのようなプロジェクトが実機の実測を出せるかどうかが、次の見どころになりそうです。
引用リスト
[1] https://github.com/Helldez/BigMoeOnEdge
[2] https://www.xda-developers.com/i-stopped-thinking-my-8gb-gpu-was-too-small-after-learning-to-offload-moe-llm-layers-to-ram/
[3] https://github.com/leoustc/llama.cpp-moe
[4] https://aliteq.com/llama-cpp-moe-offloading-run-bigger-models-less-vram
[5] https://github.com/jklincn/llama.moe
[6] https://www.shawnmayzes.com/ai-engineering/llama-cpp-moe-expert-offload-explained/
[7] https://gist.github.com/DocShotgun/a02a4c0c0a57e43ff4f038b46ca66ae0
https://www.xda-developers.com/i-stopped-thinking-my-8gb-gpu-was-too-small-after-learning-to-offload-moe-llm-layers-to-ram/
[8] https://docs.bswen.com/blog/2026-03-15-llamacpp-optimization-speed/
RECENT COMMENTS