「2bitまで圧縮したのに、元のモデルと同じスコア――それは本当に信じられるのか」。12GBのGPU1枚で763Bの巨大モデルを動かす話題の量子化版DeepSeek-V4.1-Flash-1017について、その後、コミュニティで「検証が必要では」という声が上がっています[1]。
量子化とは、モデルの重みを圧縮してメモリを節約する仕組みです。公開したのは、定番の圧縮手法GPTQを生んだオーストリアの研究グループISTA-DASLabです[3]。今回はGSQとRCOという2つの手法を組み合わせています。GSQは各テンソル(重みのまとまり)を低ビットでも精度よく量子化する手法で、論文としても公開されています[4]。通常は近い値に丸めるだけですが、GSQは丸め先の値そのものを最適化変数にする点が特徴です[3]。RCOはサイズの予算内で、テンソルごとに量子化の型を割り振る手法です[3]。
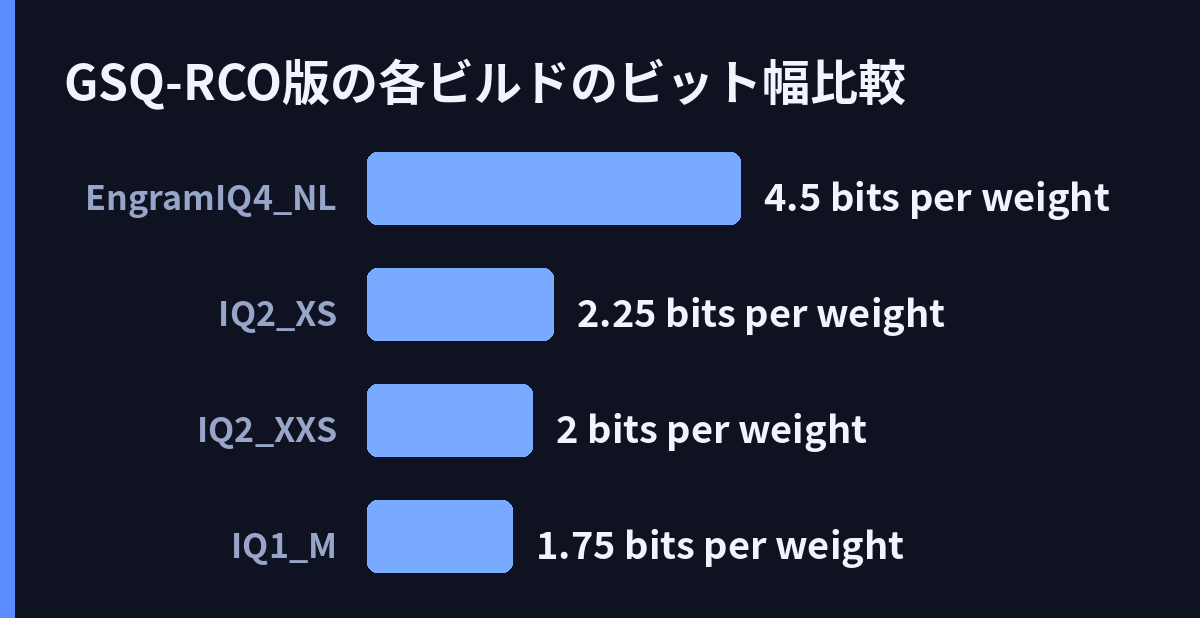
用意されたのは3種類で、重み1つあたりのビット数(bpw)はIQ1_Mが1.75、IQ2_XXSが2.00、IQ2_XSが2.25です[2]。対象モデルは1層に384個のエキスパートを持ち、1トークンあたり6個だけを稼働させるMoEで、コンテキストは100万トークンに及びます[2]。エキスパート部分がパラメータの大半を占めるため、探索の自由度もそこに集中したようです[2]。量子化の型は層ごとに割り振られています。GGUFというファイル形式ではエキスパート単位の指定ができないためです[2]。なお、モデルが持つEngramという参照テーブル2つは計196.6Bパラメータで、全ビルド共通の別ファイル(4.50bpw)として1回だけダウンロードすればよい仕組みです[2]。

動かすにはStrataという推論エンジンとの組み合わせが前提で、この構成なら12GBのGPU1枚で収まります[2]。ただしシステムRAMやディスク容量、メモリ帯域も要件になり、大きなシステムRAMを持つワークステーションでのプライベートなローカル推論向けとされています[3]。
ここで話題になっているのが、Redditのr/LocalLLaMAに投稿された疑問です。投稿者は、ISTAのベンチマークではIQ2_XXSが元モデルと同等のスコアを示すとされる点を「良すぎて信じられない」と問題提起しました[1]。理由はベンチマークの飽和です。スコアはすでに90%以上に達しており、AIME25に至っては全バージョンで100です。ここからは劣化を読み取れません[1]。
そこで投稿者は、別の検証指標を求めています。KLDは元のモデルとの出力のずれを測る量、PPLは予測の当たりにくさを示す指標です。約2bpwでどの程度のKLDになるかは、投稿者自身にも見当がつかないとしています[1]。GSQ-RCO版のKLDはまだ見つかっていないようです[1]。実際に使って品質がベンチマーク通りに感じられるか、体験談も募っています[1]。この疑問はメディアにも広がり、「量子化の奇跡か、それともベンチマークの飽和か」と題した検証記事が登場しています[6]。
一方で、技術そのものはローカルAIコミュニティに広がりを見せています。GitHubには有志によるApple Silicon向けのMLX実装が登場しました[5]。noteでは、Qwen3.8-Flash-Nextを24GBのGPUで128Kコンテキストまで動かすGSQ-RCOの実践レポートも投稿されています[6]。ただし、今回の素材にはKLDやPPLの実測値、速度や消費電力の実測値は見つかりませんでした。高スコアが品質の実態を示しているかは、まだ誰も確かめられていないのが実情のようです。
12GBのGPUで763Bが動く構成の妙は、以前取り上げた通りです。残る問いは「2bitで品質をどこまで保てるか」です。ベンチマークが飽和した時代には、KLDのような繊細な指標こそが検証の主役になっていくのかもしれません。有志によるKLDやPPLの実測が上がってくることが、次の節目になりそうです。
引用ソース
- Reddit Reddit r/LocalLLaMA: Too good to be true? ISTA’s GSQ-RCO 2-bit DeepSeek-V4.1-Flash scoring the same as the base model — https://www.reddit.com/r/LocalLLaMA/comments/1xes5x0/too_good_to_be_true_istas_gsqrco_2bit/
Too good to be true? ISTA’s GSQ-RCO 2-bit DeepSeek-V4.1-Flash scoring the same as the base model
- Web記事 記事全文: ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF · Hugging Face — https://huggingface.co/ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF
Non-uniform GGUF quantizations of a 763B-parameter, 384-expert MoE, produced with GSQ and RCO.
This repository provides GGUF quantizations of DeepSeek-V4.1-Flash-1017 at three sizes: IQ1_M (1.75 bits per weight), IQ2_XXS - Web記事 記事全文: ISTA-DASLab Squeezes DeepSeek’s 763B Model onto a 12 GB GPU | AlphaSignal — https://alphasignal.ai/news/ista-daslab-squeezes-deepseek-s-763b-model-onto-a-12-gb-gpu
– ISTA-DASLab released GSQ-RCO GGUF quants of DeepSeek-V4.1-Flash-1017, a 763B 384-expert MoE.
– Three sizes available: IQ1_M (1.75 bpw), IQ2_XXS (2.00) and IQ2_XS (2.25).
– Runs on a single 12GB GPU when paired with the - Web記事 Web検索: [2604.18556] GSQ: Highly-Accurate Low-Precision Scalar Quantization for … — https://arxiv.org/abs/2604.18556
[2604.18556] GSQ: Highly-Accurate Low-Precision Scalar Quantization for …
- Web記事 Web検索: GitHub – egesabanci/gsq-rco-mlx: GSQ quantization + RCO bit allocation … — https://github.com/egesabanci/gsq-rco-mlx
GitHub – egesabanci/gsq-rco-mlx: GSQ quantization + RCO bit allocation …
- Web記事 Web検索: Quantization Miracle or Benchmark Saturation? Unpacking ISTA’s 2-bit … — https://baguaai.com/quantization-miracle-or-benchmark-saturation-unpacking-istas-2-bit-deepseek-v4-1-flash/
Quantization Miracle or Benchmark Saturation? Unpacking ISTA’s 2-bit …
- Web記事 Web検索: Qwen3.8-Flash-Next Field Report: 128K Context on 24GB, GSQ-RCO … — https://note.com/samehadaonsen/n/n2383084c073c?hl=en
Qwen3.8-Flash-Next Field Report: 128K Context on 24GB, GSQ-RCO …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS