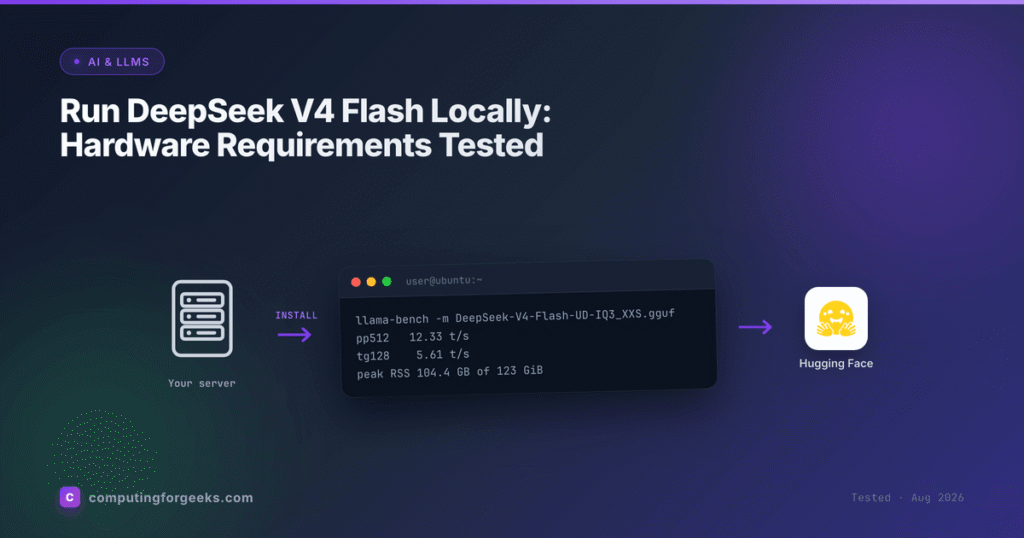
2千ユーロクラスのPCで、284BのモデルがGPUなしで動く——。セルフホストのカルチャーを背負うハッカーたちの間で、DeepSeek V4 Flashのローカル実行が注目を集めています。前回は米政府機関での扱いを追いましたが、今回は手元のマシンでどこまで動くのかという、別の前線の結果です。果たしてGPUのないマシンで、巨大モデルは実用になるのか。実測結果から読み解きます。
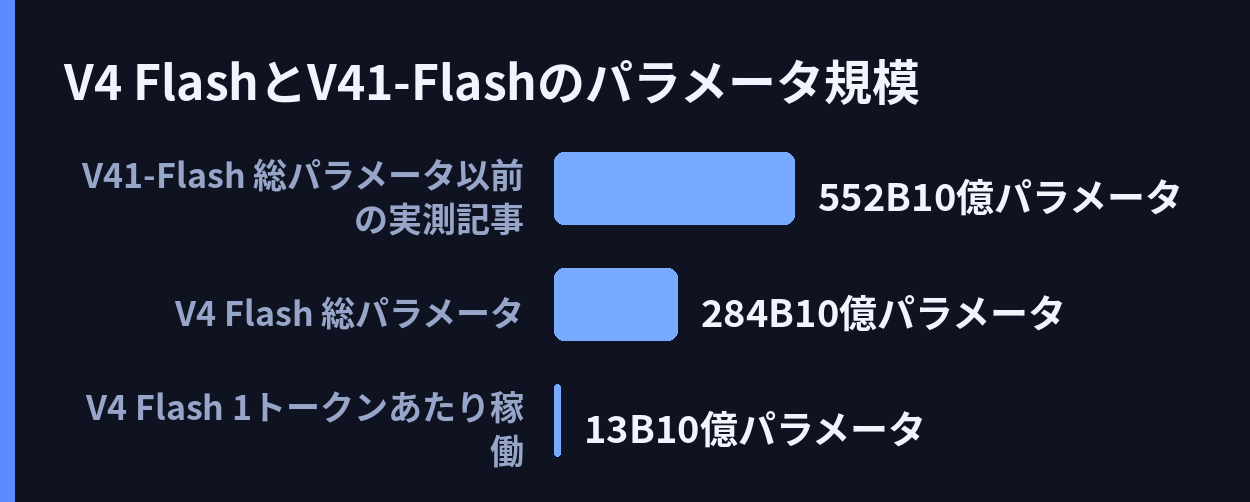
鍵はMoEという構造です。V4 Flashは全体で284Bのパラメータを持ちながら、1トークンあたり動くのは13Bだけ。全体の約4.6%です[1]。このひとつの数字が、ハードウェアの話の全体を決めると記事は強調します[1]。もし同じ284Bが全部動く密なモデルなら、GPUクラスタなしでは手が届きません[1]。稼働が13Bに抑えられるぶん、計算とメモリへの負荷は中規模モデルに近づきます[2]。ただし、どの部分が選ばれるかは事前にわかりません。そのため全部のパラメータをメモリに常駐させておく必要があります[1]。ここから意外な結論が出ます。重要なのはメモリの速度ではなく容量です。大容量のDDR5を積んだマシンが、高速な24GBのGPUより有利になるというものです[1]。帯域や計算量の要求は、動くパラメータの側で決まります[1]。

実測記事のマシンは、物理8コア・16スレッドのXeon、実効123GiBのRAM、GPUなしという構成です。llama.cppのビルドb10273を使い、Ubuntu 24.04上で2026年8月に計測しました[1]。記事は、量子化(重みを圧縮してメモリを節約する仕組み)した重みファイルGGUFの選び方や、実測したメモリの下限、ロード後の速度を整理しています[1]。ただし、今回引用できた範囲にTPSの具体的な数値は見つかりませんでした。GPU別や他エンジンとの比較データも素材にはありません[1]。
一方、API側では名前の整理が進んでいます。旧名のdeepseek-v4-flashは引退しました。リクエストはDeepSeek-V4.1-Flashが処理し、Flash価格で課金されます[2]。画像対応も、メインのdeepseek-flashに統合されています[2]。2026年10月時点の確認では、重みはまだ生きており、MITライセンスのままHugging Faceからダウンロードできます[2]。コンテキストは100万トークン、ホスト型APIの最大出力は約384Kです[2]。ベースと指示チューニングの2種類のチェックポイントがあり、指示版は重みを4ビットと8ビットで混在させる精度設定(FP4+FP8)です[2]。料金はオフピーク時に0.15ドル/0.60ドルという記載もあります[2]。
ここに落とし穴があります。ローカルで動かせる重みは、284BのV4 Flashのままです。以前この連載で取り上げたV4.1-Flashは、45Tトークンで事前学習した552Bのモデルで、V4 Flashの改良版ではなく新規の事前学習モデルでした。552BのV4.1-Flashそのものを2千ユーロPCで動かしたという報告は、今回の素材には見つかりませんでした。名前だけ頼って重みを探すと、APIとは別のバージョンのモデルを動かすことになりかねません。
同じMoEでも、限界線ははっきりしています。Kimi K3を同じクラスのマシンで動かす試みは、RAMとVRAM合計で610GBの下限が必要なため、最初から除外されました[1]。これはデータセンターの問題であって、デスクの問題ではないと記事はまとめています[1]。同じ容量ファーストの計算は、より小さいモデルのVRAM見積もりにも応用できるといいます[1]。
解説記事も増えています。V4.1-FlashとV4 Flashそれぞれのハードウェア要件を解説する記事[3][4]、価格とベンチマークをまとめたガイド[5]、Ollama(ローカルAI実行を簡単にする定番ツール)などでのセットアップ手順を扱う記事[5][5]が相次ぎました。元の実測記事は検索結果の上位にも並んでいます。
MoEのスパースさが、巨大モデルをデスクに引き下ろしたようです。容量さえ確保できれば、AIの推論を手元で試す選択肢は、すでに現実になっています。24GBのGPUでは届かなかったモデルが、RAMの量であれば届きます。ハードウェア選びの常識が逆転した事例として、今後も参照される実例になるでしょう。ただし手元で動くのは284BのV4 Flashで、APIのV4.1-Flashそのものではありません。名前と中身の対応を押さえることが、ローカル実行の第一歩になりそうです。
引用ソース
- Web記事 記事全文: DeepSeek V4 Flash: Local RAM and Speed Tested | ComputingForGeeks — https://computingforgeeks.com/run-deepseek-v4-flash-locally/
Thirteen billion of DeepSeek V4 Flash’s 284 billion parameters activate per token. That one number decides the entire hardware conversation. A dense model of the same size would be out of reach for anything short of a GP
- Web記事 記事全文: Run DeepSeek V4 Flash Locally: Full 2026 Setup Guide — https://codersera.com/blog/run-deepseek-v4-flash-locally-full-2026-setup-guide/
deepseek-v4-flash API name is retired — those calls now reach DeepSeek-V4.1-Flash.
DeepSeek V4 Flash is a new open‑weight large language model focused on speed and cost. It offers a one‑million‑token context window and s - Web記事 Web検索: DeepSeek V4.1 Flash Hardware Requirements: GPU, Memory, and Deployment … — https://www.yottalabs.ai/post/deepseek-v4-1-flash-hardware-requirements-gpu-memory-2026
DeepSeek V4.1 Flash Hardware Requirements: GPU, Memory, and Deployment …
- Web記事 Web検索: DeepSeek V4 Flash Hardware Requirements: GPU, Memory, and Deployment … — https://www.yottalabs.ai/post/deepseek-v4-flash-hardware-requirements-gpu-memory-2026
DeepSeek V4 Flash Hardware Requirements: GPU, Memory, and Deployment …
- Web記事 Web検索: DeepSeek V4.1 Flash Guide: Pricing, Benchmarks, Local Setup — https://codersera.com/blog/deepseek-v4-1-flash-complete-guide-2026/
DeepSeek V4.1 Flash Guide: Pricing, Benchmarks, Local Setup
- Web記事 Web検索: How to Run DeepSeek V4.1 Flash Locally: Hardware and Setup — https://www.mindstudio.ai/blog/deepseek-v4-1-flash-local
How to Run DeepSeek V4.1 Flash Locally: Hardware and Setup
- Web記事 Web検索: DeepSeek V4 Local Deployment: GGUF, Ollama & Hardware — https://deepseek-v4.io/local-deployment
DeepSeek V4 Local Deployment: GGUF, Ollama & Hardware
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。

RECENT COMMENTS