JARファイル1つ、依存ライブラリなし。しかも「llama.cppより速い」――こんなうたい文句のJVM製推論エンジンが、Hacker Newsで話題になっています[1]。この連載で何度も取り上げてきた投稿で、現在のスコアは2ポイント、コメントは1件です[1]。反応は小さいものの、投稿者自身がコメント欄で中身を詳しく説明しているのが特徴です[3]。
投稿者によると、このQuixotic AIというプロジェクトは、AIの処理一式をJVM(Javaの実行環境)上にまとめた本格的な試みです[3]。CPU上での性能はすでにllama.cppと競争できること。APIはシンプルに作られていること。スタックの各部品はどれも単体で使えること。そんな説明が並びます[3]。対応モデルはGemma 4、Qwen 3.5+、LFM 2.5など最新のオープンモデルです[3]。スタック全体が、依存関係ゼロの2.6MBのfat JAR(実行に必要な物を全部詰めた1個のファイル)に収まります[3]。作者は「開発はとても楽しかった」とも綴っています[3]。
では、この主張を取り巻く2026年の環境はどうでしょうか。ローカルLLMランタイムを比較した記事によると、今年の主役はOllama、LM Studio、llama.cpp、vLLM、Janの5つです[2]。純粋な推論エンジンはllama.cppとvLLMの2つだけです[2]。Ollama、LM Studio、Janの3つは、llama.cppに使いやすい画面をかぶせた存在だといいます[2]。LM Studioはモデル閲覧付きのGUIアプリで、JanはAGPL-3.0ライセンスのオープンソース版GUIです[2]。Ollamaは1コマンドでインストールとモデル実行が済む手軽さに加え、CursorやAiderなど多くのエージェント用ツールが初期の対応先にするほど普及しています[2][4]。ただし生のllama.cppより常に少し遅いという弱点も指摘されています[4]。
見逃せないのがメモリ効率の差です。llama.cppとOllamaは、初期設定のままではKVキャッシュ(会話の文脈を保持するメモリ領域)の割り当てが非効率で、VRAMの30〜50%が遊んだままになるとの指摘があります[2]。VRAMはGPUに搭載された計算用メモリで、ここが足りないと大きなモデルを載せられません。一方、vLLMのPagedAttention(キャッシュを小刻みに管理して無駄を減らす仕組み)は、この損失を4%未満に抑えます[2]。同じGPUでも、エンジン選びで使えるメモリ量が大きく変わるというわけです。
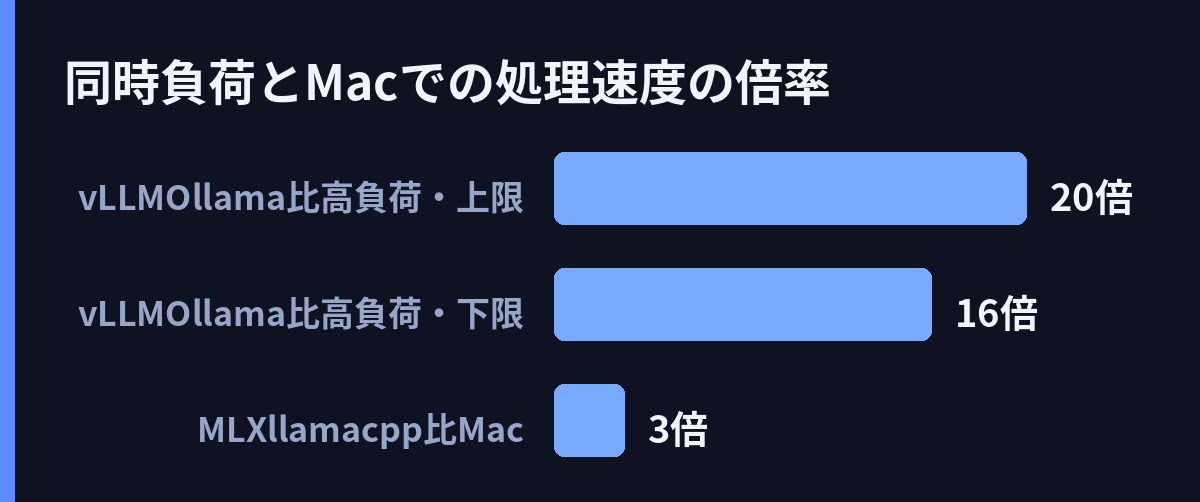
複数人での利用では、差がさらに広がります。速度比較はハードウェアと状況で大きく変わるとされ、単独利用のRTX 4090、単独利用のM4 Max、32人が同時に使うH100という3つの場面が比べられています[4]。そのうえで、継続的バッチ処理(複数リクエストを途切れなくまとめて処理する方式)を持つvLLMやTensorRT-LLMは、同時処理で桁違いに速くなります[4]。高負荷時のスループット(単位時間あたりの処理量)では、vLLMがOllamaを16〜20倍上回るという数値もあります[2]。Mac単体では話が違い、AppleのMLXエンジンがllama.cppのMetal経路(Apple製GPUを使う動作方式)より約3倍速いといいます[2]。速度の優劣は、ハードウェアと利用人数で入れ替わるのです。
ここで、少し冷や水を注ぎます。「llama.cppより速い」という主張は、あくまでCPU上の話です[3]。2026年のローカル推論をめぐっては、vLLM、SGLang、TGI、TensorRT-LLM、llama.cppといった名前を並べた比較記事が相次いでいます[5][6][7][7]。顔ぶれの中心はGPUサーバー向けのエンジンです。その輪に、JVM製エンジンの名前は見当たりません。素材の範囲でも、この「速さ」を第三者が検証した数値は見つかりませんでした。Hacker Newsでの反応も、スコア2ポイント・コメント1件と小規模なままです[1]。
それでも、このプロジェクトの強みは速度単独ではないと思われます。2.6MBのJARを既存のJavaシステムに組み込めば、GPUの準備もPython環境の構築もなしで推論が動くからです[3]。単独利用のCPU処理と、多数同時のGPU処理。2026年のランタイム勢力図は、この2つの土俵で主役が分かれています。JVM製エンジンがGPU向けの比較表に名前を連ねられるかどうかが、次の注目点になりそうです。
引用ソース
- Hacker News Hacker News: Local inferencing in one JVM JAR, dependency free, faster than llama.cpp — https://qxotic.ai/
Local inferencing in one JVM JAR, dependency free, faster than llama.cpp
- Web記事 記事全文: Best local LLM runtimes in 2026: speed vs setup tradeoff — https://botmonster.com/ai/best-local-llm-runtimes-2026/
Best local LLM runtimes in 2026: speed vs setup tradeoff
The best local LLM runtime in 2026 depends on what runs under the hood. Ollama, LM Studio, and Jan are all just llama.cpp rebranded with a friendlier interface, so - HNコメント HNコメント: cal inferencing in one JVM JAR, dependency free, faster than llama.cpp — https://news.ycombinator.com/item?id=50223693
Quixotic AI is a serious attempt to bring an end-to-end AI stack to the JVM. Performance is already competitive with llama.cpp (on CPUs), the APIs are crafted to be simple and easy to use. Every component in the stack ca
- Web記事 記事全文: Local LLM Inference Engines Compared: The Definitive 2026 Guide — https://www.local-llm.net/compare/inference-engines-2026/
The local LLM inference engine landscape in 2026 offers more choices than ever, and selecting the right one can dramatically affect your performance, developer experience, and hardware utilization. This guide compares th
- Web記事 Web検索: vLLM vs llama.cpp (2026): What Official Docs and Public Benchmarks … — https://markaicode.com/benchmarks/vllm-vs-llamacpp-performance/
vLLM vs llama.cpp (2026): What Official Docs and Public Benchmarks …
- Web記事 Web検索: Best LLM Inference Engines 2026: vLLM vs SGLang vs TGI vs llama.cpp — https://deploybase.ai/articles/best-llm-inference-engine
Best LLM Inference Engines 2026: vLLM vs SGLang vs TGI vs llama.cpp
- Web記事 Web検索: LLM Inference Engines Compared: vLLM, SGLang, Ollama & llama.cpp — https://leetllm.com/blog/llm-inference-engine-comparison-2026
LLM Inference Engines Compared: vLLM, SGLang, Ollama & llama.cpp
- Web記事 Web検索: LLM Inference Engine Benchmarks 2026: vLLM, SGLang, TensorRT-LLM — https://news.creeta.com/en/llm-inference-engine-benchmarks-2026-vllm-sglang-tensorrt/
LLM Inference Engine Benchmarks 2026: vLLM, SGLang, TensorRT-LLM
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS