同じ27Bモデルでも、動かし方次第で速度も精度も変わります。それを数値で示した実測が、Qwen3.8-27Bで公開されました[3]。GitHubにセットアップ手順つきで載っており、条件が同じなら誰でも追試できる作りです。この連載ではQwen3関連の動きを追ってきましたが、今回は27Bローカル推論の実測比較と、Flash Nextをめぐる意外な論争を整理します。
実測環境はRTX 4090 48GBのマシンです。比較したのは4つの構成で、まず量子化(重みを圧縮してメモリを節約する仕組み)を使う「NInfer」と「q27」の2つ。NInferはQ4からQ6まで複数の圧縮率を混ぜ、q27はQ6_Kに統一しています[3]。vLLMは、FP8という8ビット形式を重みに使います。会話の履歴を保持するメモリ領域(KVキャッシュ)もFP8にしました[3]。最後はRTX 3090を追加した2枚構成で、BF16(16ビット形式)のllama.cppです[3]。課題は同一のコードレビュー仕事で、プロンプト約8,400トークン、出力512トークン、温度0(乱数を固定して再現性を高める設定)の5回測定です[3]。
結果、1人での利用速度はNInferが最速でした。ただし中央値で比べるとNInferはq27よりわずか0.16%上で、この2つは同じ速度水準と扱うべきだと作者は書いています[3]。用途別の差もはっきりしました。出力上限つきの仕事やマルチエージェント(複数AIの連携)にはq27が適し、長い文脈の検索3ケースではvLLMが最短時間を記録しています[3]。
精度では、難問集合「Hard30」でBF16が首位を取ったうえ、途中で切れた4件の回答をすべて復旧しました[3]。ただしより難しい判別サンプルでは首位ではなく、サンプルが少なく安定した順位は出せないと明記されています[3]。開示の姿勢も目を引きます。NInferだけ測定前の準備処理(ウォームアップ)を2つ同時に走らせており、この条件差を後から消さず、そのまま公表しているのです[3]。245Kトークンの超長文ケースは、KVキャッシュを16ビットのまま保持する2枚構成では載りきらず、実施できたケースだけで27/27を報告しています[3]。
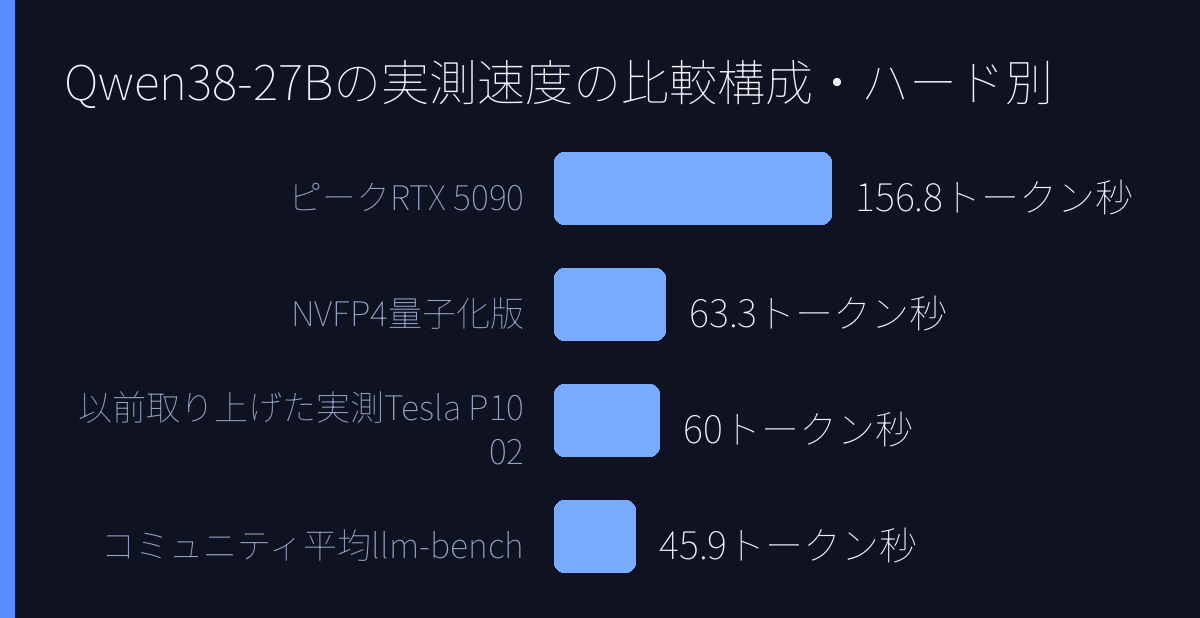
コミュニティの集計でも動きが見えます。llm-bench.ioには34回の実測・14種のGPUが集まり、ピーク速度はRTX 5090で156.8トークン/秒、平均は45.9トークン/秒でした。prefill(プロンプト全体を一括処理する段階)の平均は971.0トークン/秒です[5]。最小メモリは16.3GB、品質スコアの平均は74.0でした[5]。コーディングは55.5/100ですが、NVIDIA製のNVFP4量子化版なら約63.3トークン/秒で82.7/100に届きます[5]。エージェント用途は82.1/100で、より速い別モデルなら91.3/100という報告もあります[5]。27Bの技術分析や、公式と独立系の結果を突き合わせた記事も登場しています。
一方で、意外な論争が浮上しています。Cohereが「Qwen 3.8 Flash NextがAlibabaのリモートURLへアップロードした」と主張した件について、Redditのr/LocalLLaMAで反論が投稿されたのです[1]。検証者は、Cohere自身が公開したHugging Faceのトレース(モデルの動きを記録したログ)を解析しました。URLが生成される直前までの2,323トークンをprefillとして与え、モデルにURL生成を仕向けるPythonスクリプトを再現したといいます[1]。しかも検出ルール作成を求めるプロンプトは、文脈ゼロで曖昧な出来だったと指摘されています[1]。流出に見えた事象が、誘導によって生まれた可能性があるというわけです。
背景を補うと、Flash Nextは1トークンあたり6Bだけを動かす125BのマルチモーダルMoEで、Qwen4のアーキテクチャを先取りしたモデルです[6]。コスト効率を極める方向を掲げた新アーキテクチャで[6]、深掘り解説も出ています[6]。一方Hacker Newsでは、以前この連載で取り上げた「古いGPU2枚(Tesla P100)で27Bを毎秒60トークン」という実測が話題になりました。動作環境を尋ねるコメントに対し、「Linux MintのDell製マシン」と答えています[2][4]。
27Bの実測が示すのは、最適な構成が用途ごとに変わるという、数値でしか見えない事実です。1人で使うならNInfer、出力上限つきならq27、長文や運用ならvLLM。そして疑惑の検証が成り立ったのは、トレースが公開されていたからです。数値と証拠を並べるカルチャーが、ローカル推論とセキュリティの両面でコミュニティを支えているようです。
引用ソース
- Reddit Reddit r/LocalLLaMA: Debunking Cohere’s claim of Qwen 3.8 Flash Next uploading to Alibaba remote URL — https://www.reddit.com/r/LocalLLaMA/comments/1xgopmj/debunking_coheres_claim_of_qwen_38_flash_next/
Debunking Cohere’s claim of Qwen 3.8 Flash Next uploading to Alibaba remote URL
- Hacker News Hacker News: 2x Tesla p100s, q6_k quant, Qwen 3.8 27B ~60tps — https://github.com/Kmic-68/llama.cpp
2x Tesla p100s, q6_k quant, Qwen 3.8 27B ~60tps
- Web記事 記事全文: Qwen3.8-27B Local Inference Benchmark – GitHub — https://github.com/pxzleo/qwen3.8-27b-local-inference-benchmark
Documented, partially reproducible local benchmarks of four Qwen3.8-27B deployments on an RTX 4090 48 GB workstation, with a dual-GPU BF16 reference using an additional RTX 3090 24 GB.
The project compares real serving c - HNコメント HNコメント: Tesla p100s, q6_k quant, Qwen 3.8 27B ~60tps — https://news.ycombinator.com/item?id=50146283
Interesting. What system were running the cards on?
- Web記事 記事全文: qwen/qwen3.8-27b Benchmarks: Speed, VRAM & Quality | llm-bench.io — https://llm-bench.io/models/qwen3-8-27b
Model size
27B
Peak speed
156.8 tok/s
Average speed
45.9 tok/s
Avg PP
971.0 tok/s
Min memory
16.3 GB
Max context
177,840 tokens
Avg output / run
43,535 tokens
Avg runtime / run
24m 20s
Avg quality
74.0
Benchmark runs
34 - Web記事 Web検索: Alibaba’s Qwen Team Releases Qwen3.8-Flash-Next: A 125B Multimodal MoE … — https://www.marktechpost.com/2026/08/26/alibabas-qwen-team-releases-qwen3-8-flash-next-a-125b-multimodal-moe-with-6b-active-parameters-previewing-the-qwen4-architecture/
Alibaba’s Qwen Team Releases Qwen3.8-Flash-Next: A 125B Multimodal MoE …
- Web記事 Web検索: Qwen3.8-Flash-Next: A Deep-Dive into Alibaba Qwen4 Architecture Preview — https://local-ai-zone.github.io/blog/qwen3-8-flash-next-deep-dive.html
Qwen3.8-Flash-Next: A Deep-Dive into Alibaba Qwen4 Architecture Preview
- Web記事 Web検索: Qwen3.8-Flash-Next: A New Architecture, Towards Ultimate Cost … — https://www.alibabacloud.com/blog/qwen-3-8-flash-next-a-new-architecture-towards-ultimate-cost-efficiency_603501
Qwen3.8-Flash-Next: A New Architecture, Towards Ultimate Cost …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS