Qwen3.8 Flash-Nextのローカル推論で、RTX 5080と64GB RAMの構成が話題です。実測はエージェント作業で平均195.6トークン/秒、prefill約5700トークン/秒と報告されました。27Bの推定速度や不満もあり、構成とエンジン次第で評価が分かれています。
Qwen3.8 Flash-Nextのローカル推論で、RTX 5080と64GB RAMの構成が話題です。実測はエージェント作業で平均195.6トークン/秒、prefill約5700トークン/秒と報告されました。27Bの推定速度や不満もあり、構成とエンジン次第で評価が分かれています。
Alibabaが発表したQwen4は、まだリリースされていません。Flash Nextの総パラメータ125B、アクティブ6Bなどの構成から、ローカル推論とAPIモデルの分岐が見えます。当面は現行世代の27Bのメモリ確保が鍵です。
Flash NextにDFlash2を組み合わせると、llama.cppで平均17%速くなったという報告です。コードやリスト生成で伸びる一方、散文では差が小さい場面もありました。ローカル実行の速度と使いどころがわかります。
AI推論のFlash Nextで、DFlash2へのアップグレードが話題です。Apple Siliconでの実測では平均17%の速度向上が報告されました。用途や設定で差が出るため、ローカル環境での検証が重要です。
CohereがQwen 3.8 Flash Nextを安全実験に使い、資金調達と重なり物議。公式技術報告やベンチ計画はあるが、素材に実測値は乏しく、検証設計とモデル選択が焦点です。aiの危険性議論で、試しかたが問われます。続報です。
Qwen3.8-27Bのローカル推論を4構成で比べた実測が公開。専用エンジンと量子化Q6_Kの速度差は0.16%で、長文処理はvLLMが最速でした。コミュニティ34件の平均は45.9トークン/秒。Flash NextのURL流出疑惑は、プロンプトによる誘導の可能性が指摘されています。
ローカル推論エンジンStrataで、V100 32GB×3の古いサーバがQwen-Flash-Nextをほぼ400 tok/sで動かした投稿が話題です。公式はRTX 30/40/50世代とAMDの一部に対応し、0.2.6では大容量RAM環境のDeepSeekも高速化。対応外GPUを自前で支えるフォークの動きも見えます。
AlibabaがQwen 4に先駆けて公開したQwen3.8-Flash-Nextをめぐり、ARC-AGI-3コンペの勝利予報と冗談めいた「データ送信」投稿が同時に話題です。プレビューはMoE+n-gramメモリテーブル設計で、ローカルの目安は現行27BのBF16約54GB〜4ビット16GBです。
Redditで、ローカル動作のQwen3.8 Flash Nextによるモーショングラフィックス制作が話題です。Strix Haloと量子化モデルで、クラウド巨大モデルと同じフレームワークの動画を完成させました。ただし複数回の調整が必要で、速度の実測はまだありません。
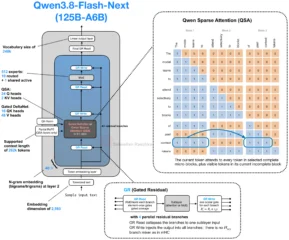
llama.cppに、Qwen4向け新構造QSAの選択処理からkq_maskを外すPRが登場し、Qwen Flash Nextで数GBのVRAM削減を掲げて話題に。QSAは4トークンのブロック単位で最大2,048トークンを選ぶ仕組みです。実装の進展と粗さというトレードオフを整理します。

2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
2026.11.10
続・RTX 3090、2026年に24GBがAIと4Kで再評価
2026.11.10
続・qwen-concept-27b、重み編集で思考トークン減りスコア増
RECENT COMMENTS