エージェントは、もう「関数を1つ書く」道具ではなくなっています。Hacker Newsには、AIコーディングのやり方を診断するShow HNが出ていました[1]。使っているAIコーディングの習慣と、足りていない習慣を見つけてくれます[1]。小さな修正ではなく、開発の進め方そのものを見る視点です。
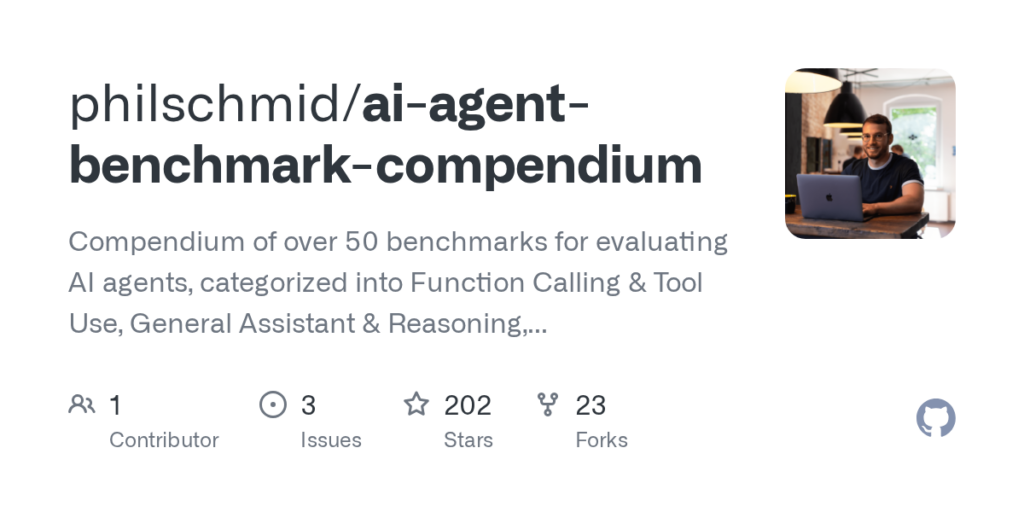
背景には、評価の広がりがあります。GitHubのまとめでは、50件以上のエージェント用ベンチマークが4つの領域に分けられています[2]。ベンチマークは、同じ問題で能力を比べるための試す問題集です。領域は、関数呼び出し、汎用アシスタントと推論、コーディング、コンピュータ操作です[2]。コンピュータ操作は、画面やツールを扱う力を見ます[2]。BFCLには、論文やGitHub、リーダーボード、データセットへのリンクが並びます[2]。
関数呼び出しは、ツールを使う能力です。BFCLという評価は、直列・並列・複数回のやり取りを評価します[2]。状態を持つ複数ステップの推論、メモリ、Web検索、形式への敏感さも扱います[2]。16,000個のRESTful APIを使う大規模評価もあります[2]。RESTful APIは、Webサービスを使うための約束事です[2]。これはChatGPTで自動生成された、ツール使用の指示データとしても使えます[2]。モデルの汎用的なツール使用能力を高めるために使えます[2]。リーダーボードでモデルを比べることもできます[2]。
複雑な呼び出しも増えています。1回の応答で複数段階の関数を使う場面、ユーザーの制約、パラメータ値の推論、長いパラメータ、128kの長い文脈が試されます[2]。会話型ベンチマークは、人間とAPIの両方に同時に応じる場面を扱います[2]。動的で開かれた現実世界の場面を想定します[2]。ECサイトや航空券予約の複数回のセッションで、方針を守りながら一貫した行動ができるかを見ます[2]。
今回の中心は、プロジェクト単位の実装です。既存の評価は、バグ修正など小さな単位に寄っていました[4]。ProjDevBenchは、自然言語の要求から動くリポジトリを作る力を測ります[4]。「vibe coding」と呼ばれる、高レベルの指示で全体を任せる流れが前提です[4]。単純な指示から、まとまったコードベースを作る力も期待されています[4]。エージェントは、構成を決め、複数のファイルを作ります[4]。依存関係を直し、動く状態まで持っていくことが期待されています[4]。20問、8分野、6つのエージェントを対象にしました[4]。バックエンドとなるLLMも違います[4]。評価は、Online JudgeとLLMによるレビューの合わせ技です[4]。Online Judgeは、提出したプログラムを自動で採点する仕組みです。
ProjDevBenchは、設計、機能の正しさ、繰り返し改善の3点を見ます[4]。受容率は、提出物が基準を満たした割合です[4]。全体受容率は27.38%でした[4]。基本機能やデータ構造は通るが、複雑な設計、時間計算量、資源管理でつまずきました[4]。概念中心の問題と、実世界のアプリの両方を扱うため、単純なコード生成とは評価軸が違います[4]。実装の完成度だけでなく、直せるかも見ています[4]。
話題は技術評価だけではありません。Show HNのコメントでは、AIのパワーユーザーを招く夕食会の話が出ていました[3]。今週サンフランシスコの上位5人を夕食に招くという話です[3]。2ポイント、1コメントと規模は小さいです。実践者の集まりが話題になっている点は注目です[1][3]。一方で、失敗の扱いも変わっています。XAIは、AIの判断を説明しやすくする考え方です[5]。生の実行トレースを、人が理解できる説明に変える試みです[5]。新しい報告では、AIシステムは理解していないという批判も出ています[6]。vibe codingの構造的な失敗に言及しています[6]。さらに、コーディングエージェント研究から人間が抜けているという指摘もあります[8]。研究の設計や評価に、人間の役割が入っていないという立場です[8]。エージェント駆動で自動ベンチマークを作る動きもあり、評価自体が自動化されています[7]。エージェントが評価の作り手にもなります[7]。
つまり、エージェントの評価は「速く書けるか」から「設計し直せるか」へ移っています。27.38%という数字は、丸ごと実装の難しさを示しています[4]。同時に、評価を自動化するほど、人間がどこで判断するかが見えにくくなります[7][8]。人間の確認が課題になります[8]。今後の鍵は、推論と実行の記録を人が読める形にすることです[5][6]。AIコーディングのカルチャーは、まだ作っている途中のようです[1][3]。
引用ソース
- Hacker News Hacker News: Show HN: Coding agent spots your AI practices and the ones you’re missing — https://app.userrank.ai/
Show HN: Coding agent spots your AI practices and the ones you’re missing
- Web記事 記事全文: AI Agent Benchmark Compendium – GitHub — https://github.com/philschmid/ai-agent-benchmark-compendium
This post provides a high-level overview to over 50 of modern benchmarks, grouped into four key categories Function Calling and Tool Use, General Assistant and Reasoning, Coding and Software Engineering and Computer Inte
- HNコメント HNコメント: ow HN: Coding agent spots your AI practices and the ones you’re missin — https://news.ycombinator.com/item?id=50275266
Also I find that power users of AI are some very interesting people – so I'd really to invite the top 5 in San Francisco this week for a dinner!
- Web記事 記事全文: ProjDevBench: Benchmarking AI Coding Agents on — https://arxiv.org/html/2602.01655v1
ProjDevBench: Benchmarking AI Coding Agents on
End-to-End Project Development
Abstract
Recent coding agents can generate complete codebases from simple prompts, yet existing evaluations focus on issue-level bug fixing a - Web記事 Web検索: XAI for Coding Agent Failures: Transforming Raw Execution Traces into … — https://arxiv.org/pdf/2603.05941
XAI for Coding Agent Failures: Transforming Raw Execution Traces into …
- Web記事 Web検索: “AI systems do not understand”: New report flags systemic failures in … — https://thenewstack.io/acm-vibe-coding-ai-agent/
“AI systems do not understand”: New report flags systemic failures in …
- Web記事 Web検索: Automatically Benchmarking LLM Code Agents through Agent-driven … — https://arxiv.org/html/2510.24358v1
Automatically Benchmarking LLM Code Agents through Agent-driven …
- Web記事 Web検索: Position: Humans are Missing from AI Coding Agent Research — https://arxiv.org/html/2608.12355v1
Position: Humans are Missing from AI Coding Agent Research
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。


RECENT COMMENTS