1枚のGPUで、AIモデルをどこまで速く動かせるのか。前回の追跡記事で「AI企業の買い占めで定価の3倍超」とお伝えしたRTX 5090ですが、カードを手にしたユーザーの間では今、ローカルLLM推論(クラウドに頼らず自分のPCでAIを動かすこと)の実力測定が相次いで公開されています[2][4]。
舞台は32GBのVRAM(グラボ専用のメモリ)を備えるNVIDIA最上位のコンシューマーGPUです。この容量は、中型モデルを量子化で圧縮して載せるのにちょうどよい大きさのようです。コンテキスト(モデルが一度に扱える文章量)をどこまで伸ばせるかも共通の関心で、対応モデルや伸ばし方を整理した記事も出ています[4][5]。
注目を集めたのが、Redditのr/LocalLLaMAに投稿されたエンジン比較です[1]。投稿者は話題の推論エンジン7種を、1枚のRTX 5090と128GBのRAMで同じ条件で走らせました。比較したのはStrata、Infernix、capy-flash、ninfer-ext、ninfer、llama.cpp、そして自作のBasaltです。モデルはQwen 3.8 FNで、チェックポイント(重みデータ)もリクエストも同一です。NVIDIAの4bit量子化形式NVFP4を、各エンジン付属のツールで変換して統一しました。量子化は重みを圧縮してメモリを節約する仕組みです。設定は各エンジンの公式ドキュメントに沿っています。
測定はRTX 5090を400Wに固定し、リクエストごとにコールドスタート(毎回まっさらな状態)で実施しました。decode(トークンを1つずつ生成する段階)とprefill(プロンプト全体を一括処理する段階)を、短いコンテキストと長いコンテキストの深さの両方で計測しています。投稿者自身が比較対象エンジンの開発者の一人であることは冒頭で明かし、「できるだけ公平に」と説明しました。セットアップには5時間以上かかったとも綴っています。結果は各項目ごとの表で公開されており、最良値が太字で示されています[1]。
Webサイトhardware-cornerの計測では、Qwenの8Bから32Bまで5モデルを、Q4_K_XLという4bit系の量子化で試しました[2]。測定にはllama-benchというベンチツールを使い、Flash Attention(アテンション計算を高速化する手法)を有効にしています。プロンプト処理で約1万トークン/秒、コンテキストで139Kトークンという数値を掲げています。プロンプト処理はメモリ帯域(メモリからデータを運ぶ速度)の効率を示す指標です。検索した資料をプロンプトに添えて答えさせるRAGや、長い会話履歴の処理で効いてきます。コンテキスト深さは約4千から13万トークン超まで段階的に変えて測定されました[2]。
GitHubでは、Qwen3.8-27BをRTX 5090で動かすベンチマークも公開されました[3]。llama.cppにMTP推測的デコーディング(先のトークンを複数まとめて仮予測し、検証しながら進めることで速くする手法)を組み合わせたもので、最良の試行では67.87トークン/秒でした。仮予測が本命の出力と一致した割合を示す受容率は67.08%です。仮予測の長さを4段階で試したところ、長くしても受容率は上がりませんでした。「数を増やすほど受容率は下がるが、加速の機会は増える」というトレードオフが見えています。この構成では仮予測最大4が最速でした。VRAM使用量やGPU温度、消費電力もあわせて記録されています[3]。
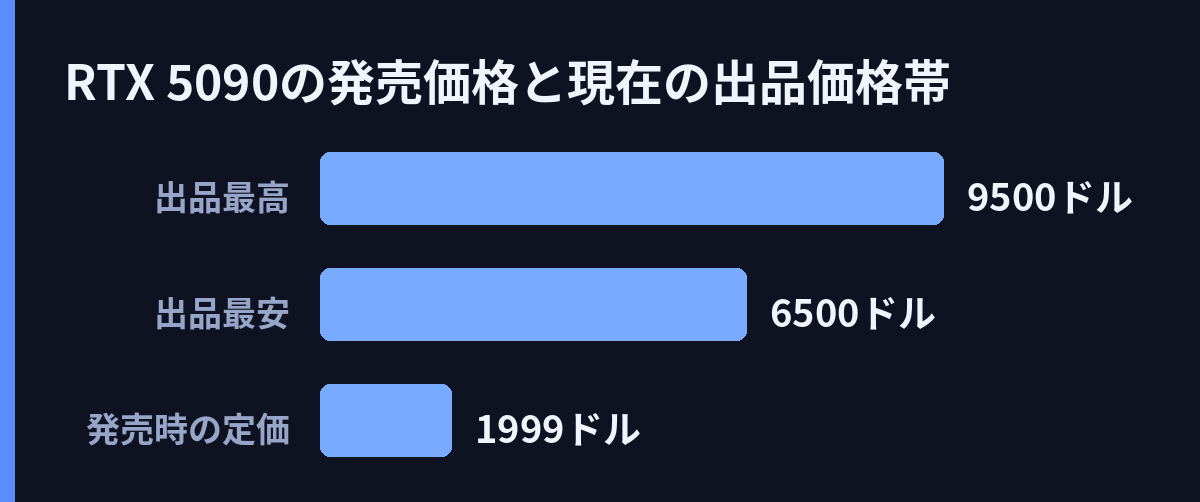
しかし、華やかな数値の裏には注意点もあります。まず、エンジン比較の実施者は比較対象の開発者の一人です。公平性への配慮は説明されていますが、結果の読み方は慎重にしたいところです[1]。MTPも設定次第で結果が変わる繊細な手法です[3]。そして何より、カード自体が高騰したままです。以前取り上げた買い占め追跡の実測では、出品価格は6500〜9500ドルでした。2025年1月の発売価格1999ドルの3倍超で、高いものでは4倍を超えます。この投資額なら、クラウドAPIや複数GPU構成と比べたくなるのも自然でしょう。
こうした中、vLLM、TensorRT-LLM、Ollama、llama.cppという代表的エンジンを5090向けに比較する解説記事も複数登場しています[5][5][5]。1枚でどこまでやるか、どのエンジンを選ぶか、迷うユーザーが多いようです。それでも今回の結果は、1枚のコンシューマーGPUで27B級のモデルが実用速度で動くことを示しました。エンジンと設定の選択が性能を大きく左右する以上、カード価格が落ち着く頃には、ローカル推論のノウハウがさらに積み上がっていそうです。
引用ソース
- Reddit Reddit r/LocalLLaMA: I ran all the popular Qwen 3.8 FN engines on a single 5090 + 128GB of RAM, here are the numbers — https://www.reddit.com/r/LocalLLaMA/comments/1xdlunp/i_ran_all_the_popular_qwen_38_fn_engines_on_a/
I ran all the popular Qwen 3.8 FN engines on a single 5090 + 128GB of RAM, here are the numbers
- Web記事 記事全文: RTX 5090 LLM Benchmark Results: 10K Tokens/sec Prompt Processing, 139K … — https://www.hardware-corner.net/rtx-5090-llm-benchmarks/
I recently completed extensive local LLM inference benchmarks on the NVIDIA RTX 5090 32 GB. My primary focus was gathering raw performance data on critical metrics for the local enthusiast: prompt processing speed (PP),
- Web記事 記事全文: GitHub – JavierMedel/qwen3.8-27b-rtx5090-benchmark — https://github.com/JavierMedel/qwen3.8-27b-rtx5090-benchmark
Local LLM inference benchmark for Qwen3.8-27B on an NVIDIA RTX 5090 24GB
Results • Configuration • Methodology • Reproduction • Hardware
This project benchmarks Qwen3.8-27B running locally on an NVIDIA RTX 5090 with 24GB - Web記事 Web検索: RTX 5090 Local LLM Benchmarks, Context Scaling & Supported Models 2026 … — https://www.hardware-corner.net/gpu-llm-benchmarks/rtx-5090/
RTX 5090 Local LLM Benchmarks, Context Scaling & Supported Models 2026 …
- Web記事 Web検索: vLLM vs TensorRT-LLM vs Ollama vs llama.cpp — Choosing the Right … — https://dev.to/soytuber/vllm-vs-tensorrt-llm-vs-ollama-vs-llamacpp-choosing-the-right-inference-engine-on-rtx-5090-2aap
vLLM vs TensorRT-LLM vs Ollama vs llama.cpp — Choosing the Right …
- Web記事 Web検索: vLLM vs TensorRT-LLM vs Ollama vs llama.cpp: Choosing the Best … — https://explore.n1n.ai/blog/vllm-vs-tensorrt-llm-vs-ollama-vs-llamacpp-rtx-5090-2026-03-14
vLLM vs TensorRT-LLM vs Ollama vs llama.cpp: Choosing the Best …
- Web記事 Web検索: Ollama vs vLLM vs llama.cpp: Speed Benchmarked | ComputingForGeeks — https://computingforgeeks.com/ollama-vs-vllm-vs-llama-cpp/
Ollama vs vLLM vs llama.cpp: Speed Benchmarked | ComputingForGeeks
- Web記事 Web検索: Best LLM for 32GB VRAM (2026): What an RTX 5090 Really Runs — https://localaimaster.com/vram/best-llm-32gb-vram
Best LLM for 32GB VRAM (2026): What an RTX 5090 Really Runs
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS