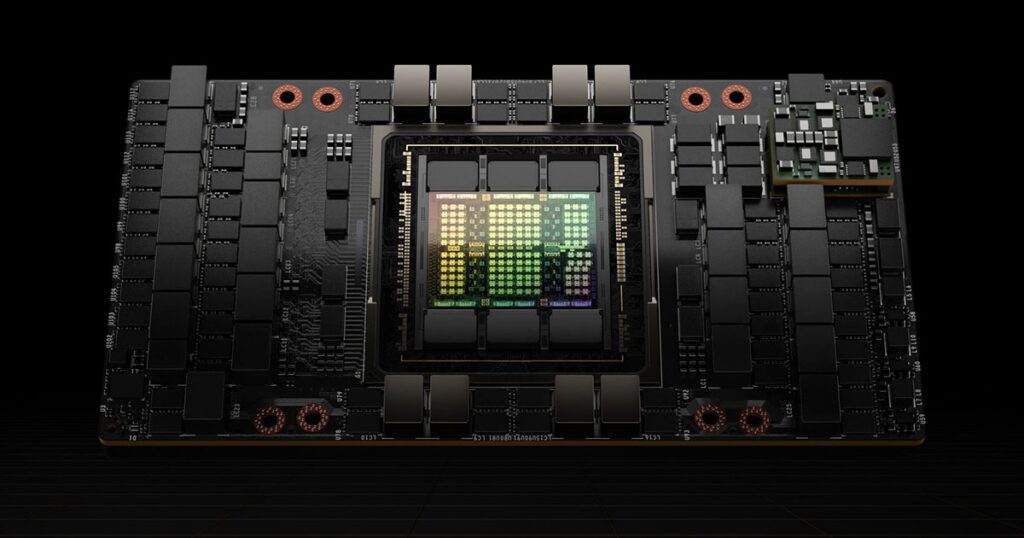
AI推論のセッション速度では、ローカルセットアップがflashのように話題になっています。ハッカー的な工夫ではなく、実測の差です[2]。NVIDIAのH100は公式に、HopperアーキテクチャとTransformer Engine(Transformerの計算を速くする仕組み)でLLMを最大30倍高速化し、GPT-3 175Bの学習で前世代比4倍を掲げています[1]。第四世代NVLinkでGPU間を900GB/sでつなぐ点も、データシートに示された基本仕様です[1][5]。
そのH100に対し、BlackwellのB200がどこまで迫るかが注目されました。Lightlyの比較では、実作業に近いタスクで、B200がH100より最大57%速く学習できました[2]。対象はYOLOv8とDINOv2のコンピュータビジョン事前学習です[2]。さらに、自前運用なら、クラウドのH100より最大10倍安く済むと報告されています[2]。同じ比較記事は検索でも目立ち、別の解説や、事前学習・ファインチューニングの実数値を示した記事も出ています[5]。
ただし、推論は単純ではありません。B200はGemma 27Bでは約10%の高速化にとどまり、DeepSeek 671Bでは当初H100とほぼ同等でした[2]。大規模推論ではメモリ帯域が詰まりやすいとされます[3]。これは、Blackwellのソフトウェアがまだ初期段階で、ドライバやCUDAライブラリ、最適化フレームワークの成熟が待たれるためです[2]。
仕様面では、B200は192GBのHBM3e(高速メモリ)と8TB/sの帯域、FP4(4ビットの低精度演算)対応が特徴です[3][4]。仕様上の学習スループットは約2倍と示されています[3]。H100は80GBで帯域が3.35TB/sなので、70BモデルをFP16で載せると、B200は1枚、H100は2枚必要になります[3]。消費電力はB200が最大1000W、H100が700Wです[3]。NVLink 5.0は1800GB/sとされ、接続も強化されています[4]。
価格も判断材料です。Spheronでは、B200がオンデマンドで1時間あたり11.02ドル、スポットで5.72ドルと示されています[3]。別の仕様ページでは、概算35,000ドル、クラウドで12.50ドル/時が掲載されています[4]。電力を分解したベンチマーク研究も登場し、速さだけでなく消費電力との向き合い方が問われています[5]。
落とし穴は、FP4の恩恵が条件付きな点です。サービング基盤がNVFP4でなければ、FP4の強みは生かせません[3]。また、FP16で約34B未満のモデルなら、H100のほうが買い得だとされています[3]。
つまりB200は「新しいから常に速い」GPUではありません。大きなモデルを1枚に載せたい、FP4で推論を回せる、自前運用で電力とコストを管理できる、そんな条件で強みを発揮します[2][3]。H100は公式の学習・推論性能とデータシートを踏まえると、現役です[1][5]。次の課題は、Blackwellのソフトウェアの成熟と、電力込みの実効性能になりそうです[2][5]。
引用ソース
- Web記事 記事全文: Nvidia H100 Gpu — https://www.nvidia.com/en-us/data-center/h100/
NVIDIA H100 GPU
Extraordinary performance, scalability, and security for every data center.
An Order-of-Magnitude Leap for Accelerated Computing
The NVIDIA H100 GPU delivers exceptional performance, scalability, and secu - Web記事 記事全文: NVIDIA Blackwell B200 vs H100: Real-World Benchmarks, Costs, and Why We … — https://www.lightly.ai/blog/nvidia-b200-vs-h100
The B200 is up to 57% faster for model training than the H100, up to 10x cheaper to run when self-hosted, and we’ve broken down all the costs, performance metrics, and power consumption data inside.
Short on time? Below - Web記事 記事全文: NVIDIA B200: 192GB Specs, Benchmarks, vs H100 | Spheron — https://www.spheron.network/blog/nvidia-b200-complete-guide/
The NVIDIA B200 is the first data centre GPU built on the Blackwell architecture, and the successor to the H100 and H200. It carries 192GB of HBM3e memory at up to 8 TB/s of bandwidth, 208 billion transistors across a du
- Web記事 記事全文: Blackwell B200 Specs, Benchmarks & Pricing — NVIDIA Blackwell — https://gpuadvisor.com/gpu/b200
NVIDIA
Blackwell B200
4.5K FP8 · 192GB HBM3e · 1000W
89Score
Frontier TrainingAGI Research
Specifications
ArchitectureBlackwell
Memory192GB HBM3e
Memory Bandwidth8,000 GB/s
FP16 TFLOPS2,250
FP8 TFLOPS4,500
BF16 TFLOPS2,2 - Web記事 Web検索: Matching Workloads to Blackwell:Power-Resolved Benchmarking of NVIDIA … — https://arxiv.org/html/2610.41919v1
Matching Workloads to Blackwell:Power-Resolved Benchmarking of NVIDIA …
- Web記事 Web検索: NVIDIA Blackwell B200 vs H100: Real-World Benchmarks, Costs, and Self … — https://www.szwecent.com/nvidia-blackwell-b200-vs-h100-real-world-benchmarks-costs-and-self-hosting-insights/
NVIDIA Blackwell B200 vs H100: Real-World Benchmarks, Costs, and Self …
- Web記事 Web検索: B200 Training Benchmarks: Real Numbers for Pre-Training and Fine-Tuning — https://www.hyperbolic.ai/blog/b200-performance-deep-dive
B200 Training Benchmarks: Real Numbers for Pre-Training and Fine-Tuning
- Web記事 Web検索: PDF NVIDIA H100 Tensor Core GPU Datasheet – Aspen Systems Inc. — https://www.aspsys.com/wp-content/uploads/2023/09/nvidia-h100-datasheet.pdf
PDF NVIDIA H100 Tensor Core GPU Datasheet – Aspen Systems Inc.
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS