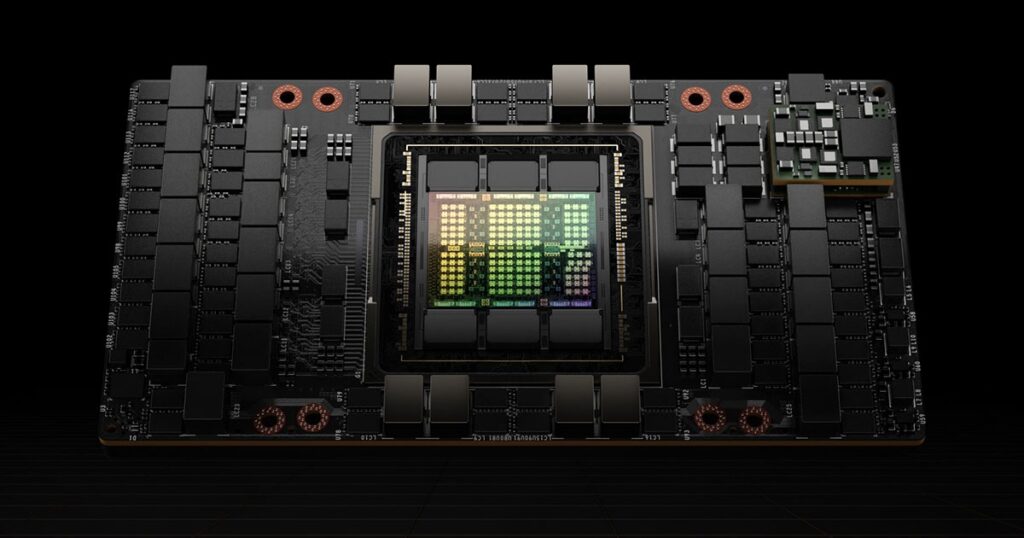
性能の差は、派手な演出ではなく数字で示されています。NVIDIAは、BlackwellアーキテクチャがMLPerf Training v5.1の7モデルすべてで最速の学習時間を記録したと報告しました[3]。7モデルは用途が広く、目標精度に達するまでの時間を測ります[3]。これはバージョン更新時のAIの学習速度を測る比較です。

以前取り上げたH100の公式値は、HopperとTransformer Engine(Transformerの計算を速くする仕組み)でLLM(大規模言語モデル)を最大30倍、GPT-3 175B学習を前世代比4倍とするものでした[1][2][5]。推論でも最大30倍とされています[1]。第四世代NVLinkはGPU間を900GB/sでつなぎ、データセンターでの拡張を前提としています[1][5]。HopperではGrace Hopper Superchipも示され、CPUとGPUを900GB/sで結び、PCIe Gen5(CPUとGPUをつなぐ規格)より7倍速い帯域を掲げています[2]。
今回の新しい論点は、Blackwellを細かく測った論文にあります。B200はH200と比べ、ResNet-50の混合精度学習(精度を混ぜて速くする学習)で1.85倍、GPT-1.3Bで1.55倍の学習スループット(処理量)を示しました[4][6]。エネルギー効率も32%向上したと報告されています[4][6][8]。
この論文は、Blackwellの性能が出る理由を、メモリ、Tensor Coreの処理経路、FP32からFP4までの浮動小数点の精度に分けて調べました[4][6]。対象は、行列計算の密な場合(要素をほぼ全部使う計算)や疎な場合(多くの要素がゼロの計算)、Transformerの推論と学習です。開発者がGPUの機能を使い切れるよう、オープンソースの測定ツールも公開されています[4]。論文は、性能の差がどこから来るかを測る手法自体が追いついていない問題も指摘しています[4]。
この差は、5世代目のTensor Core(行列計算を速くする専用回路)だけでなく、テンソルメモリ(計算用の高速な一時記憶)、データ圧縮を解凍する専用回路、2つのチップを1つに見せる設計などから来ています[4]。BlackwellはFP4という4ビットの浮動小数点もハードウェアで加速します。FP4はFP8(8ビットの浮動小数点)より1回の処理あたり2倍、Blackwell Ultraでは3倍の処理性能を掲げています[3]。
さらに、NVIDIA設計のNVFP4は、業界のMXFP4と比べて、同じデータセットで同じトークン(文章の単位)数なら精度が良く、同じ精度なら少ないトークンで済むとされています[3]。学習が速くなったことが示され、推論までの時間を短くする方向です。
ただし、注意点もあります。MLPerfの全項目最速は、NVIDIAがすべてのベンチマークに提出した結果です[3]。外部が同じ条件で並べて報告した結果とは限りません。また、Hopperの公式性能値は出荷前に変わる可能性が示されていました[2]。ローカル環境での実測ではなく、データセンター向けの比較です。
それでも、Blackwellの話題は、単に新しい世代が出たという話ではありません。FP4とNVFP4、そして省エネの実測が重なることで、AIの学習と推論の設計が変わった可能性があります。ハッカーが注目する可能性はありますが、公式資料ではセキュリティが強調されています[1]。
引用ソース
- Web記事 記事全文: H100 Gpu | Nvidia — https://www.nvidia.com/en-us/data-center/h100/
NVIDIA H100 GPU
Extraordinary performance, scalability, and security for every data center.
An Order-of-Magnitude Leap for Accelerated Computing
The NVIDIA H100 GPU delivers exceptional performance, scalability, and secu - Web記事 記事全文: NVIDIA Hopper Architecture In-Depth | NVIDIA Technical Blog — https://developer.nvidia.com/blog/nvidia-hopper-architecture-in-depth/
Today during the 2022 NVIDIA GTC Keynote address, NVIDIA CEO Jensen Huang introduced the new NVIDIA H100 Tensor Core GPU based on the new NVIDIA Hopper GPU architecture. This post gives you a look inside the new H100 GPU
- Web記事 記事全文: NVIDIA Blackwell Architecture Sweeps MLPerf Training v5.1 Benchmarks — https://developer.nvidia.com/blog/nvidia-blackwell-architecture-sweeps-mlperf-training-v5-1-benchmarks/
The NVIDIA Blackwell architecture powered the fastest time to train across every MLPerf Training v5.1 benchmark, marking a clean sweep in the latest round of results. As developers experiment with new architectures, and
- Web記事 記事全文: Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth … — https://arxiv.org/html/2512.02189v3
Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth Architectural Analysis
Abstract
As GPU architectures rapidly evolve to meet the overcoming demands of exascale computing and machine learning, the performanc - Web記事 Web検索: PDF NVIDIA H100 Tensor Core GPU Architecture – Advanced Clustering Technologies — https://www.advancedclustering.com/wp-content/uploads/2022/03/gtc22-whitepaper-hopper.pdf
PDF NVIDIA H100 Tensor Core GPU Architecture – Advanced Clustering Technologies
- Web記事 Web検索: Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth … — https://arxiv.org/pdf/2512.02189
Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth …
- Web記事 Web検索: Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth … — https://www.computer.org/csdl/proceedings-article/ipdps/2026/060200b026/2hJUx4SZ4Qw
Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth …
- Web記事 Web検索: Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth … — https://www.semanticscholar.org/paper/Microbenchmarking-NVIDIA%E2%80%99s-Blackwell-Architecture:-Jarmusch-Chandrasekaran/027eb35067ed681a5584480da306432f393f0fc1
Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS