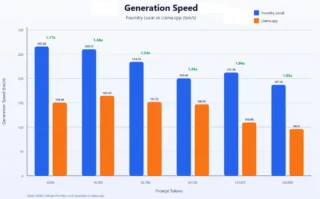
Foundry LocalはQwen3.8-27Bをローカルで動かし、GitHub Copilotに接続します。量子化で約18GB、24GBのGPUメモリで動作し、llama.cppより速いという報告があります。実用性と制約がわかります。
Foundry LocalはQwen3.8-27Bをローカルで動かし、GitHub Copilotに接続します。量子化で約18GB、24GBのGPUメモリで動作し、llama.cppより速いという報告があります。実用性と制約がわかります。
2026.11.06
続・NVIDIA:Blackwell論文が示すFP4と省エネの実測
2026.11.06
続・Qwen、ローカル実行と評価の落差を追う
2026.11.06
続・ThreadShelf、MCP連携でObsidian安全に
RECENT COMMENTS