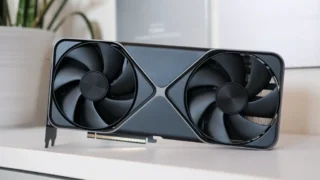
RTX 5090の話題が品薄からローカルAI推論へ移りました。Basalt 0.2.0は5090と5060 TiでQwen 3.8 Flash Nextを動かし、prefill 10K t/sと高速を示す一方、量子化で品質差が出ました。速度と品質、入手性が焦点です。
RTX 5090の話題が品薄からローカルAI推論へ移りました。Basalt 0.2.0は5090と5060 TiでQwen 3.8 Flash Nextを動かし、prefill 10K t/sと高速を示す一方、量子化で品質差が出ました。速度と品質、入手性が焦点です。
Hacker Newsで、古いTesla P100を2枚使いQwen3.8-27Bを約60tpsで動かした報告が話題に。V100向けにはソフト復号のNVFP4版も登場し、17.6GBの重みを2枚に分割して動きます。旧GPUで新モデルを動かすローカル推論の実例を整理しました。
ローカル推論エンジンcapy-flash v0.7.1が公開され、125B MoEのQwen3.8-Flash-Nextが64GB RAMで動くようになりました。16GB GPU2枚で234tok/s、1枚でも121tok/s。27Bは16GB GPU1枚で動き、品質のトレードオフも報告されています。

2026.11.12
Fireworks AIが2回目の侵害を通知、推論基盤の被害が拡大
2026.11.12
RTX 5080 24GB取消、GDDR7高騰がローカルAIに与える影響
RECENT COMMENTS