ローカルで動くモデルは、最上位のAPIモデルにどこまで迫れるのか。Redditのr/LocalLLaMAに投稿された検証が、その一つの答えです[1]。同じコーディングタスクを両者に解かせています。費用は0.32ドル対17.78ドル。約55倍の差です。それでいて完成度は69%対87%。この数字を順に読み解きます。
検証は、Qwen3.8-Flash-NextとClaude Opus 5.5を六通りの組み合わせで比べる試みです[1]。ポイントは、現実のタスクを課したことでした。お題はLlamaStashのロードマップにある実際の機能です。llama-serverのKVキャッシュを、メモリから退避する前に保存し、モデル復帰時に復元するRustでの実装でした。KVキャッシュは、推論を速くするための計算途中メモだと思ってください。ベンチマーク用の問題ではなく、実際に使えるコードを求める試験です。各組み合わせを2回ずつ実行し、計12本のPR(コード変更のまとまり)を作成。各PRを7つのレビュー質問と、CI(自動テスト)の合否で採点しました[1]。
結果の核心はこうです。Opus 5.5は、ハーネス(AIモデルを動かして作業させる外側の仕組み)にClaude Codeを組み合わせて試しました。努力レベル(思考の深さの設定)を「xhigh」にすると、8点満点中6.94点(87%)。43.5分かかり、17.78ドルです[1]。「medium」では6.25点(78%)、23.4分、6.52ドルでした[1]。一方のFlash-Nextは、同じClaude Code組み合わせのmediumで5.5点(69%)、45.3分、0.32ドル。ハーネスをPiに変えたxhighでも、5.44点(68%)、63.8分、0.67ドルです[1]。トークン数も対照的でした。Opusのxhighは入力507k、キャッシュ(再利用分)48.3M、出力203k。Flash-Nextのmediumは445k、13.5M、82kです[1]。比較にはKimi K3も登場しますが、素材の表は途中で切れており、成績までは確認できません。
Flash-Nextをどう動かしたかも、ローカル派には重要な情報です。投稿者は「Strix Halo」搭載ノートPC(ASUS Flow Z13)を使いました。量子化を施した約Q4のモデルを、Halogen経由で実行しています[1]。量子化は、モデル内部の数値の精度を落としてメモリを節約する技術です。この構成での実測の推論速度(TPS)や消費電力は、素材には見つかりませんでした。モデルは2026年8月登場で、ライセンスはQwen Community License 1.0。自己ホストやファインチューニング(追加学習による調整)ができる点が、API専用モデルとの大きな違いです[2]。
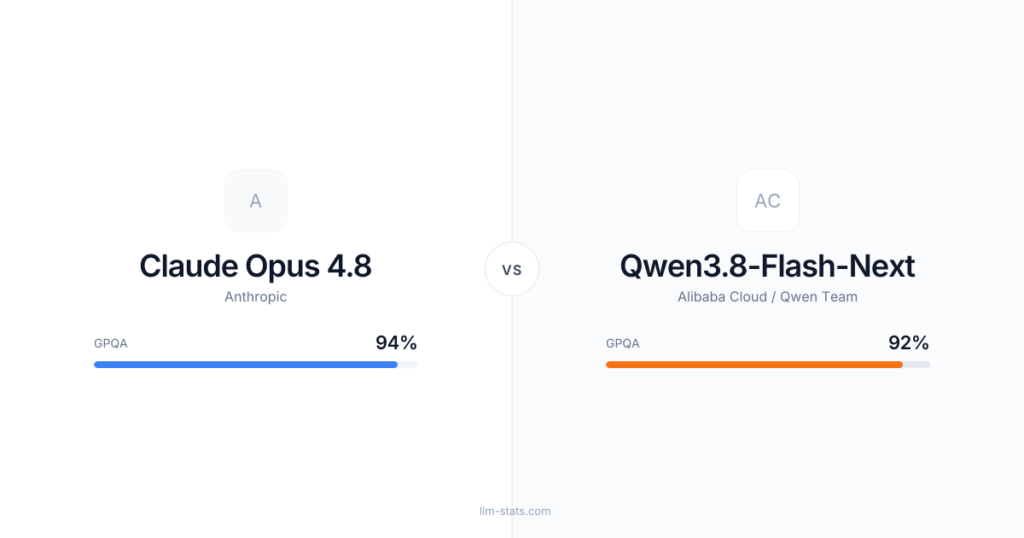
公開ベンチマークの集計でも、同じ構図が見えます。llm-statsの比較ページによれば、Qwen3.8-Flash-Nextの総合スコアは48.1です[4]。一つ前のOpus 4.6は44.5。総合ではFlash-Nextが上で、共通4ベンチマーク中3つも勝っています[4]。ところが最新のOpus 4.8は49.8。形勢が逆転し、共通7ベンチマーク中5つを奪われました[2]。内訳も具体的です。4.6に勝ったのはCharXiv-R、GPQA、SWE-bench Multilingualの3つ。4.8にはDeepSWE 1.1やHumanity’s Last Examなどで及ばず、CharXiv-RとToolathlonで優位を保ちます[2][4]。Opus 4.8は入力100万トークンの文脈を明示しています[2]。Opus 4.6の価格は、100万トークンあたり入力5ドル・出力25ドルでした[4]。
ここで冷静になりたいのは「安さの代償」です。Flash-Nextはスコアで約18ポイント劣るだけでなく、所要時間もOpus 5.5のmedium(23.4分)より長い45.3〜63.8分です[1]。コストは55分の1でも、待ち時間は数倍。実用ではこのトレードオフが効いてきます。文脈長でもOpus側が先行しています[2]。ちなみにこの検証、初回は比較条件が公平でないという指摘を受け、Redditから削除されました。投稿者はハーネスと努力レベルをそろえてやり直した、という経緯があります[1]。
周辺の動きも見逃せません。Qwen3.6-35B-A3Bをベースにした35BのMoEモデル「Sage-A1.5」が公開され、量子化したGGUF形式のモデルファイルで配布されています[3]。長時間の科学問題解決向けの作りです。タスクを、文脈を分けたサブエージェント(作業を分担する小さなAI)に委任し、並行処理します。進捗確認と証拠検証で戦略を修正します[3]。ベースモデルのファインチューニングがすぐ現れるのは、オープンウェイト(モデルの中身が公開された形式)ならではの広がりでしょう。Qwen 3.5系のラインナップ(35B-A3B、27B、122B-A10B、397B-A17B)を解説するローカルAIガイド[5]や、ローカルでのAIコーディング環境をまとめたGitHubリポジトリ[6]も増えています。今回の比較は、他のニュースサイトでも取り上げられました[5][6]。
まとめると、オープンウェイトのQwen系は、実タスクで最上位モデルに肉薄する完成度を、費用一桁違う条件で実現しつつあります。ただし絶対的な品質と速度では、最新のクローズドモデルがまだ上です。費用を大きく削るか、時間と最高品質を取るか。12本のPRが示したのは、その選択がいまや現実の選択肢になった、ということです。


RECENT COMMENTS