12GBのゲーミングGPUで125Bモデルを動かせる専用推論エンジン、それがStrataです。その速さに対抗する動きが、今度はllama.cpp側から出てきました。Redditのr/LocalLLaMAには、R9700でStrataのdecode性能を上回ると題するllama.cppのPRが紹介されています[1]。decodeとは、トークンを1つずつ生成する処理のことです。
Strataは、Qwen3.8-Flash-Nextという1つのモデルファミリー専用に作られたオープンソースの推論エンジンです。10月4日にはハッカーニュースのフロントページに「RTX 4090で125Bモデルを100トークン/秒で動かす」として登場し、大きな話題になりました[3]。1つのモデルに絞り込むことで、汎用エンジンでは出せない速度を引き出すのが狙いのようです。
その実力を、安価な環境で確かめた検証が参考になります。動画で7.5倍のprefill高速化を報告していたCodacusの主張を、RTX 3060 12GB、PCIe 3.0、Core i7-7700、メモリ32GBという手頃な構成で追試したのです[2]。プロンプト(入力)を読み込むprefillの速度は、標準のllama.cppがどの長さでも158トークン/秒。一方Strataは933〜1,094トークン/秒で、差は5.9〜6.9倍でした。32Kトークンのプロンプトで最初のトークンが出るまでの時間は、標準が208秒、Strataが30秒です。llama.cppも読み込み単位に関する2つの設定を変えるだけで80秒まで短縮できますが、それでもStrataには及びません[2]。3090での比較でも、Strataが78トークン/秒、llama.cppが18トークン/秒という報告があります[7]。
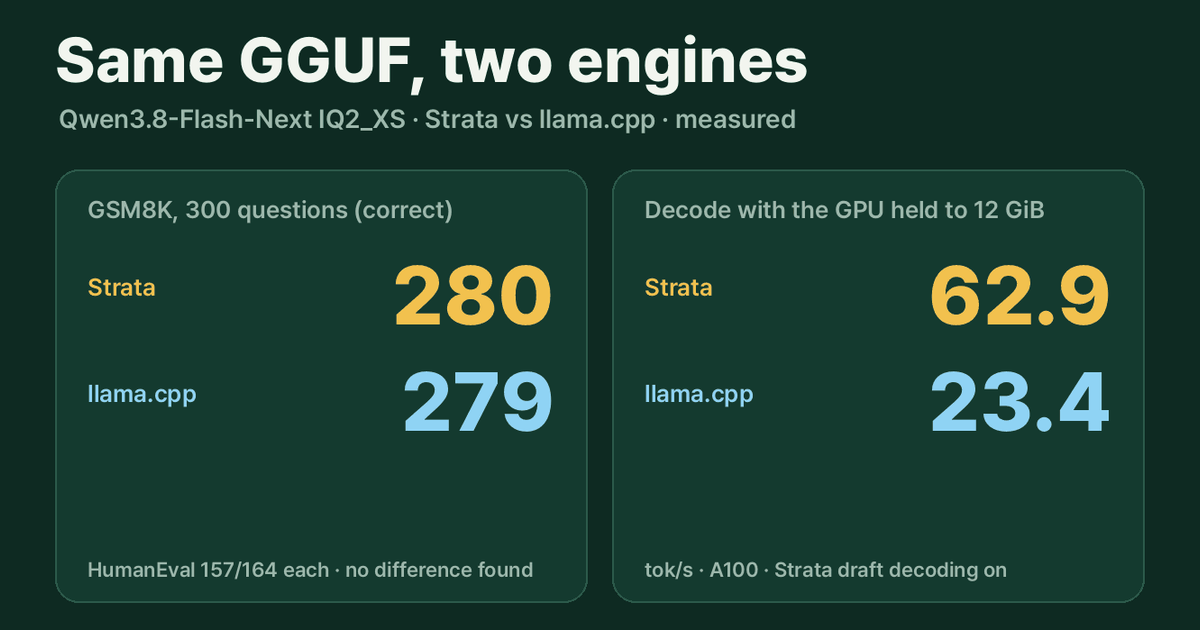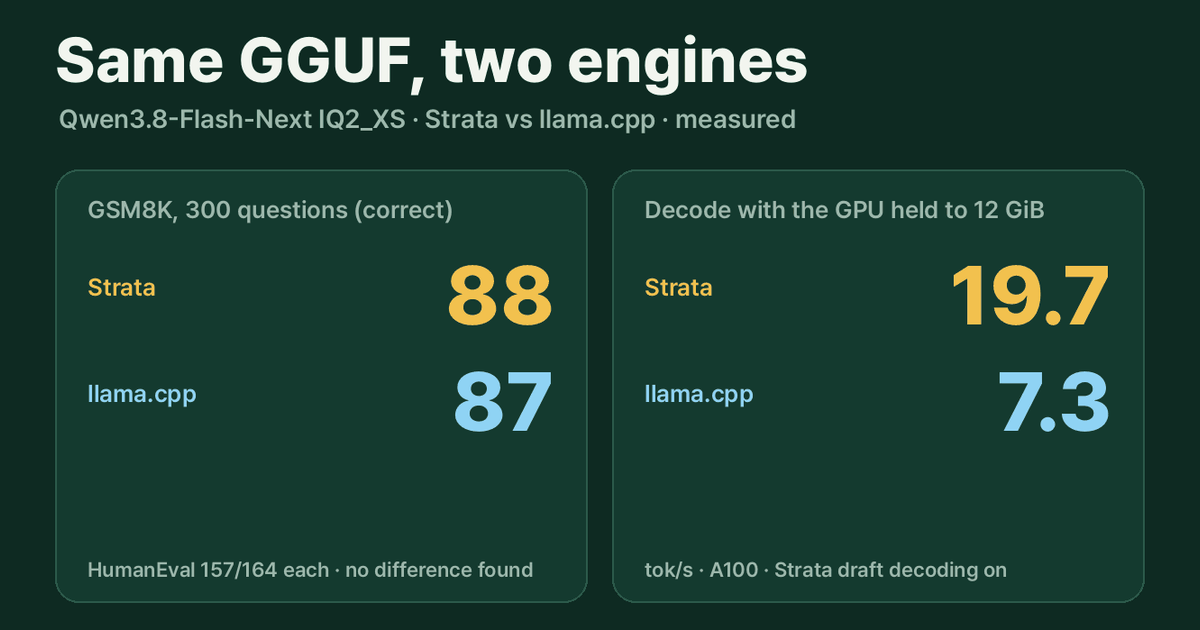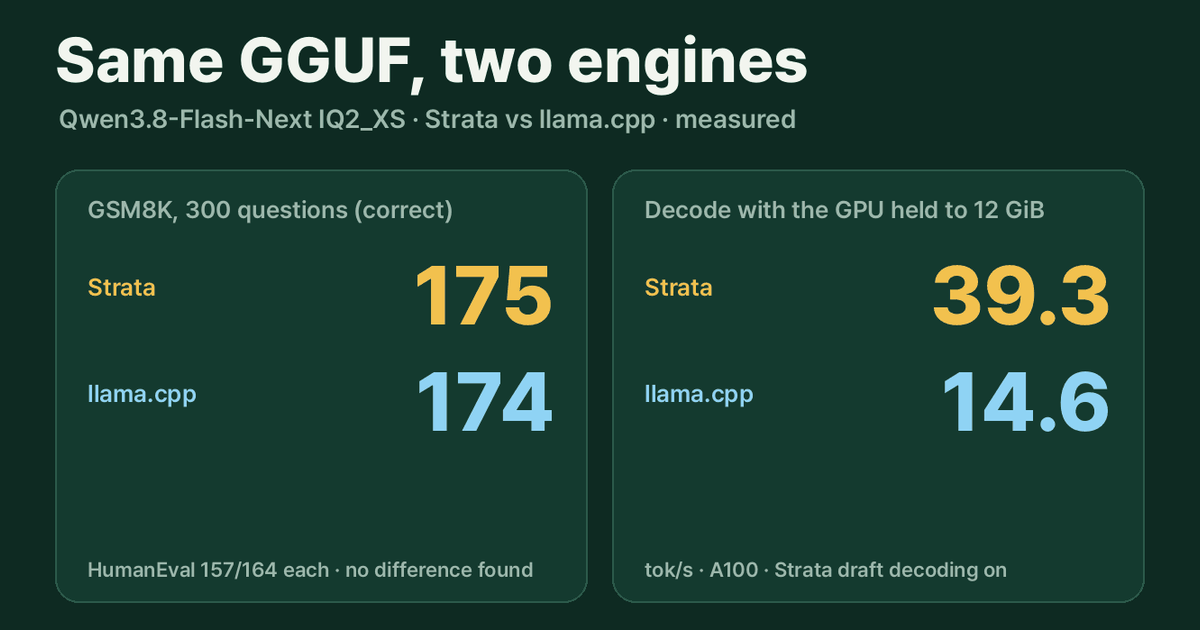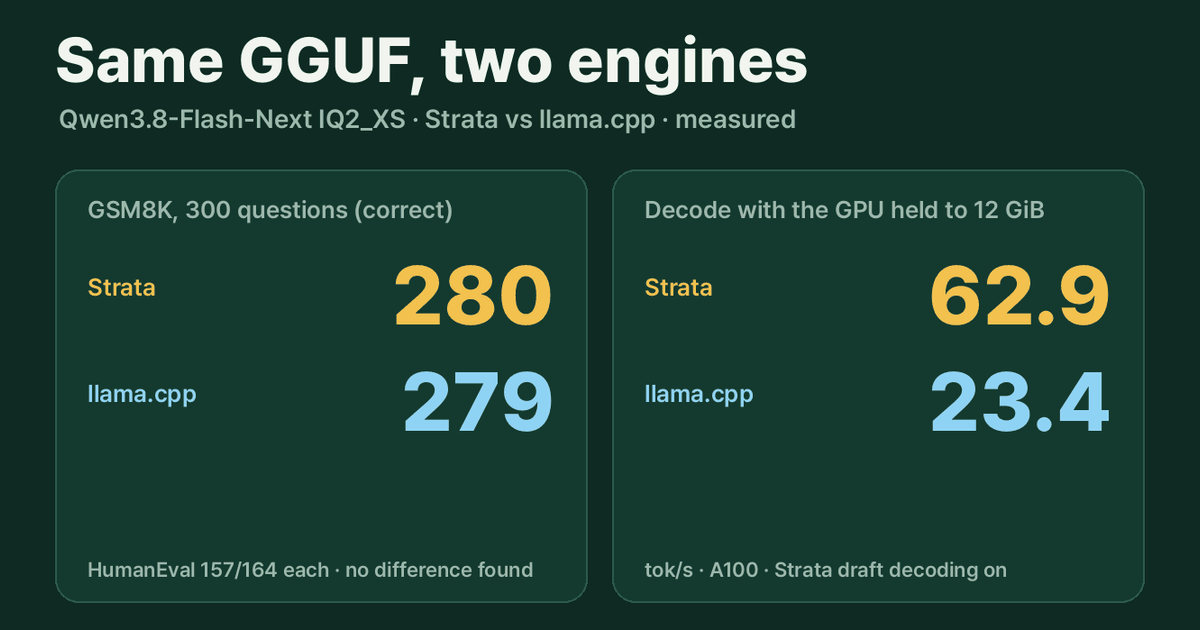
速度だけでなく、精度への影響も確かめられています。モデルはllama.cppでも動く標準的なGGUF形式です。同じIQ2_XSという量子化タイプ(重みを圧縮してメモリを節約する仕組み)のファイルを両エンジンで動かしたところ、GSM8Kは280/300対279/300、HumanEvalは両者とも157/164で、スコアの差は出ませんでした[3]。ハッカーニュースでは「答えの質が落ちる」という声や、画像の指差し精度が3倍悪いという報告もありました。しかし100枚のCOCO画像での検証では、ミスの中央値が37.6ピクセル対37.7ピクセルと、この差は再現しなかったのです[3]。検証者いわく、スコアや再現性の結果は環境が変わっても通用しますが、速度の数値は環境依存だといいます[3]。
一方で、GPUのメモリを約12GiBに制限すると、速度差はさらに広がります。decodeはStrataが62.9トークン/秒、llama.cppが23.4トークン/秒。29Kトークンのプロンプト読み込みは2,726対275トークン/秒でした[3]。ただし、ここで思わぬ落とし穴が見つかっています。ランダム性をゼロにした設定で同じ質問を3回繰り返したところ、Strataは30問中12問しか完全に同じ答えを出せなかったのです。llama.cppは30問すべてで同一でした。Strata側もこの挙動をドキュメントに記載し、設定で解消できますが、その代償はdecode速度の約4分の1だといいます[3]。速さと安定性のトレードオフが、実用では効いてくるようです。
そんな中で登場したのが、冒頭のPRです。AMDのRadeon AI PRO R9700を使い、llama.cppでStrataを上回るdecode性能を目指す試みで、VulkanというAPI経由でR9700を動かすllama.cppの構成をまとめたリポジトリも公開されています[1][6]。残念ながら、今回の素材からはPR自体の具体的な速度数値を読み取ることはできませんでした。とはいえ、llama.cpp側の追い上げは複数の形で進んでいます。StrataのGitHubリポジトリには、llama.cppの#30553がRTXでのIQ3_S(量子化タイプの1つ)のスループットを改善したというベンチマーク報告がissueとして上がっています[4]。Strata自身もv0.1.42で、RTX 4090の16Kトークンprefillで5,200トークン/秒、decodeで164トークン/秒を記録しました[5]。
専用エンジンの登場が、汎用エンジンの最適化を促す好循環が生まれているようです。Strataが速さの基準を示し、llama.cppがPRで追いかける。その競争のたびに、ローカル推論の到達点が上がっています。数値は構成や設定で大きく変わるため、自分のGPUで両方を動かして比べてみるのが、いま一番実用的な一歩だといえそうです。
引用ソース
- Reddit Reddit r/LocalLLaMA: Llama.cpp PR: How to beat strata decode performance with a R9700 — https://www.reddit.com/r/LocalLLaMA/comments/1xcf8kb/llamacpp_pr_how_to_beat_strata_decode_performance/
Llama.cpp PR: How to beat strata decode performance with a R9700
- Web記事 記事全文: Strata vs llama.cpp on a 3060: The 7x Is Real. Two Flags Halve It — https://insiderllm.com/guides/strata-vs-llama-cpp-rtx-3060/
📚 More on this topic: A 177B Model on a 3060: The 32 GB Number · Every SSD-Streaming MoE Engine · MoE Models Explained · What Can You Run on 12GB VRAM · InsiderLLM Benchmarks
Run a 125B mixture-of-experts model on a 12 G - Web記事 記事全文: Strata vs llama.cpp on the Same Qwen3.8-Flash-Next File: No Score … — https://sotaaz.com/post/strata-qwen-flash-next-llamacpp-en
Strata vs llama.cpp on the Same Qwen3.8-Flash-Next File: No Score Difference Found, Faster Within 12 GiB
Strata reached the front page of Hacker News on 4 October under the title “Run Qwen 3.8 Flash Next (125B) on consum - Web記事 Web検索: [Benchmark] llama.cpp #30553 improves IQ3_S throughput on RTX … – GitHub — https://github.com/Niko1221/Strata/issues/3724
[Benchmark] llama.cpp #30553 improves IQ3_S throughput on RTX … – GitHub
- Web記事 Web検索: Strata v0.1.42 now: 5.2K t/s prefill @16K, 164 t/s decode on RTX 4090 … — https://gist.github.com/ryan4yin/48617bbddacc7067f10799770b7cc33f
Strata v0.1.42 now: 5.2K t/s prefill @16K, 164 t/s decode on RTX 4090 …
- Web記事 Web検索: GitHub – aguaishuo/AMD-Radeon-AI-PRO-R9700-llama-cpp-Vulkan-MTP: AMD … — https://github.com/aguaishuo/AMD-Radeon-AI-PRO-R9700-llama-cpp-Vulkan-MTP
GitHub – aguaishuo/AMD-Radeon-AI-PRO-R9700-llama-cpp-Vulkan-MTP: AMD …
- Web記事 Web検索: Qwen3.8 Flash-Next on a 3090: Strata 78 tok/s vs llama.cpp 18 — https://insiderllm.com/guides/strata-vs-llama-cpp-rtx-3090/
Qwen3.8 Flash-Next on a 3090: Strata 78 tok/s vs llama.cpp 18
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。


RECENT COMMENTS