llama.cppの切替高速化は、モデルの読み直しよりKV cacheの再利用へ移っています。2秒以内のスリープやキャッシュ再利用が話題ですが、–cache-ramの誤解やキャッシュ圧縮の速度低下が落とし穴です。構成とキャッシュ設計の重要性がわかります。
llama.cppの切替高速化は、モデルの読み直しよりKV cacheの再利用へ移っています。2秒以内のスリープやキャッシュ再利用が話題ですが、–cache-ramの誤解やキャッシュ圧縮の速度低下が落とし穴です。構成とキャッシュ設計の重要性がわかります。
StrataでQwen3.8 Flash Nextの量子化モデルをRTX 4080で動かし、モーション動画を生成した報告が話題です。decodeは約95、prefillは約3000トークン/秒で、完成に約2時間です。名称の広がりも読み解きます。
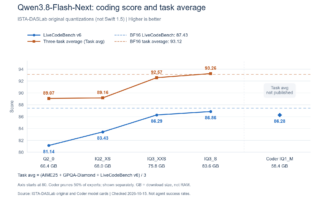
StrataでQwenの小型から大型まで試した結果、VRAMを超える構成でprefillとdecodeが伸びる分岐点が示されました。RTX 3060では35B以上のMoEで最大約2倍、RTX 5060 Tiでは軽い量子化が65.55トークン/秒です。
改造RTX 3080の追跡記事。4枚構成の実測ではQ8+MTPでdecode約95 tok/s、8×RTX 5060 Ti構成の2.4倍に達しました。さらに計算制限を解除する新modでprefill約20%向上、decodeは不変という結果も報告されています。
RTX 3080 20GBで、NVIDIAが無効化していたP2PとreBARを有効化する改造が話題です。tensor parallel時のプロンプト処理が70%、prefillが約20%速くなる一方、decodeは変化なしです。RTX 20〜40シリーズへ広がるコミュニティ改造の実力と限界を整理します。
ローカル推論エンジンStrataで、16GB VRAMのGPUと55GBのRAMだけでQwen3.8-Flash-Nextが最大250 tok/sで動く実測が報告されました。一方、SSDから直接読み込む新方式は8GBのRAMで約20 tok/sを実現しています。速度と省メモリ、どちらを取るか選択肢が広がりました。
125Bモデルを12GB GPUで動かす専用推論エンジンStrataに対し、llama.cpp側がAMD R9700向けPRでdecode速度の逆転を狙う動きが話題です。3060や3090の検証ではStrataが最大7倍近く速い一方、回答の再現性に課題も見つかりました。専用と汎用エンジンの競争が加速しています。
AMDのGPU「Radeon AI PRO R9700」でllama.cppの性能を引き出す動きが話題です。まとめ処理の設定見直しだけでQwen3 122Bが15 t/sから40 t/s、2つの工夫で48 t/sに向上。一方、特定設定では逆に速度が落ちる落とし穴も判明しました。

2026.11.12
Fireworks AIが2回目の侵害を通知、推論基盤の被害が拡大
2026.11.12
RTX 5080 24GB取消、GDDR7高騰がローカルAIに与える影響
RECENT COMMENTS