「自分の推論エンジンをvibe codingで作るのは簡単だと言われていたのに」——Redditのr/LocalLLaMAに、こんな自嘲まじりの投稿が上がっています[1]。vibe codingは、AIに頼んでコードを書かせる作り方です。投稿者が作ったのは、HTMLの中で直接動く推論エンジンでした。モデルはGGUF形式(llama.cpp系で使われるモデルのファイル形式)で、Q4と呼ばれる4ビットの量子化を施しています。量子化は、重みを圧縮してメモリを節約する仕組みです。計算はWebGL2のコンピュートバッファにGLSL(シェーダ言語)で展開し、ブラウザのページの中でLLMを動かします。どこかハッカーらしい試みです[1]。
なぜ今、推論エンジンの自作が増えているのでしょう。技術ブログには、純Pythonでゼロから作るチュートリアルが公開されました[2]。そこでは、推論は4段階でできていると説明されます。まずプロンプトをトークンIDに変換します。次にprefill(プロンプト全体を一括処理する段階)に入り、各層の計算結果をKVキャッシュに蓄えます。KVキャッシュは、計算済みの結果を保存してやり直さない仕組みです。最後にdecode(トークンを1つずつ生成する段階)で次のトークンをサンプリングし、モデルが終端を示すトークンを出すまで繰り返します[2]。Hugging Faceのmodel.generate()も、OpenAI APIの一行も、この流れを隠しているだけだというわけです[2]。
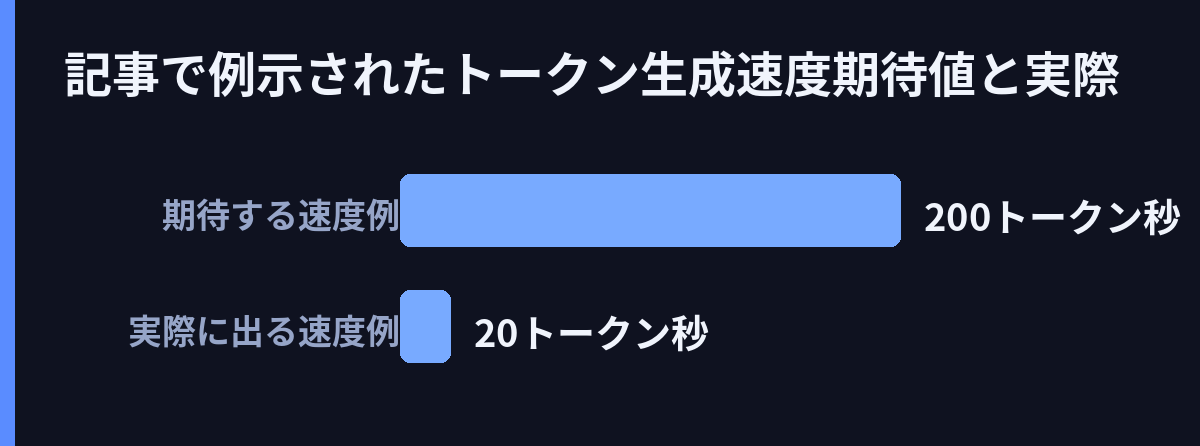
このブログの成果物は、約200行のPythonスクリプトです。重みが公開された小さなモデルを読み込み、プロンプトを受け取り、KVキャッシュを使いながらトークンを1つずつストリーミングします[2]。筆者は、APIの一行の裏で何が起きているか見えないからこそ、自作する価値があると説明します。例として挙げられるのが、期待では200トークン/秒なのに20トークン/秒しか出ない場面です。長いコンテキストでGPUのメモリが足りなくなる(OOM)場面も同じです[2]。
さらに、2人のユーザーが同じインスタンスでセッションを共有すると、理由がわからないまま互いに待たされるという例も出てきます[2]。こうした問題は、推論エンジンが何をしているかを見たことがなければ理解できないといいます。記事はその先で、vLLMやHugging Face TGI、NVIDIA TensorRT-LLMといった本番システムが、各段階をどう最適化しているかにも接続しています[2]。
学習教材も充実してきました。無料の学習パスでは、1つのトークンの旅を追います[4]。まずBPE(頻出する文字のペアを順に統合してトークンを作る方式)で、モデルが実際に何を読んでいるかを確かめます。トークンコストやコンテキスト上限、モデルがstrawberryのrを数えられない理由も、ここで分かるようになります[4]。そのあとは、トークンIDをベクトルに変える埋め込み、Transformerの論文、位置情報を扱うRoPEへと進みます[4]。softmaxと層正規化が数値を安定させ、cross-entropyは「正解の次トークンにモデルがどれだけ驚いたか」を測ります[4]。スケーリング則(モデルとデータを増やすほど性能が予測どおり伸びる法則)や、好みを学ばせる選好訓練も範囲です[4]。
日本語でも同じカルチャーの動きが見えます。Qiitaには推論エンジンを自作し、公式実装と誤差ゼロで再現して構造を覗いたという記事が投稿されています[5]。GitHubにも、llm-inferenceを含む「building-from-scratch」リポジトリがあります[5]。別の個人ブログでも、ゼロから推論エンジンを作る手順がまとめられています[7]。ローカルLLM推論を速くするOSSエンジン、vLLMを解説する記事もQiitaで読めます[5]。Xの日本のトレンドには「パーソナルAIエージェント」が名を連ねており[3]、AIを手元で動かして中身まで理解したい需要の表れと思われます。
しかし、熱狂の裏には落とし穴もあります。投稿者は、文章をトークンIDに分割するトークナイザと語彙の処理が「終わらないデバッグ地獄の一部」だったと振り返ります[1]。4段階の理屈は単純でも、実装の細部は膨大に積み上がるようです。だからこそ投稿者の結論は、「素直にllama.cppをcloneしたほうがいい」という実用的な一言でした[1]。200行の試作と本番エンジンの差は、各段階の最適化の深さにあるようです[2]。
自作推論エンジンの流れは、AIをブラックボックスのまま使う人と、中身まで追いたい人とで、道が分かれ始めているようにも見えます。全員が作り切る必要はありません。それでも一度4段階を追うだけで、APIの速度やメモリの挙動が読めるようになります[2]。まず完成品のllama.cppやvLLMを読み、それから自分の200行を書く。それが今のところの最短ルートのようです[1]。
引用ソース
- Reddit Reddit r/LocalLLaMA: Vibecoding your own inference engine is easy they said — https://www.reddit.com/r/LocalLLaMA/comments/1xdh57e/vibecoding_your_own_inference_engine_is_easy_they/
Vibecoding your own inference engine is easy they said
- Web記事 記事全文: Build Your Own Inference Engine: From Scratch | martinuke0's Blog — https://martinuke0.github.io/posts/2026-09-01-build-your-own-inference-engine-from-scratch/
TL;DR — A working LLM inference engine is just four stages: tokenize the prompt, run a forward pass through transformer blocks while filling a KV cache, sample the next token, and repeat until the model emits an end-of-s
- X Xトレンド: パーソナルAIエージェント — https://trends24.in/japan/
パーソナルAIエージェント
- Web記事 記事全文: Build an LLM From Scratch — A Free Learning Path | Vibe Engines — https://vibeengines.com/learn/llm-from-scratch
How this path works
This path is for engineers who use language models every day and want to know what happens between the prompt and the next token: application developers tired of treating the model as a black box, ML - Web記事 Web検索: building-from-scratch/llm-inference at main · garg-aayush … – GitHub — https://github.com/garg-aayush/building-from-scratch/tree/main/llm-inference
building-from-scratch/llm-inference at main · garg-aayush … – GitHub
- Web記事 Web検索: 作って分かった Llm の中身【技術版・完全版】― 推論エンジンを自作し、公式実装と誤差ゼロで再現して覗いた構造の全て — https://qiita.com/furuse-kazufumi/items/de27af958332c9c38e33
作って分かった Llm の中身【技術版・完全版】― 推論エンジンを自作し、公式実装と誤差ゼロで再現して覗いた構造の全て
- Web記事 Web検索: Building an LLM Inference Engine 'From Scratch' — https://sushantvema.github.io/notes/llm_inference_engine
Building an LLM Inference Engine 'From Scratch'
- Web記事 Web検索: vLLMってなんだ? 〜ローカルLLM推論を爆速化するOSSエンジンの全貌と実践ガイド〜 #AI – Qiita — https://qiita.com/GeneLab_999/items/5d74e25bb72e1c3b1b61
vLLMってなんだ? 〜ローカルLLM推論を爆速化するOSSエンジンの全貌と実践ガイド〜 #AI – Qiita
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS