「バイブコーディングで推論エンジンを自作するのは簡単だ」。そんな言葉を皮肉った投稿が、Redditで注目を集めています[1]。AIに実装を任せる「バイブコーディング」で、実際にブラウザの中で動くLLMを作ったという報告です。以前このシリーズでは、自作推論エンジンの難所がトークナイザのデバッグ地獄であることをお伝えしました。その後も挑戦は止まらず、実装のやり方に幅が出てきています。
投稿者が作ったのは、HTMLファイルの中で直接動く推論エンジンです。モデルはGGUF形式(llama.cppなどで使われる保存形式)で読み込みます。重みはQ4という4ビットの量子化(重みを圧縮してメモリを節約する仕組み)で圧縮されています[1]。それをページングのように、WebGL2(ブラウザでGPUを動かすための標準規格)の埋め込み計算バッファへ展開しました[1]。計算そのものはGLSLというGPU向け言語で書かれています[1]。ブラウザさえあれば動くため、専用の実行環境が不要になるのが狙いのようです。ただし投稿者自身は、トークナイザと語彙の処理が「終わらないデバッグ地獄の一部だった」と振り返っています[1]。そのうえで「素直にllama.cppをクローンしたほうがいい」と結んでいます[1]。
GitHubでは、フレームワークに一切頼らない「byollm」というプロジェクトも公開されています[3]。PythonとNumPyだけですべての計算を書き、実際のGGUFファイルを読み込んで動かします。PyTorchもllama.cppのバインディングも使いません[3]。動作確認に使うのは260Kパラメータの小さなLlamaモデル(約1MB)です[3]。構成は5ブロック、埋め込み64、コンテキスト512、語彙512という規模です[3]。アテンション(どの単語に注目するかを決める計算)のヘッドは8つです[3]。そのうちKVキャッシュ(計算済みの情報を保存して再利用する仕組み)用は4つです[3]。データの並び方から量子化の復元、アテンションの計算まで、すべてコードとして読めるのが売りです[3]。
解説記事も増えています。あるブログは、推論エンジンの動きを4段階に分解し、純Pythonで約200行の実装を作る手順を紹介しました[2]。普段はHugging Faceのmodel.generate()やAPIの1行呼び出しに隠れている部分です[2]。最初にプロンプトをトークンに変換します。次にprefill(プロンプト全体を一括処理する段階)でKVキャッシュを埋めます。その後はdecode(トークンを1つずつ生成する段階)を、終端トークンが出るまで繰り返します[2]。記事はこの知識を、vLLMやTensorRT-LLMといった実戦用エンジンが各段階をどう最適化しているかの考察にも結び付けています[2]。
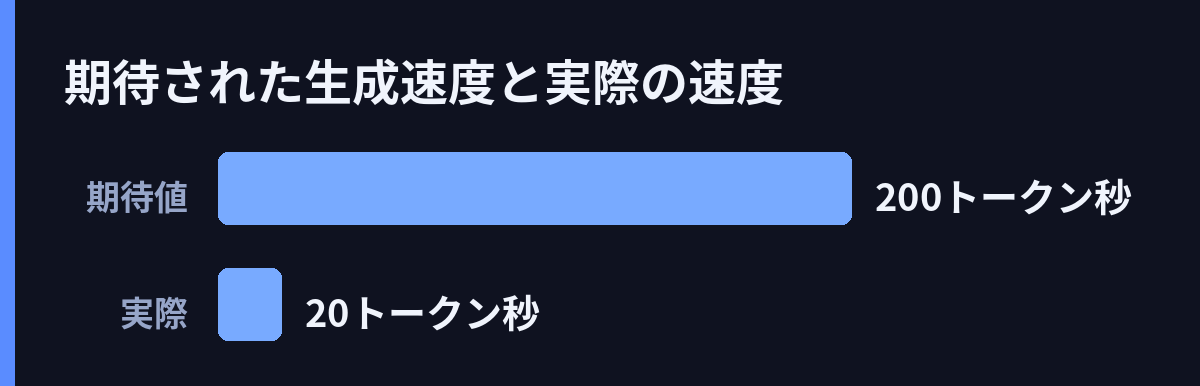
しかし、自作には明確な壁もあります。同じブログは「期待では200トークン/秒なのに20トークン/秒しか出ない」という速度の問題を挙げています[2]。以前お伝えした記事でも、同じ20トークン/秒の例が紹介されていました。長いコンテキストでGPUメモリが足りなくなる問題[2]や、2人のユーザーが1つのインスタンスを共有したとき、理由も分からず片方が待たされる問題も同じ記事にあります[2]。さらに「なぜ創業者は自作推論エンジンのバイブコーディングに失敗し続けるのか」と題した記事[4]や、LLM支援コード生成の教訓をまとめた記事[4]も出ています。勢いだけでは乗り越えられない難しさが、あらわになってきたようです。
一方で、学ぶための資源も整ってきました。LLMをゼロから作る無料の学習パスを公開するサイト[4]や、Mediumに投稿された体験記[4]も登場しています。byollmの作者は「フレームワークのバインディングも、変換済みチェックポイントも、魔法もない」と述べ、読んで理解して拡張できる本物のエンジンを目指しています[3]。ブログの筆者も、推論エンジンが何をしているかを見なければ、速度やメモリの問題は理解できないと説明します[2]。
自作推論エンジンの役割は、本番環境の置き換えではなく、仕組みを体得する教材になりそうです。ブラウザで動かす試みも、純Pythonでの再実装も、手間はかかっても理解が手に入る挑戦です。実運用ではvLLMなど最適化されたエンジンに頼り、学習では自作に触れる、という棲み分けが進んでいくと思われます。
引用ソース
- Reddit Reddit r/LocalLLaMA: Vibecoding your own inference engine is easy they said — https://www.reddit.com/r/LocalLLaMA/comments/1xdh57e/vibecoding_your_own_inference_engine_is_easy_they/
Vibecoding your own inference engine is easy they said
- Web記事 記事全文: Build Your Own Inference Engine: From Scratch | martinuke0's Blog — https://martinuke0.github.io/posts/2026-09-01-build-your-own-inference-engine-from-scratch/
TL;DR — A working LLM inference engine is just four stages: tokenize the prompt, run a forward pass through transformer blocks while filling a KV cache, sample the next token, and repeat until the model emits an end-of-s
- Web記事 記事全文: byollm — Build Your Own LLM Inference Engine From Scratch — https://github.com/Luv-Goel/byollm
A from-scratch, dependency-light LLM inference engine that reads real GGUF model files and runs the forward pass in pure Python + NumPy. No PyTorch, no llama.cpp bindings — just the format, the math, and the code.
byollm - Web記事 Web検索: Why founders keep failing to vibecode their own LLM inference engine — https://startupfortune.com/why-founders-keep-failing-to-vibecode-their-own-llm-inference-engine/
Why founders keep failing to vibecode their own LLM inference engine
- Web記事 Web検索: Navigating Vibe Coding: Lessons from LLM‑Assisted Code Generation — https://www.linkedin.com/pulse/navigating-vibe-coding-lessons-from-llmassisted-code-lance-harvie-pezsc
Navigating Vibe Coding: Lessons from LLM‑Assisted Code Generation
- Web記事 Web検索: Build an LLM From Scratch — A Free Learning Path | Vibe Engines — https://vibeengines.com/learn/llm-from-scratch
Build an LLM From Scratch — A Free Learning Path | Vibe Engines
- Web記事 Web検索: "I Built an LLM Inference Engine from Scratch – Medium — https://medium.com/@Rishavtalks/i-built-an-llm-inference-engine-from-scratch-heres-what-i-learned-832113de2300
"I Built an LLM Inference Engine from Scratch – Medium
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS