ローカルLLM界隈で「Strata」という名前をよく見かけるようになりました。ところが調べてみると、この名前の下に少なくとも3つの別物がひしめいています。
ひとつは長文の推論を支えるキャッシュ基盤のStrata[3]。もうひとつは大規模MoEモデルを動かすエンジンとして人気が上がっているStrata LLM[4]。さらに量子化研究のQ-Strataという論文もあります[2]。今回は、それぞれ何が新しいのかを整理します。
まず基盤のStrataから。長いコンテキストを扱うと、会話履歴を再計算せずに済ませるKVキャッシュ(過去の計算結果を保存しておくデータ)がGPUメモリに収まらなくなります。そこでCPU側にもキャッシュを置く「階層化」が定番ですが、ページ化された配置のせいでI/Oが断片化し、帯域をフルに使えません。既存のスケジューラはキャッシュ読み込みの遅延を考慮しないため、システム全体が計算ではなく転送待ちで律速されるのが実情でした[3]。
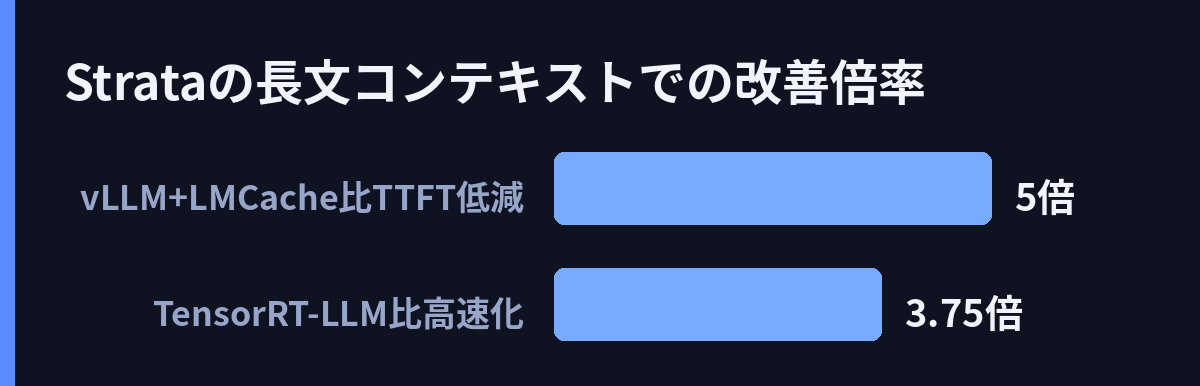
StrataはGPUとCPUのメモリ配置を分離して断片化を避け、キャッシュ読み込みの遅延を考慮したリクエストスケジューリングで、どうしても待つ時間を他の処理と重ねます。SGLangベースで構築され、本番環境にも展開済みです[3]。OSDI ’26の論文としても公開されました[5]。結果は、vLLM + LMCache比でTTFT(最初のトークンが出るまでの時間)を最大5分の1に低減、NVIDIA TensorRT-LLM比で最大3.75倍の高速化。短いコンテキストの性能は劣化しないとしています[3]。
一方、エンジン側のStrataで話題になっているのが「Gyro」という量子化(重みを圧縮してメモリを節約する仕組み)です。Reddit r/LocalLLaMAの投稿者がGyroのコードを実際に読み、既存のEXL3との比較表を作りました[1]。それによると、両者はQTIP/Trellis符号化という同じ系統の手法で、Hadamard回転(行列の向きを入れ替えて圧縮誤差を減らす前処理)も共通です。GyroはTrellis状態サイズが15ビット(EXL3は16ビット)、符号化の単位は128重みのブロック(EXL3は256重みのタイル)です。圧縮後の値を戻す対応表(コードブック)も、Gyroは2,048点の明示的なテーブル、EXL3は手続き的な生成と、作り方が違います[1]。EXL3は主要な量子化フォーマットの比較記事でも名前が挙がる定番です[7]。投稿者の結論は「EXL3の別フレーバーに見える」というものでした[1]。
しかし、ここに転があります。投稿者いわく、GyroがEXL3よりdecode(トークンを1つずつ生成する段階)の速度やperplexity(予測のあいまいさを示す指標で、低いほどよい)で優れているという公開された証拠は見つからなかったといいます[1]。レシピは今のところクローズドソースで、他フォーマットとの相互運用性も示されていません[1]。人気の理由は実測の優位性ではなく、Strataをはじめ複数のエンジンが採用したことによる浸透のようです[1]。
なお、名前がそっくりなQ-Strataは別物です。MoEモデルの混合精度量子化(層ごとにビット幅を変える圧縮)の研究で、MoEは各ブロックの各エキスパートに線形層があるため、割り当ての探索空間がdenseモデルよりはるかに大きくなる課題を扱います[2]。内側の段階で各ブロックの候補を予算別に整理し、外側は全線形層のビット幅ではなくブロックごとの予算を1つ決めるだけで済む二段構えです[2]。Mixtral-8x7B-Instruct、Qwen1.5-MoE-A2.7B、DeepSeek-V2-Liteの実験では、低ビット域でGPTQやMxMoE、GEMQより低いWikiText2 perplexityを達成しました[2][6]。検索では基盤のStrataと混ざりやすい存在です。
Strata LLMのドキュメントには、対応モデルとしてQwen 125BやDeepSeekのMoEモデルが並びます[4]。ただ、このエンジンでの実測TPSや具体的なGPU構成の数値は、今回の素材には見つかりませんでした。キャッシュ基盤には明確な高速化数値がある一方、量子化側には優位性を示す公開データがない。この非対称こそが現状の姿で、Gyroの実測比較が出てくるかが次の注目点と思われます。
引用ソース
- Reddit Reddit r/LocalLLaMA: Gyro quants looks like EXL3 but kinda closed source. please explain why we need this. — https://www.reddit.com/r/LocalLLaMA/comments/1xe41qe/gyro_quants_looks_like_exl3_but_kinda_closed/
Gyro quants looks like EXL3 but kinda closed source. please explain why we need this.
- Web記事 記事全文: [2608.30564v1] Q-Strata: Hierarchical Bit Allocation for Mixed … — https://arxiv.org/abs/2608.30564v1
Computer Science > Machine Learning
Title:Q-Strata: Hierarchical Bit Allocation for Mixed-Precision Quantization of Mixture-of-Experts LLMs
View PDF HTML (experimental)
Abstract:Mixed-precision quantization ( - Web記事 記事全文: Strata: Hierarchical Context Caching for Long Context Language Model … — https://arxiv.org/abs/2508.18572
Computer Science > Distributed, Parallel, and Cluster Computing
Title:Strata: Hierarchical Context Caching for Long Context Language Model Serving
View PDF HTML (experimental)
Abstract:Large Language Models ( - Web記事 Web検索: Supported Models & Quantization – Strata LLM (Qwen 125B, DeepSeek MoE … — https://stratallm.org/docs/models/
Supported Models & Quantization – Strata LLM (Qwen 125B, DeepSeek MoE …
- Web記事 Web検索: PDF Strata: Hierarchical Context Caching for Long Context Language Model … — https://www.usenix.org/system/files/osdi26-xie-zhiqiang.pdf
PDF Strata: Hierarchical Context Caching for Long Context Language Model …
- Web記事 Web検索: Q-Strata: Hierarchical Bit Allocation for Mixed-Precision Quantization … — https://papers.cool/arxiv/2608.30564
Q-Strata: Hierarchical Bit Allocation for Mixed-Precision Quantization …
- Web記事 Web検索: LLM Quantization Formats Compared: GGUF vs MLX vs EXL3 vs GPTQ vs AWQ … — https://d-central.tech/llm-quantization-formats/
LLM Quantization Formats Compared: GGUF vs MLX vs EXL3 vs GPTQ vs AWQ …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS