763Bの巨大モデルが、VRAM 12GBのGPU1枚で動く。以前取り上げたISTA-DASLabによる2bit量子化版DeepSeek-V4.1-Flash-1017について、今回はその仕組みと、その後の動きを追います。鍵は、テンソルごとに精度を変える「非一様量子化」にあるようです[2]。

まず仕組みから見ていきます。量子化とは、重みを圧縮してメモリを節約する仕組みです。一般的な量子化では、すべての重みテンソルに同じ型を適用します。GSQ-RCOはここが大きく違います。各テンソルがどれだけ精度を落とすと壊れるかという感度を、勾配ベースの探索で調べます。そのうえで、総サイズの予算内で、テンソルごとに異なる量子化型を割り当てるのです[2]。同じ総サイズでも、どこを削るかを賢く決める考え方といえます。出来上がるファイルは標準的なGGUFなので、いつものツールで読み込めます[2]。
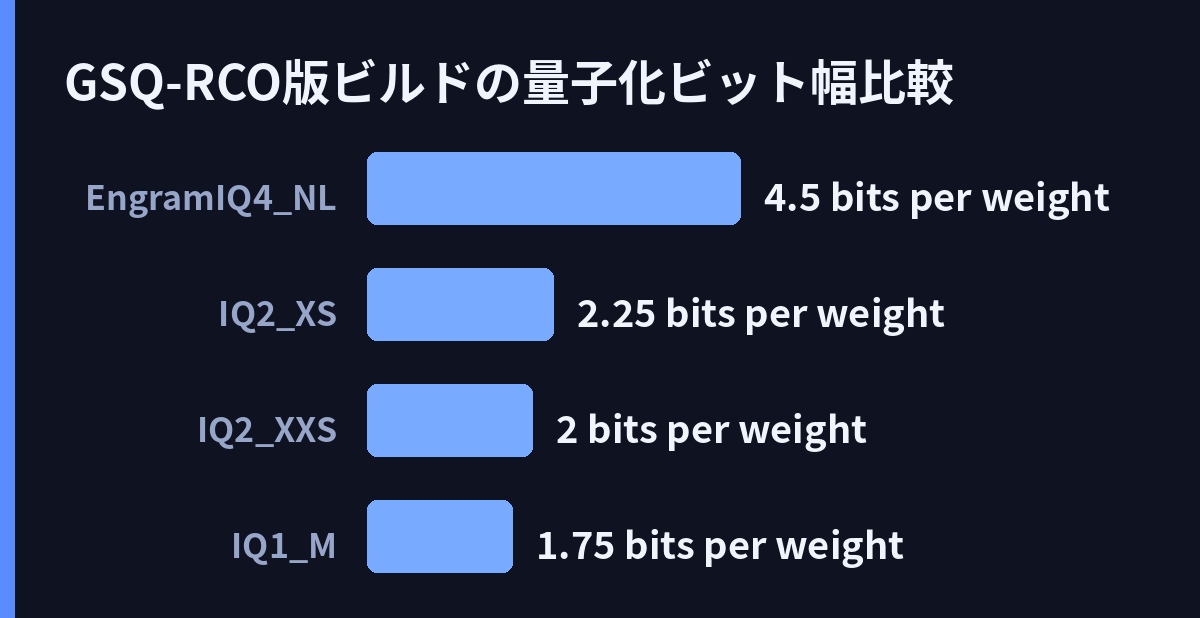
役割は2つに分かれています。GSQは、指定された量子化型で低ビットのスカラー量子化を正確に行う手法です。RCOは、サイズ予算の範囲でテンソルごとの型を決める割り当てを担当します[2]。この2つを組み合わせると、IQ1_M(1.75ビット)、IQ2_XXS(2.00ビット)、IQ2_XS(2.25ビット)という3種類のビルドが得られます[2]。探索が制御するのは、transformerの重み551.9Bパラメータ分の平均ビット幅です[2]。
対象モデルの構造も効いています。DeepSeek-V4.1-Flash-1017は、1層に384個のルーティングエキスパートを持ち、1トークンあたり6個だけが動くMoEです[2]。パラメータ数の大半をエキスパートが占めるため、サイズ予算の大半もここに使われます。ただし割り当ては層単位で、エキスパート単位ではありません。GGUFの形式がエキスパートごとの違いを表現できないためです[2]。
実行まわりの工夫もあります。モデルが持つ2つのEngramルックアップテーブル(196.6Bパラメータ)は、どのビルドでも共通です。そのためIQ4_NL(4.50ビット)で1回だけ保存しておけば、複数サイズを試すときも再ダウンロードが不要になります[2]。バックボーンのGGUFは4つのシャードに分かれて提供されます[2]。実行にはStrataというエンジンを使い、どのビルドも12GB VRAMのGPU1枚で動きます[2]。推論速度(TPS)などの実測値は、今回の素材には含まれていませんでした。AlphaSignalも「763Bモデルを12GB GPUに収めた」とこの成果を伝えています[7]。
技術の広がりも見えます。GSQの論文「Highly-Accurate Low-Precision Scalar Quantization for LLMs」はarXivで公開され[4]、Hugging Faceの論文ページからも読めます[5]。さらにGitHubでは、Apple Silicon向けのMLXにGSQ量子化とRCOのビット割り当てを移植したリポジトリが登場しました[6]。Mac環境でも同じ発想を試せるようになったようです。この話題はニュース集計サイトでも取り上げられ、注目を集めているようです[3]。
しかし、品質については疑問が消えていません。AIコミュニティのReddit r/LocalLLaMAには「良すぎて信じられないのでは」という投稿が寄せられました。公開ベンチマークは90%以上で飽和しており、AIME25は全バージョンで100です。圧縮による劣化がスコアに表れないのです[1]。投稿者はKLD(元モデルとの出力のずれを測る指標)やPPL(予測の乱れを示す指標)の測定値を探しましたが、見つからなかったといいます[1]。約2ビットでどの程度のKLDになるのか、という問いも投げられています[1]。海外メディアも「量子化の奇跡か、ベンチマークの飽和か」とこの論点を取り上げました[8]。
2bit量子化の技術は、論文・実装・MLXへの移植と、着実に広がりを見せています。一方で「飽和したベンチマークでは劣化が見えない」という検証の課題は、そのまま残っています。巨大MoEをローカルで動かす選択肢が広がるなか、品質をどう確かめるかという問いも一緒に育っています。2bitという極端な圧縮が実用になるかどうかは、飽和しない指標での実測次第といえそうです。
引用ソース
- Reddit Reddit r/LocalLLaMA: Too good to be true? ISTA’s GSQ-RCO 2-bit DeepSeek-V4.1-Flash scoring the same as the base model — https://www.reddit.com/r/LocalLLaMA/comments/1xes5x0/too_good_to_be_true_istas_gsqrco_2bit/
Too good to be true? ISTA’s GSQ-RCO 2-bit DeepSeek-V4.1-Flash scoring the same as the base model
- Web記事 記事全文: DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF – Hugging Face — https://huggingface.co/ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF
Non-uniform GGUF quantizations of a 763B-parameter, 384-expert MoE, produced with GSQ and RCO.
This repository provides GGUF quantizations of DeepSeek-V4.1-Flash-1017 at three sizes: IQ1_M (1.75 bits per weight), IQ2_XXS - Web記事 記事全文: Reddit questions ISTA’s 2-bit GSQ-RCO quant of DeepSeek-V4.1-Flash — https://aibriefs.news/card/c42a9fca-d3e8-4774-a9fe-384dd1778da1
Reddit questions ISTA’s 2-bit GSQ-RCO quant of DeepSeek-V4.1-Flash
Read original source →reddit.com
A LocalLLaMA user asks whether ISTA’s GSQ-RCO GGUFs for DeepSeek-V4.1-Flash really match the base model, noting the publ - Web記事 Web検索: [2604.18556] GSQ: Highly-Accurate Low-Precision Scalar Quantization for … — https://arxiv.org/abs/2604.18556
[2604.18556] GSQ: Highly-Accurate Low-Precision Scalar Quantization for …
- Web記事 Web検索: Paper page – GSQ: Highly-Accurate Low-Precision Scalar Quantization for … — https://huggingface.co/papers/2604.18556
Paper page – GSQ: Highly-Accurate Low-Precision Scalar Quantization for …
- Web記事 Web検索: GitHub – egesabanci/gsq-rco-mlx: GSQ quantization + RCO bit allocation … — https://github.com/egesabanci/gsq-rco-mlx
GitHub – egesabanci/gsq-rco-mlx: GSQ quantization + RCO bit allocation …
- Web記事 Web検索: ISTA-DASLab Squeezes DeepSeek’s 763B Model onto a 12 GB GPU – AlphaSignal — https://alphasignal.ai/news/ista-daslab-squeezes-deepseek-s-763b-model-onto-a-12-gb-gpu
ISTA-DASLab Squeezes DeepSeek’s 763B Model onto a 12 GB GPU – AlphaSignal
- Web記事 Web検索: Quantization Miracle or Benchmark Saturation? Unpacking ISTA’s 2-bit … — https://baguaai.com/quantization-miracle-or-benchmark-saturation-unpacking-istas-2-bit-deepseek-v4-1-flash/
Quantization Miracle or Benchmark Saturation? Unpacking ISTA’s 2-bit …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS