「本当に、llama.cppをクローンしたほうがいい」——Redditのr/LocalLLaMAに、こんな投稿が話題になっています[1]。AIにコードを任せる「バイブコーディング」で推論エンジンを自作した投稿者が、行き着いた結論です。そして、このバイブコーディングという手法自体が、学術論文や起業家向け記事で扱われるまでになりました[4][5][7]。その後の展開を追います。
投稿の試みは野心的です。量子化(重みを圧縮してメモリを節約する仕組み)したモデルを、GGUFというモデルファイル形式で読み込みます。これをブラウザの描画規格WebGL2の計算バッファに展開し、GPU向けの言語GLSLでHTMLの中から直接動かします[1]。投稿者を長く苦しめたのは、トークナイザ(文章をトークンIDに分割する部分)と語彙の処理だったといいます[1]。
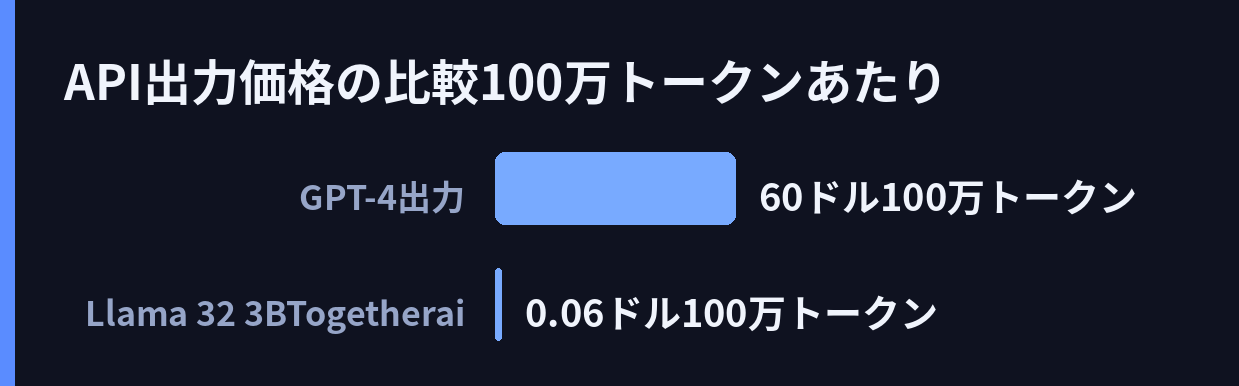
では、なぜ自作に挑む人が続くのでしょう。解説ブログのひとつは、APIの価格を手がかりに示しています[3]。GPT-4の出力は1000トークンあたり0.06ドルです。一方、Together.aiのLlama 3.2 3Bは100万トークンあたり0.06ドル。同じ「0.06ドル」でも基準が1000倍違います。100万トークンに揃えて比べると、60ドル対0.06ドルの差です[3]。モデルの性能が上がると価格も上がる例として、MMLUという知識テストで83を取るGPT-4がGPT-3.5より高価になる点も挙げられています[3]。コスト構造の違いが、自作への動機になっているようです。
別の解説ブログは、約200行のPythonで動く小型の推論エンジンを実際に組み、抽象化の裏側を見せる方法を紹介しています[2]。速度のつまずき(期待の200トークン/秒に対し20トークン/秒しか出ない場面)は以前もお伝えした報告ですが、それ以外の問題もあります[2]。長いコンテキストでGPUのメモリが足りなくなるOOM(メモリ不足エラー)。そして、2人のユーザーが1つのインスタンスを共有すると、理由がわからないまま片方が待たされる問題です[2]。KVキャッシュ(計算済みの値を保存し、同じ計算を避ける仕組み)を自分で書いて初めて、原因が見えてくるといいます[2]。
同ブログは推論を4段階に整理します。プロンプトのトークン化、prefill(プロンプト全体を一括処理する段階)、サンプリング、そしてdecode(トークンを1つずつ生成する段階)の繰り返しです[2]。この骨格が見えると、vLLMやTensorRT-LLMといった本番システムが、段階ごとに違う最適化をしている理由も読み解けます[2]。
一方で、壁の高さを示す報告は増えています。起業家がバイブコーディングでの推論エンジン自作に失敗し続ける実態を解説する記事が現れました[5]。学術側も動いています。ACMの研究はバイブコーディングの動機と課題を分析しました[4]。arXivのサーベイ(調査論文)は、LLMを使ったバイブコーディングの全体像を整理しています[7]。ジャーナルの論文は、AI支援開発の課題・リスク・限界を取り上げました[6]。Reddit投稿者の結論は、こうした分析の方向と重なって見えます[1]。
自作の価値は、本番システムを作り替えることではなく、仕組みを手元で確かめることにありそうです。4段階の流れとKVキャッシュを知れば、遅さやメモリ不足の原因を自分で突き止められます[2]。GPT-4と小型モデルで1000倍違う価格差[3]を前に、どこにコストがかかるかを見抜く力になるでしょう。
引用ソース
- Reddit Reddit r/LocalLLaMA: Vibecoding your own inference engine is easy they said — https://www.reddit.com/r/LocalLLaMA/comments/1xdh57e/vibecoding_your_own_inference_engine_is_easy_they/
Vibecoding your own inference engine is easy they said
- Web記事 記事全文: Build Your Own Inference Engine: From Scratch | martinuke0’s Blog — https://martinuke0.github.io/posts/2026-09-01-build-your-own-inference-engine-from-scratch/
TL;DR — A working LLM inference engine is just four stages: tokenize the prompt, run a forward pass through transformer blocks while filling a KV cache, sample the next token, and repeat until the model emits an end-of-s
- Web記事 記事全文: Building an LLM Inference Engine ‘From Scratch’ — https://sushantvema.github.io/notes/llm_inference_engine
Let’s learn how to build a llm inference engine from scratch.
Philosophy
Abstraction forces you to reach the highest level of the basics. – Alan Soffer
Introduction
In the rapidly evolving field of Artificial Intelligenc - Web記事 Web検索: Vibe Coding in Practice: Motivations, Challenges, and a Future Outlook … — https://dl.acm.org/doi/10.1145/3786583.3786866
Vibe Coding in Practice: Motivations, Challenges, and a Future Outlook …
- Web記事 Web検索: Why founders keep failing to vibecode their own LLM inference engine — https://startupfortune.com/why-founders-keep-failing-to-vibecode-their-own-llm-inference-engine/
Why founders keep failing to vibecode their own LLM inference engine
- Web記事 Web検索: Challenges, Risks, and Limitations of Vibe Coding in AI-Assisted … — https://journals.stmjournals.com/article/article=2026/view=242299/
Challenges, Risks, and Limitations of Vibe Coding in AI-Assisted …
- Web記事 Web検索: A Survey of Vibe Coding with Large Language Models – arXiv.org — https://arxiv.org/pdf/2510.12399v1
A Survey of Vibe Coding with Large Language Models – arXiv.org
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS