巨大クラウドモデルにしかできないと思われてきた動画制作を、ローカルで動くAIモデルがやってみせました。Redditのr/LocalLLaMAに投稿されたのは、Qwen3.8 Flash Nextでモーショングラフィックス動画を仕上げたという実演です[1]。投稿者は「Opus 5.5のような大型クラウドモデルが称賛を集めるなか、ローカルでも十分に可能だ」と語っています[1]。
試行の内容は具体的です。使ったのはRemotionという、コードでアニメーションを組み立てるフレームワークです。Opus 5.5のモーショングラフィックス映像が話題になるなか、その土俵にローカルから挑んだ形になります[1]。実行環境はAMDのStrix Halo。CPUとGPUを1チップにまとめ、大容量メモリを共用できるAPUです[1]。GPU単体のVRAM(GPU側のメモリ)に頼らず広いメモリを使えます。モデルはunsloth版のQwen3.8 Flash Nextです。量子化(重みを圧縮してメモリを節約する仕組み)はUD-Q4_K_XLという型が使われています[1]。投稿者は指示から完成までの会話履歴も公開しており、誰でも再現を試せる状態です[1]。r/LocalLLaMAらしい、ハッカー精神あふれる試みです。
ローカルでここまで動く背景には、Qwen3シリーズの設計があります。技術レポートによると、シリーズは0.6Bから235Bまでのモデル群です[2]。dense(全パラメータを計算に使う標準的な構造)に加え、MoE(計算の一部だけを活性化して効率を上げる構造)もそろえます[2]。総パラメータが大きくても活性化部分が小さいMoEは、ローカル動作と相性がいい構造です。Flash Nextクラスの大型MoEが1台で動くのは、この構造が一因と思われます。
設計上の特徴はほかにもあります。難しい問題を段階的に考えるthinkingモードと、即答するnon-thinkingモードを1つのモデルに統合しました[2]。チャット用と推論用の別モデルを切り替える必要がなくなっています[2]。推論に注ぐ計算量を調整するthinking budgetの仕組みも備わります[2]。対応言語は前世代の29から119に増え、ライセンスはApache 2.0です[2]。
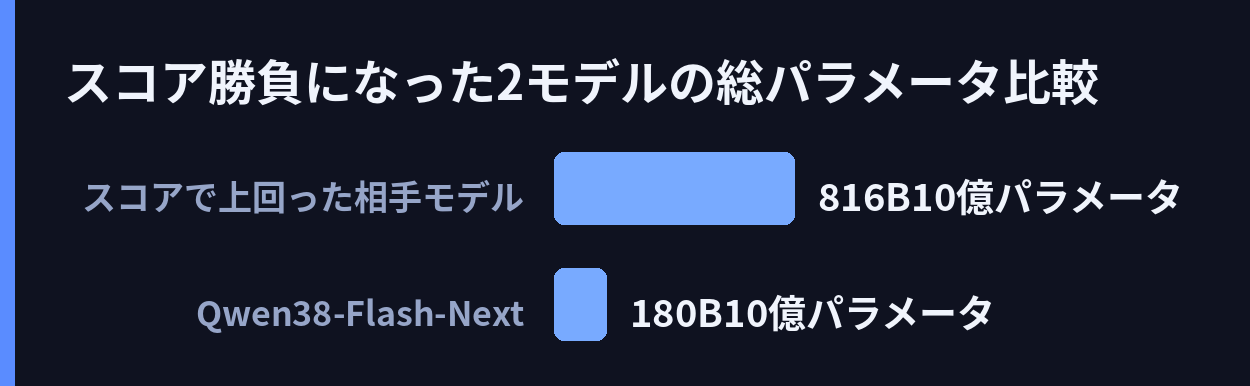
Flash系の実力については、以前取り上げた実測もあります。総パラメータ180BのQwen3.8-Flash-Nextが、816Bのモデルをスコアで上回ったというものです。今回の動画実演は、その数字を実用途の面からも裏付ける例と言えそうです。
ただし、話を美化しないほうがよい点もあります。投稿者自身が認めているように、1回の指示で完成したわけではありません。プロンプトを重ね、修正と誘導を何度も繰り返して仕上げた成果です[1]。また、ASUSがQwen3.8 27BをRTX 5090で動かすレビューも公開しています[3]。家庭のPCで動かせるかを検証する内容で、推論はフロンティアに迫るものの速度は遅めと評されています[3]。以前取り上げた27Bの追跡では、古いV100 2枚の構成で60tps(1秒間に生成できるトークン数)が報告されていました。今回のASUS記事はRTX 5090での検証ですが、素材には速度の数値がありません。Strix Halo構成でのTPSや消費電力、メモリの分担といった実測も素材には見つかりませんでした。
コード生成向けの話題も動いています。Qwen3 Coderの性能を他モデルと比較する評価記事が公開されていますが、素材からは詳細なスコアまでは確認できませんでした[3]。ベンチマーク結果を整理して読める資料も整備が進んでいます[3]。ソースコードや技術レポートはGitHubで公開されており、検証はコミュニティ主導で進む体制です[3]。
それでも示唆ははっきりしています。Apache 2.0で公開されたからこそ、unslothのようなグループが量子化版を素早く出し、個人の環境で大型モデルが動くのです[2][1]。動画のような創作的なコーディング課題は、推論力と指示追従性が同時に問われる領域だと思われます。完全な代替にはまだ工夫が必要ですが、「クラウドでしかできない」領域は確実に狭まっています。次に注目したいのは速度側の実測です。TPSや消費電力の報告が揃えば、ローカル推論の実力像がさらにくっきりするでしょう。
引用ソース
- Reddit Reddit r/LocalLLaMA: big cloud models like opus 5.5 get all the motion graphics praise, but i made this with local qwen3.8 flash next. it’s very possible! — https://www.reddit.com/r/LocalLLaMA/comments/1xebkti/big_cloud_models_like_opus_55_get_all_the_motion/
big cloud models like opus 5.5 get all the motion graphics praise, but i made this with local qwen3.8 flash next. it’s very possible!
- Web記事 記事全文: Qwen3 Technical Report – arXiv.org — https://arxiv.org/html/2505.09388v1
Qwen3 Technical Report
Abstract
In this work, we present Qwen3, the latest version of the Qwen model family. Qwen3 comprises a series of large language models (LLMs) designed to advance performance, efficiency, and multi - Web記事 Web検索: Qwen3 Coder Performance Evaluation: A Comparative Analysis Against … — https://eval.16x.engineer/blog/qwen3-coder-evaluation-results
Qwen3 Coder Performance Evaluation: A Comparative Analysis Against …
- Web記事 Web検索: Qwen3.8 27B Review: Near-Frontier Local AI on an RTX 5090|ASUS Global — https://www.asus.com/blog/can-you-run-qwen3-8-27b-on-a-home-pc-near-frontier-reasoning-but-slower-speeds/
Qwen3.8 27B Review: Near-Frontier Local AI on an RTX 5090|ASUS Global
- Web記事 Web検索: GitHub – QwenLM/Qwen3: Qwen3 is the large language model series … — https://github.com/QwenLM/Qwen3
GitHub – QwenLM/Qwen3: Qwen3 is the large language model series …
- Web記事 Web検索: Performance Benchmarking | QwenLM/Qwen3 | DeepWiki — https://deepwiki.com/QwenLM/Qwen3/6.1-performance-benchmarking
Performance Benchmarking | QwenLM/Qwen3 | DeepWiki
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS