ベンチマーク4位のAIモデルが、実戦では全く歯が立たない――こんな指摘がRedditで話題になっています。舞台は、ローカル環境でAIを動かす利用者が集う掲示板「r/LocalLLaMA」です。AIモデルの総合力を0〜100で順位付ける「Artificial Analysis Intelligence Index」(以下AAI)について、実使用とのズレを疑う声が上がりました[1]。
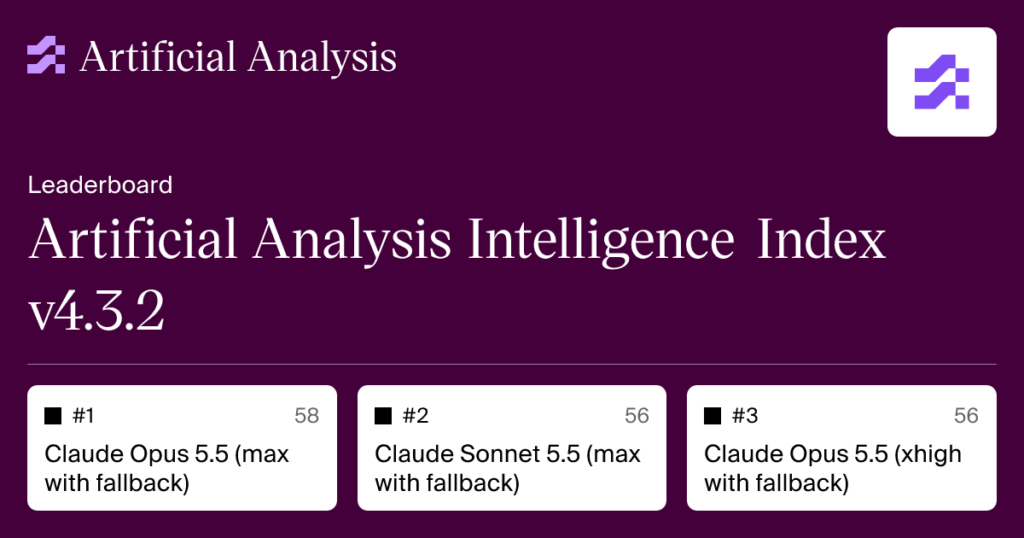
AAIは、調査会社Artificial Analysisが公開する複合ベンチマークです。複数のテストをまとめ、モデルの能力を0から100の総合得点で示します[2]。数学・科学・コーディング・推論を幅広く測る、10種類のテストの集合体です[2]。内訳は、エージェント(AIが自律的に作業を進める領域)、コーディング、一般能力、科学的推論の4分野で、それぞれ25%ずつの重み付けです[2]。テストにはTerminal-Bench 4.0やHumanity’s Last Exam、SciCodeのほか、GDPval-AAやAA-LCRが名を連ねます[2]。中には、スプレッドシートやプレゼン資料、メモといった成果物を仕上げさせる実務寄りのテスト「AA-Briefcase」もあります[2]。現在の首位はClaude Opus 5.5で、スコアは58です[2]。指数ページでは、タスクあたりのコストや出力トークン数、所要時間も併せて公開されています[2]。
今回の投稿者は、AAIで4位にランクされたKimi 3.1 Proを実際に試しました。方法はOpenRouter(複数のAIモデルを同じ窓口から呼び出せるサービス)経由です[1]。投稿タイトルは、この指数が「実世界の性能を代表していない」と率直に主張しています[1]。実際に使った感想も手厳しいものでした。Kimi 3.1 Proは「MiMo 2.6やDeepSeek 4.1 Flashに遠く及ばない」との評価です[1]。実世界の用途では「かなり悪い」というのが体感でした[1]。投稿者はさらに、AAIは「とてもゲームしやすい」、つまり上位を狙った調整がしやすいと訴えています[1]。
興味深いのは、指数を提供する側も限界を認めている点です。Artificial Analysisの説明では、総合スコアが高いことは、あくまでベンチマーク群全体での強さを示すものです。コーディングやエージェント業務、科学的推論など、特定の用途に合うかは、個別テストの結果のほうが参考になると同社自身が書いています[2]。実際、同社はAAI以外にも多数の指数を公開しています。コーディングエージェント、検索、サイバー、金融・会計、法務、医療、エンジニアリングなど、用途や業界ごとの指数です[3]。モデルの公開度を測るOpenness Indexもあります[3]。検索の指数では、すべての提供元に同じ回答モデルを組み合わせ、性能の向上幅を測る工夫もされています[3]。1つの総合得点では測りきれない領域がある、という前提での運用のようです。
ただし、今回の批判そのものには弱点もあります。投稿には具体的なテスト内容も、比較に使ったスコアも示されていません。MiMo 2.6やDeepSeek 4.1 FlashのAAI順位にも触れがなく、ギャップの大きさを数字で確かめられません[1]。あくまで1人の利用者の体感報告にとどまります。とはいえ、同様の視点は他にもあります。「Artificial Analysisは有用だが、指数は実世界の妥当性を欠く」という趣旨の記事が公開されています[4]。また、Kimiシリーズのベンチマークを解説する記事も複数出ています。GPTやClaudeとの比較分析[5][7]、MoE(複数の小さな専門家ネットワークで構成するモデル方式)の解説[6]などです。その一つは「ハイプ(過熱)の背後にあるベンチマーク」と題されています[8]。ベンチマークの順位をどこまで信じるかは、Kimiをめぐっても関心を集めるテーマのようです。
総合指数は、無数のモデルから候補を絞る最初の地図としては便利です。しかし今回の報告が突きつけるのは、順位と実感のズレです。提供元自身が個別テストの重視を勧めている以上[2]、利用者側も順位だけに頼らず、自分の作業に近いテスト結果や実際の試用で確かめるのが安全でしょう。批判の真偽はまだ不明です。それでも「1つの数字で語らない」という姿勢は、今回の論争から得られる一番の教訓と思われます。
引用ソース
- Reddit Reddit r/LocalLLaMA: Artificial Analysis Index is non-representative of real-world performance. Tested Kimi 3.1 Pro through OpenRouter, the number 4 model in AAI, it’s not even close to MiMo 2.6 or DeepSeek 4.1 Flash — https://www.reddit.com/r/LocalLLaMA/comments/1xercio/artificial_analysis_index_is_nonrepresentative_of/
Artificial Analysis Index is non-representative of real-world performance. Tested Kimi 3.1 Pro through OpenRouter, the number 4 model in AAI, it’s not even close to MiMo 2.6 or DeepSeek 4.1 Flash
- Web記事 記事全文: Artificial Analysis Intelligence Index v4.3.2 — https://artificialanalysis.ai/evaluations/artificial-analysis-intelligence-index
Artificial Analysis Intelligence Index v4.3.2
Artificial Analysis Intelligence Index
Score
Artificial Analysis Intelligence Index: Score
Intelligence Index vs. Cost per Task
Token Usage
Artificial Analysis Intelligence I - Web記事 記事全文: AI Indexes: Benchmarks & Rankings | Artificial Analysis — https://artificialanalysis.ai/indexes
Indexes
Artificial Analysis Intelligence Index v4.3.2
A composite benchmark aggregating ten challenging evaluations to provide a holistic measure of AI capabilities across mathematics, science, coding, and reasoning.
Art - Web記事 Web検索: Artificial Analysis useful but index lacks real-world validity – AI … — https://artificialintelligencedynamics.com/2026/06/17/artificial-analysis-useful-but-index-lacks-real-world-validity/
Artificial Analysis useful but index lacks real-world validity – AI …
- Web記事 Web検索: Kimi K2.5 Benchmark: Complete Performance Analysis vs GPT, Claude … — https://kimi-k25.com/blog/kimi-k2-5-benchmark
Kimi K2.5 Benchmark: Complete Performance Analysis vs GPT, Claude …
- Web記事 Web検索: Kimi K2 Architecture: MoE Design, Benchmarks & Use Cases | Fireworks — https://fireworks.ai/blog/kimi-k2-architecture-benchmarks
Kimi K2 Architecture: MoE Design, Benchmarks & Use Cases | Fireworks
- Web記事 Web検索: Kimi-K2 Performance Benchmarks and Model Comparison Analysis — https://kimi-k2.org/blog/04-benchmark-analysis
Kimi-K2 Performance Benchmarks and Model Comparison Analysis
- Web記事 Web検索: Kimi K2.7 Code: The Benchmarks Behind the Hype – Medium — https://medium.com/@ffguci8/kimi-k2-7-code-the-benchmarks-behind-the-hype-cad7834c1490
Kimi K2.7 Code: The Benchmarks Behind the Hype – Medium
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS