763Bの巨大AIモデルが、12GBのGPU1枚で動く——そんな量子化が話題です。GPTQを生んだISTA-DASLab(オーストリアの研究所)が、DeepSeek-V4.1-Flash-1017を圧縮したGSQ-RCO量子化を、ローカル推論で広く使われるGGUF形式で公開しました[2][3]。量子化は、重みを圧縮してメモリを節約する仕組みです。

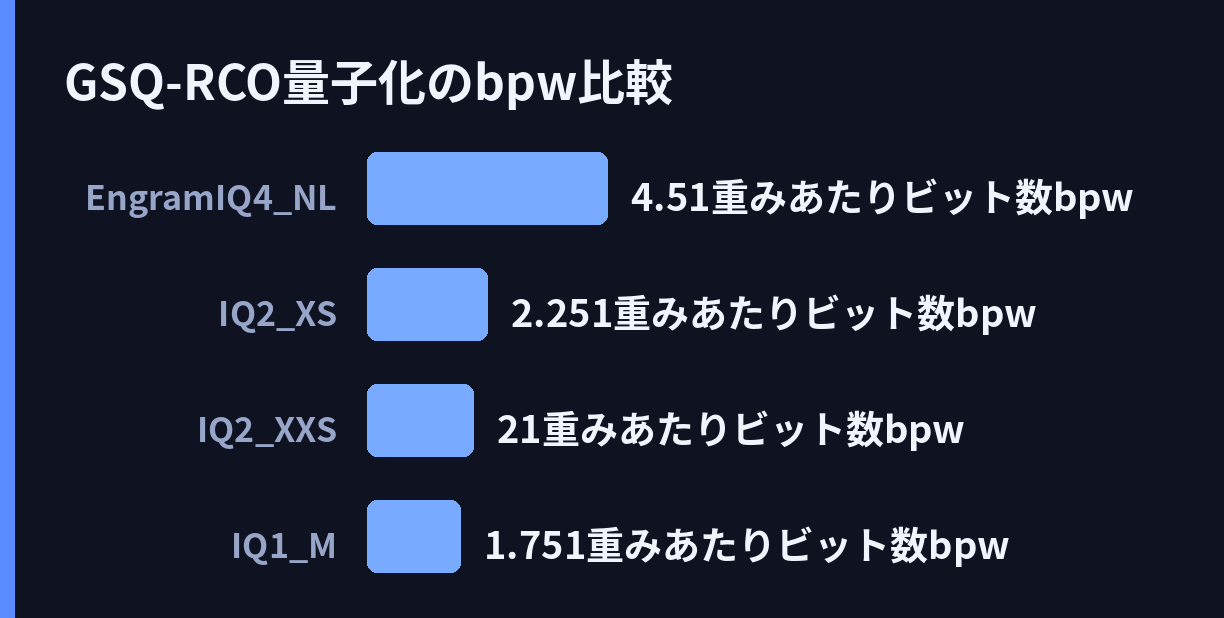
公開されたのは3サイズです。IQ1_Mが1.75bpw、IQ2_XXSが2.00bpw、IQ2_XSが2.25bpw。bpwは1つの重みを何ビットで保存するかを示す値で、小さいほど強く圧縮したことを意味します[2][3]。最小のIQ1_Mは1つの重みを1.75ビットで保存する、かなり極端な圧縮です。対象モデルは、層ごとに384個のエキスパート(専門担当の部分ネットワーク)を持ち、トークンごとに6つだけを動かすMoEです。総パラメータは763.2B、コンテキストは1Mトークンに達します[2]。
ポイントは「非均一」な量子化です。全部の重みに同じ型を当てるのではなく、重みのまとまり(テンソル)ごとに型を変えます。どのテンソルにどの精度を配分するかは、勾配ベースの探索で決まります。感度の高い部分に精度を残し、全体のサイズ予算内に収める仕組みです[2]。GSQは各テンソルを低ビットでも正確に量子化する手法です。通常は近い値への単純な丸めですが、GSQは丸め先を最適化で決めます。離散的な選択を最適化できる形にするのがGumbel-Softmaxの緩和です[3]。RCOはサイズ予算の下で、テンソルごとの型を割り当てる探索です[2][3]。エキスパートがパラメータの大半を占めるため、探索の自由度もそちらに集中します。ただし割り当ては層単位です。GGUFの形式がエキスパート単位を表現できないためです[2]。
ファイル構成も工夫されています。本体の重み(551.9B)は4分割のバックボーンGGUFです。モデルが持つ2つのEngram検索テーブル(196.6B)は、IQ4_NLの4.50bpwで別ファイルに切り出されました。全ビルドで共通のため、1回だけダウンロードすればよい作りです[2]。実行にはStrata推論エンジンとの組み合わせが前提で、12GB VRAMのGPU1枚に大容量のシステムRAMを組み合わせたハイブリッド構成で動きます[2][3]。動作にはシステムRAMのほか、ディスク容量やメモリ帯域も影響します。ワークステーションでのローカル推論に適した構成です[3]。
周辺も動いています。GSQの手法は論文として公開されています[4]。GitHubにはApple Silicon向けのMLX実装も登場しました[5]。Qwen3.8-Flash-Nextを24GBで128Kコンテキスト動かす実用レポートも出ており[6]、手法が他モデルへ広がり始めています。量子化エコシステムをGPTQで変えた研究所だけに、注目度は高めです[3]。
しかし、品質については検証の声が上がっています。Redditのr/LocalLLaMAでは、「IQ2_XXSがベースモデルと同じスコアというのは良すぎて疑わしい」という投稿が話題になりました[1]。投稿者が指摘するのはベンチマークの飽和です。スコアは90%超で頭打ちになり、AIME25に至っては全バージョンが100です。劣化がスコアに表れない可能性があります[1]。さらに、GSQ-RCOモデルのKLD(元のモデルとの出力のずれを測る指標)は公開されていないと報告されています[1]。2bpw付近でどれほどずれるのか、「誰かKLDやPPLを測った人はいませんか」と、実測を呼びかけています[1]。
なお、本記事で確認できた範囲では、実測のTPSや消費電力のデータは見つかりませんでした。Strataとllama.cppなどのエンジン比較のデータも見つかりませんでした。速度面は、今後のユーザーレポートに委ねられているようです。
巨大MoEをテンソル単位で削る非均一量子化は、ローカル推論の裾野を広げる方向性です。ただし「2bitでも劣化なし」は、まだ実証途中です。ベンチマークの数字が信頼できるものになるかどうかは、これから出てくるKLDやPPLの実測次第でしょう。
引用ソース
- Reddit Reddit r/LocalLLaMA: Too good to be true? ISTA’s GSQ-RCO 2-bit DeepSeek-V4.1-Flash scoring the same as the base model — https://www.reddit.com/r/LocalLLaMA/comments/1xes5x0/too_good_to_be_true_istas_gsqrco_2bit/
Too good to be true? ISTA’s GSQ-RCO 2-bit DeepSeek-V4.1-Flash scoring the same as the base model
- Web記事 記事全文: ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF · Hugging Face — https://huggingface.co/ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF
Non-uniform GGUF quantizations of a 763B-parameter, 384-expert MoE, produced with GSQ and RCO.
This repository provides GGUF quantizations of DeepSeek-V4.1-Flash-1017 at three sizes: IQ1_M (1.75 bits per weight), IQ2_XXS - Web記事 記事全文: ISTA-DASLab Squeezes DeepSeek’s 763B Model onto a 12 GB GPU | AlphaSignal — https://alphasignal.ai/news/ista-daslab-squeezes-deepseek-s-763b-model-onto-a-12-gb-gpu
– ISTA-DASLab released GSQ-RCO GGUF quants of DeepSeek-V4.1-Flash-1017, a 763B 384-expert MoE.
– Three sizes available: IQ1_M (1.75 bpw), IQ2_XXS (2.00) and IQ2_XS (2.25).
– Runs on a single 12GB GPU when paired with the - Web記事 Web検索: [2604.18556] GSQ: Highly-Accurate Low-Precision Scalar Quantization for … — https://arxiv.org/abs/2604.18556
[2604.18556] GSQ: Highly-Accurate Low-Precision Scalar Quantization for …
- Web記事 Web検索: GitHub – egesabanci/gsq-rco-mlx: GSQ quantization + RCO bit allocation … — https://github.com/egesabanci/gsq-rco-mlx
GitHub – egesabanci/gsq-rco-mlx: GSQ quantization + RCO bit allocation …
- Web記事 Web検索: Qwen3.8-Flash-Next Field Report: 128K Context on 24GB, GSQ-RCO … — https://note.com/samehadaonsen/n/n2383084c073c?hl=en
Qwen3.8-Flash-Next Field Report: 128K Context on 24GB, GSQ-RCO …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS