GGUFを作り直す時期が来たのかもしれません。ローカルでAIモデルを動かす定番ソフトllama.cppに、Qwenモデルの変換手順を変える改善案が投稿され、Redditのr/LocalLLaMAで話題になっています[1]。改善案はPR(プルリクエスト、コードの変更を本体に取り込んでもらう提案)という形です。投稿には「time to reconvert GGUFs?(GGUFを作り直す時期が来た?)」という言葉が添えられていました。
PRの番号は31028で、ggml-org/llama.cppにam17anさんが出したものです。タイトルは「qwen: merge tensors on convert」。QwenのモデルをGGUF形式に変換する際、テンソルを統合する変更だとわかります。テンソルは、モデルの重み(学習で得られた大量の数値)を格納するデータのかたまりです。GGUFは、llama.cppでモデルを読み込むためのファイル形式です。つまり、ファイルの中身の構造を整える処理が、変換ツール側に加わることになります。
統合すると何が変わるのか。素材には、このPRの効果を示す具体的な数値は見つかりませんでした。変換の段階でテンソルの構造を整理する変更であることは、タイトルから読み取れます。変換の作り方は、その後の推論の速度やメモリの使い方に影響する要素です。だからこそ、地味に見える変更でも、コミュニティは見逃さないのでしょう。
注目が集まる背景には、Qwenというモデル群の規模があります。Alibaba CloudのQwenチームが開発するLLMファミリーです[3]。2023年の最初の公開以降、テキスト生成や推論、画像・動画理解、音声処理、コーディングへと対応領域を広げてきました。利用方法は、ブラウザから使えるQwen Studio、API、コーディングツール、オープンウェイトモデルと多岐にわたります。2026年8月の発表によると、公開モデルは460以上、派生モデルは30万以上、累計ダウンロード数は30億を超えています。オープンウェイトモデルは利用回数に応じた料金がかからない一方、GPUやクラウド、保守の費用は必要です。ウェイトが公開されたモデルが多く、ローカルで動かすユーザーも多いファミリーです。
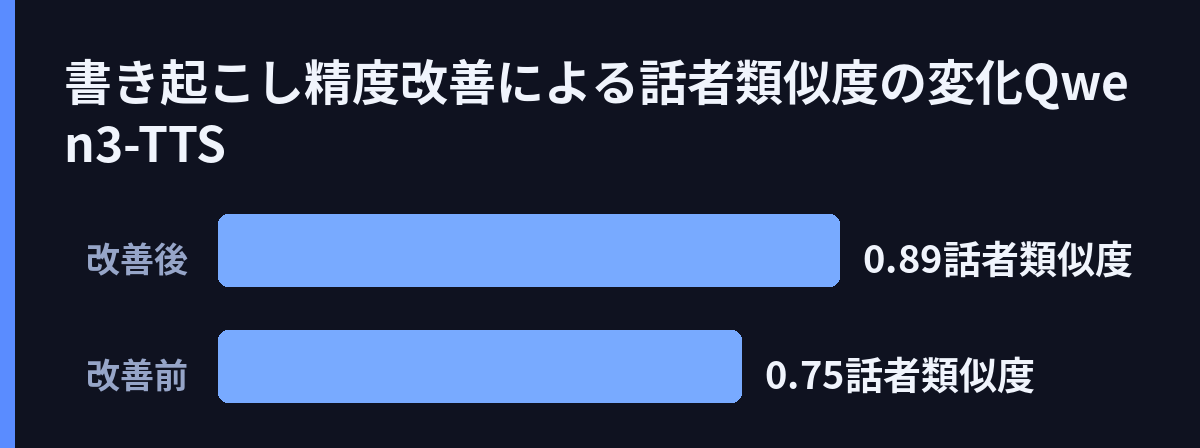
Qwenの広がりを示す例が音声です。Qiitaの解説記事によると、音声合成モデルのQwen3-TTSは、オープンソースTTSとして初めて商用サービスの性能を上回りました。比較相手はElevenLabsやMiniMax-Speechです。英語のWER(音声をテキストに起こす際の誤り率)は1.24%、話者類似度は0.775という数値が示されています[2]。Apache 2.0ライセンスで、ローカル実行もできます。参照音声とその書き起こしを渡すと声質を継承でき、書き起こし精度を改善した実例では、話者類似度が0.75から0.89に上がったと紹介されています。

テキストモデルの実行まわりも動きが活発です。Qwen3-4BはHugging Faceで公開されています。Qiitaでは、Qwen3-8Bの速度を比べた記事も見られます。比較対象は、圧縮前の精度BF16と、量子化手法GPTQの4bitです。量子化は、重みを圧縮してメモリを節約する仕組みです。decode(トークンを1つずつ生成する段階)の速度が比べられています。ただし、検索結果にはこの比較の具体的な測定値は含まれていませんでした。量子化の選択と変換時のテンソルの構造は、どちらもGGUFの使い勝手を左右する要素です。
一方で、既存ユーザーには落とし穴があります。「time to reconvert GGUFs?」という言葉が示すように、新しい作り方の恩恵を受けられるのは、変換し直したGGUFです。すでに手元にあるファイルは、そのままでは対象外のようです。再変換には時間も計算資源もかかります。自分で変換し直すか、新しい作り方のファイルが配布されるのを待つか、いずれにしても一手間です。そもそもPRは提案段階で、素材からは採用状況まで確認できません。さらにQwenはAPIプラットフォームも展開しています[4]。ローカルでGGUFを扱わないユーザーには、直接の影響はないと考えられます。
モデルの性能競争だけでなく、変換や実行の効率を磨く動きも、ローカルLLMコミュニティでは続いています。このPRが取り込まれれば、今後配布されるQwenのGGUFの作り方が変わる可能性があります。既存ファイルを持つ人は、動向を見てから再変換の要否を判断するのがよさそうです。
引用ソース
- Reddit Reddit r/LocalLLaMA: qwen: merge tensors on convert by am17an · Pull Request #31028 · ggml-org/llama.cpp — https://www.reddit.com/r/LocalLLaMA/comments/1xf716t/qwen_merge_tensors_on_convert_by_am17an_pull/
qwen: merge tensors on convert by am17an · Pull Request #31028 · ggml-org/llama.cpp
- Web記事 記事全文: Qwen3-TTS で声をクローン・設計する+RVC で元のアクセントを保持した声変換【ComfyUI対応】 – Qiita — https://qiita.com/quittardis/items/4cb507aca3c0f8b19677
Alibaba Cloud の Qwen チームが 2026 年 1 月に公開した Qwen3-TTS は、オープンソース TTS モデルとして初めて ElevenLabs・MiniMax-Speech といった商用サービスを性能で上回りました(英語 WER 1.24%、話者類似度 0.775)。Apache 2.0 ライセンスでローカル実行が可能です。
この記事では Qwen3-TTS の 2 つの主要機能と、TTS では再現できない - Web記事 記事全文: Qwenとは?モデル一覧・料金、できること・機能、ChatGPT・Claude・Geminiとの違い、使い方まで徹底解説! — https://ai-market.jp/technology/qwen/
Qwenとは?モデル一覧・料金、できること・機能、ChatGPT・Claude・Geminiとの違い、使い方まで徹底解説!
最終更新日:2026年10月01日
記事監修者:森下 佳宏|BizTech株式会社 代表取締役
– Qwenは、Alibaba CloudのQwen Teamが開発する大規模言語モデル(LLM)ファミリー
– Qwen Studio、Alibaba Cloud Model Studio、Qwen Code、オープン - Web記事 Web検索: Qwen3-8BのBF16とGPTQ 4bitのDecode速度比較 #AI – Qiita — https://qiita.com/joule/items/c591b9ba26efbca223e2
Qwen3-8BのBF16とGPTQ 4bitのDecode速度比較 #AI – Qiita
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS