JARファイル1つ、依存ライブラリなしで動くJVM(Javaプログラムを動かす土台)推論エンジン。あの投稿の中身が、ようやく見えてきました。Hacker Newsのスコアは現在2ポイント・コメント1件です。以前この連載で取り上げた時点はスコア1・コメント0件だったので、少しずつ反応が集まっています[1]。今回注目したいのは、作者本人がコメント欄で設計の詳細を語ったことです。
コメントしたのはプロジェクト作者です。Quixotic AIについて「JVMにエンドツーエンドのAIスタックを持ち込む本気の試み」と紹介しています[3]。CPUで動かした場合の性能は、すでにllama.cppと競争力があるといいます。スタックの各部品は単体でも使える設計で、APIはシンプルさを重視しているとのこと。対応モデルはGemma 4、Qwen 3.5+、LFM 2.5など最新のオープンモデルです。そして全体が、追加依存のない2.6MBのfat JAR(必要なものをすべて詰め込んだ実行ファイル)に収まります[3]。
興味深いのは表現の温度差です。投稿タイトルは「llama.cppより速い」と打ち出す一方、作者コメントは「CPU上では競争力がある」と一段控えめです[1][3]。性能の言及がCPU上の話にとどまり、GPUでの数値は示されていません。とはいえ、JVMで完結させる試みは単発ではなくなりつつあります。純Javaで実装されたローカル推論エンジン「LLMPlayer」も登場しました[8]。Javaだけで推論エンジンを作る選択肢が増えたことで、潮流の兆しが見えてきます。なお、素材にはLLMPlayerの性能データは見つかりませんでした。
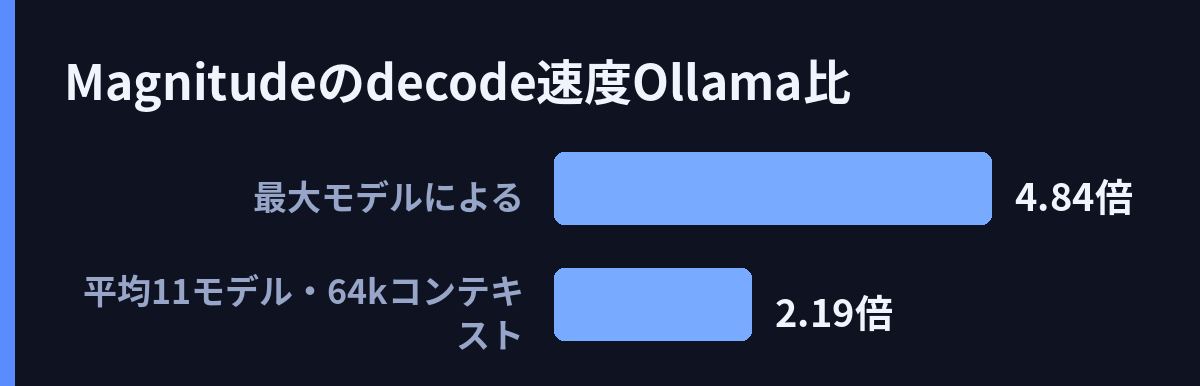
同じ時期、軽量ローカル推論の切り口も多様化しています。まず新世代エンジンの「Magnitude」です。Apache 2.0ライセンスで公開されたこのプロジェクトは、公式ベンチマーク(主要11モデル、64kコンテキストの平均)で、同じPC・同じモデルのOllama(MLX/llama.cpp)と比べ、decode(トークンを1つずつ生成する段階)が平均2.19倍、モデルによっては最大4.84倍速いという数値を掲げています[2]。
カラクリは、ダウンロード中に1分間の自動計測を行うオートチューニングです。自分のPCの特性を測って設定を自動で最適化する仕組みで、従来のエンジンが見送ってきた高速化に踏み込んだと記事は解説しています[2]。Claude CodeのようなAIエージェントをワンクリックでつなげる設計も紹介されました。ただし数値は開発者公開のベンチマークによるもので、独立した検証はこれからの段階です。
まったく別の切り口で挑むのが、2026年10月13日にHacker Newsに登場したC言語製エンジンの「Janas」です。MoE(トークンごとに必要な一部の専門ネットワークだけを計算に使うモデル構造)の性質を利用し、重みをNVMe SSDに置いたまま、そのトークンが実際に使う専門ネットワークだけを読み込みます[4]。よく使うものはメモリにキャッシュし、OSのキャッシュを経由せずエンジン側がメモリの使い方を制御する点も特徴です。この方式で、全体80B・トークンごとに約3Bだけ計算する「Qwen3-Next-80B-A3B」を動かしたと報告があります。環境は32GBメモリのノートPCで、速度は37トークン/秒です[4]。
ただし、これは取引です。モデル全体をメモリに収めるというハードな要件を、「SSDが十分速く、よく使う専門ネットワークがキャッシュに収まる」というソフトな要件に置き換えたためです[4]。当たり続ければ速いのですが、外れが続けば体感速度は落ちます。紹介元も「導入前には慎重に読む価値がある」と注意を促しています。実はこの方式には先例があり、GLM-5.2を25GBで動かす例、Gemma 4 26Bを約2GBで動かす例、35Bを2.5GBで動かす例も登場しています[4]。Janasの違いは二つです。チャットやMCPサーバー(AIエージェントに外部ツールを使わせる仕組み)、OpenAI風のHTTP APIを備えた汎用エンジンである点。そしてllama.cppとの対抗数値を公開している点です。
こうした「速い」主張を確かめる土壌も整ってきました。推論最適化を評価する学術ベンチマーク「InferenceBench」が公開され[5]、Hugging Faceも推論サーバー向けのベンチマークツールを出しています[5]。llama.cpp、Ollama、vLLM、SGLangを整理したガイド記事も登場しています[5]。ローカル推論は「どのエンジンがどの環境で輝くか」を見極める段階に入ったようです。JVMエンジンの次の関門は、2.6MBという小ささではありません。この検証の流れの中で、実力を示せるかにかかっていそうです。
引用ソース
- Hacker News Hacker News: Local inferencing in one JVM JAR, dependency free, faster than llama.cpp — https://qxotic.ai/
Local inferencing in one JVM JAR, dependency free, faster than llama.cpp
- Web記事 記事全文: 【2x Faster than Ollama】Why does it ‘auto-optimize in 1 minute’ for your … — https://note.com/makomo_memo/n/n898d967ce4cb?hl=en
【2x Faster than Ollama】Why does it ‘auto-optimize in 1 minute’ for your PC? The fascinating mechanism behind the new generation local LLM ‘Magnitude’
“I tried running a local LLM on my Mac or gaming PC, but waiting for t - HNコメント HNコメント: cal inferencing in one JVM JAR, dependency free, faster than llama.cpp — https://news.ycombinator.com/item?id=50223693
Quixotic AI is a serious attempt to bring an end-to-end AI stack to the JVM. Performance is already competitive with llama.cpp (on CPUs), the APIs are crafted to be simple and easy to use. Every component in the stack ca
- Web記事 記事全文: Janas: 80B MoE on a 32 GB Laptop, 37 tok/s (Oct 2026) | explainx.ai … — https://www.explainx.ai/blog/janas-run-moe-llms-larger-than-ram-stream-experts-ssd-october-2026
A new open-source engine called Janas claims you no longer need to fit a mixture-of-experts model in memory to run it. Janas, written in plain C by Maurizio “camauri” Cammalleri, keeps the weights on an NVMe SSD and pull
- Web記事 Web検索: The Complete Guide to Local LLM Inference Tools in July 2026: llama.cpp … — https://dev.to/sreeraj-sreenivasan/the-complete-guide-to-local-llm-inference-tools-in-july-2026-llamacpp-ollama-vllm-sglang-and-4mh1
The Complete Guide to Local LLM Inference Tools in July 2026: llama.cpp …
- Web記事 Web検索: InferenceBench: A Benchmark for Open-Ended LLM Inference Optimization … — https://arxiv.org/pdf/2607.20468v1
InferenceBench: A Benchmark for Open-Ended LLM Inference Optimization …
- Web記事 Web検索: GitHub – huggingface/inference-benchmarker: Inference server … — https://github.com/huggingface/inference-benchmarker
GitHub – huggingface/inference-benchmarker: Inference server …
- Web記事 Web検索: LLMPlayer: A Local LLM Inference Engine Implemented in Pure Java — https://www.zingnex.cn/en/forum/thread/llmplayer-java
LLMPlayer: A Local LLM Inference Engine Implemented in Pure Java
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS