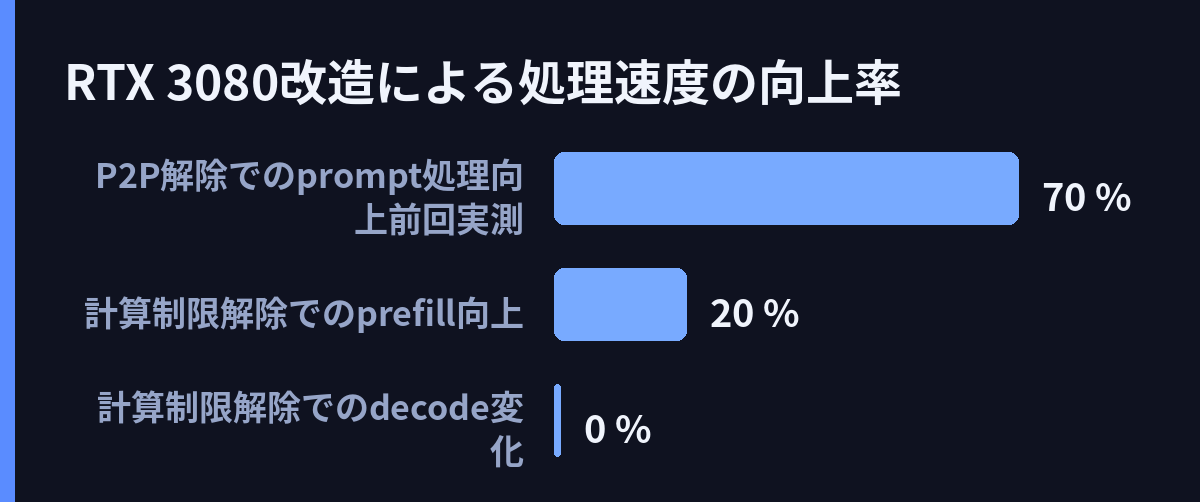
「NVIDIAの封印を解く」改造RTX 3080の話題が、止まっていません。以前この連載で取り上げた「推論処理が70%高速化」の実測[1]は、P2P(複数枚のGPUがCPUを経由せず直接データをやり取りする機能)の解除によるものでした。あわせてreBAR(CPUがGPUメモリへ大きなまとまりでアクセスできる機能)の解除も報告されています。その後もコミュニティの手で動きは続いています。今回は4枚構成の本格ベンチマークと、新たな「計算制限解除mod」の2つを追いました。
まず4枚構成から。中国のデータセンターで、基板を折り返して組み合わせるclamshell改造とされる4枚のRTX 3080を、tensor parallel(複数GPUで計算を分担する方式)で動かすベンチマークが公開されました[2]。GPUチップはストックのGA102で、帯域は760GB/s、P2Pは無効のままです。結果は、Q8(8ビット量子化=重みを圧縮してメモリを節約する仕組み)とMTP(1回の計算で複数のトークンを先読みする仕組み)の組み合わせで、decode(トークンを1つずつ生成する段階)が約95 tok/s。8枚のRTX 5060 Ti構成の2.4倍という数字が出ています[2]。計測は現実的なコーディングプロンプトで行われ、32Kコンテキストでのdecode速度が最高値とされています[2]。
なぜ3080が勝つのか。素材にはシリコンの実測比較もあります。CUDAコアは8704対4608で1.89倍、メモリ帯域は760対448GB/sで1.70倍です[2]。ただし記事自身が「1.89倍という見出しの数字を引用するな」と釘を刺しています。同一条件の比較で実際に効くのは、prefill(プロンプト全体を一括処理する段階)で+20%、decodeで+39%。prefillはコア数に、decodeはメモリ帯域がボトルネックになるという整理です[2]。MTPによる速度向上は1.8倍で、先読み候補の採択率は約80%。KVキャッシュ(会話履歴を保持するメモリ)をSSMという別構造と組み合わせるハイブリッド構成のおかげで、256KコンテキストがGPUあたり11GBに収まります[2]。電力は220Wに抑え、ピーク温度は67°C。発熱ではなく電力で頭打ちの、余裕ある動作です[2]。
もう一つの動きが、計算制限の解除です。Zaggita名義で公開されたパッチは、NVIDIAがコンシューマー向けGPUで無効化した計算用の命令を戻すもの。独立テスターがRTX 3080 20GBを2枚で検証したところ、vLLM(ローカル推論で広く使われるオープンソースのエンジン)でのprefillが約20%向上しました。一方、decodeは単一ストリームでは変化なしです[3]。検証は4ビットに量子化したQwen3-27Bをtensor parallelで動かすもので、MTPを使った推測的デコード(先読みした候補をまとめて検証する方式)も有効でした[3]。環境はThreadripper 1920x、PCIe 3.0、240W制限と、以前取り上げたP2P解除の実測(+70%のprompt処理向上[1])に近い構成です。互換性報告も上がっており、Debian 13や仮想化基盤Proxmoxでの動作が確認されています[4]。
しかし、話は単純ではありません。4枚構成のベンチマークでは、P2Pが無効なままのためdecodeはall-reduce(GPU間で計算結果をすり合わせる通信)の遅延がボトルネックになります。カード間のPCIe Gen3 x16の上限は約15.75GB/sで、ここが壁です[2]。入力から似た断片を探して再利用するprompt-lookup n-gramは、この構成では逆効果になったと報告されています[2]。計算制限解除modの効果もprefillに限られます[3]。改造で伸びるのは主にプロンプト処理側で、decodeの壁は別の場所にあるようです。また改造カードのリスクを問う記事も登場しています[7]。発熱やドライバ互換性を、自分の環境で検証してから頼るべきという注意もあります[3]。
こうしたハッカー的な改造の動きは、3080にとどまりません。TechPowerUpとWccftechの報道では、RTX 20/30/40世代に及ぶunlock modで計算性能が最大2倍、実効速度でも最大60%の向上と伝えられています[5][6]。実測検証を行った記事もすでに登場しています[8]。
今回の追跡で見えたのは、採掘用途などから流れた20GB改造カードが、ローカルAI推論の実用的な選択肢として生き続けていることです。伸びしろはprefill側に集中しており、長い文脈を扱うRAGなどの用途と相性がよさそうです[3]。一方、decodeの壁はGPU間の接続にあります。そこをどう崩すかが、次の焦点になると思われます。
引用ソース
- Reddit Reddit r/LocalLLaMA: RTX 3080 20GB got reBAR and P2P unlock! +70% prompt processing speed — https://www.reddit.com/r/LocalLLaMA/comments/1xf9kmd/rtx_3080_20gb_got_rebar_and_p2p_unlock_70_prompt/
RTX 3080 20GB got reBAR and P2P unlock! +70% prompt processing speed
- Web記事 記事全文: 4× Modded RTX 3080 — Qwen3.6-27B Inference Benchmark — https://jdkruzr.github.io/3080bench/
Tensor-parallel inference on four clamshell-modded 3080s (stock GA102, 760 GB/s, no P2P) in a China datacenter. The verdict: run Q8 with the MTP head — ~95 tok/s decode, 2.4× the 8× RTX 5060 Ti box, at full quant quality
- Web記事 記事全文: Community GPU unlock lifts Nvidia compute limits on RTX 3080 20GB — https://tools4all.ai/trends/community-gpu-unlock-lifts-nvidia-compute-limits-on-rtx-3080-20gb
TL;DR: A user-tested patch from Zaggita reportedly removes Nvidia’s compute throttle on consumer cards, delivering ~20% faster prefill in vLLM with no decode gain.
Summary: A community performance unlock attributed to Za - Web記事 Web検索: Compatibility report: works on Debian 13 / Proxmox, 2x modded RTX 3080 … — https://github.com/Zagitta/gpu-unlock/issues/15
Compatibility report: works on Debian 13 / Proxmox, 2x modded RTX 3080 …
- Web記事 Web検索: GeForce Unlocked: Modders Boost RTX 20, RTX 30, and RTX … – TechPowerUp — https://www.techpowerup.com/354110/geforce-unlocked-modders-boost-rtx-20-rtx-30-and-rtx-40-compute-performance-by-up-to-2x
GeForce Unlocked: Modders Boost RTX 20, RTX 30, and RTX … – TechPowerUp
- Web記事 Web検索: NVIDIA GeForce RTX 30 GPUs Get Up To 2X Faster AI Compute … – Wccftech — https://wccftech.com/nvidia-geforce-rtx-30-gpus-get-up-to-2x-faster-ai-compute-performance-with-new-gpu-unlock-mod-real-world-gains-of-up-to-60/
NVIDIA GeForce RTX 30 GPUs Get Up To 2X Faster AI Compute … – Wccftech
- Web記事 Web検索: Modded RTX 3080 20GB for Local AI: Worth the Risk in 2026? · Aliteq — https://aliteq.com/modded-rtx-3080-20gb-vram-worth-it-local-ai
Modded RTX 3080 20GB for Local AI: Worth the Risk in 2026? · Aliteq
- Web記事 Web検索: RTX 30 GPU Unlock Mod 2026: Up to 2X Faster Local AI, Tested — https://ailearningguides.com/rtx-30-gpu-unlock-mod-local-ai-speed/
RTX 30 GPU Unlock Mod 2026: Up to 2X Faster Local AI, Tested
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS