依存ライブラリゼロ。JARファイル1つだけでLLMの推論が完結する——そんな触れ込みのプロジェクトが、Hacker News(ハッカーニュース)で話題になっています[1]。JVMはJavaのプログラムを動かす土台で、JARはそれを1ファイルにまとめた形式です。投稿のタイトルは「Local inferencing in one JVM JAR, dependency free, faster than llama.cpp」。つまり「依存ゼロで、llama.cppより速い」という主張です[1]。議論はまだ小さく、ポイント2、コメント1件。ただし作者本人が現れており、中身は濃い内容でした[1]。
プロジェクト名はQuixotic AI。作者いわく、AIスタック一式をJVMに載せる本格的な試みです[3]。性能はCPU上でllama.cppに匹敵し、APIはシンプルで使いやすい設計といいます[3]。スタックの各部品は単体でも動くため、推論機能だけを取り出して組み込むことも可能なようです[3]。対応モデルはGemma 4、Qwen 3.5+、LFM 2.5など最新のオープンモデル[3]。そしてスタック全体が、依存ライブラリ込みの2.6MBのJAR1つに収まります[3]。以前この話題を取り上げた際には、モデルを事前に読み込むことで、最初のトークンが出るまでの待ち時間をほぼゼロにする工夫も伝えました。
背景として、2026年のローカル推論ランタイムの勢力図を押さえておきます[2]。代表格はOllama、LM Studio、llama.cpp、vLLM、Janの5つです。しかし本当の意味での推論エンジンは、llama.cppとvLLMの2つだけ。残る3つは、llama.cppに扱いやすい画面をかぶせたフロントエンドです[2]。OllamaはCLIとREST APIを備え、多くのエージェント系ツールが標的にします。LM StudioはGUI重視のデスクトップアプリで、JanはAGPL-3.0ライセンスのオープンソース版です[2]。便利さの代わりに、測れるほどの「抽象化税」を払っていると記事は指摘します[2]。
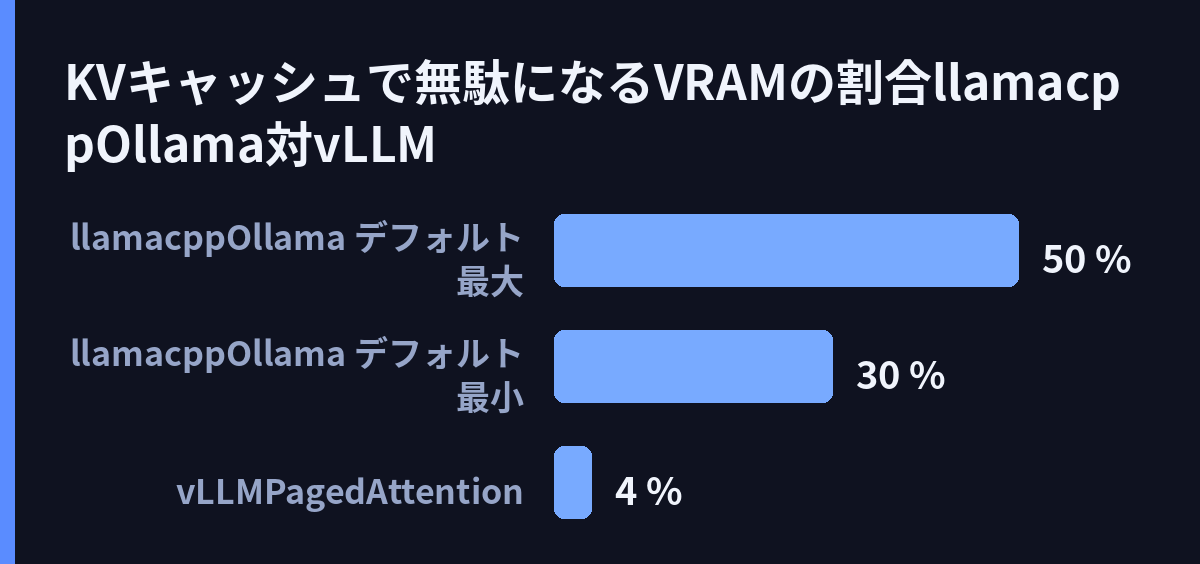
数値の差ははっきりしています。デフォルト設定のllama.cppとOllamaでは、VRAM(GPUのメモリ)の30〜50%が遊んだままになります[2]。原因はKVキャッシュ(過去のトークンの計算結果を保持して再利用するメモリ領域)の割り当ての非効率さです。一方、vLLMのPagedAttention(同じメモリをページ単位で管理する仕組み)は、損失を4%未満に抑えます[2]。速度でも差がつきます。高負荷ではvLLMがOllamaの16〜20倍で、同時に多くのユーザーをさばけるのはvLLMだけ[2]。MacではMLXというエンジンが、llama.cppのGPU経路の約3倍という数値もあります[2]。
選択肢の地図も整ってきました。16のランタイムを比較したまとめでは、14がOpenAI互換API(OpenAIと同じ形式で呼び出せるAPI)を備えています[4]。既存アプリをクラウドから自分のマシンに付け替えられる、重要な共通規格です。多くのランタイムはllama.cppの包装で、モデル形式はGGUFが共通言語になっています。GGUFは量子化(重みを圧縮してメモリを節約する仕組み)した重みを収めるファイル形式です[4]。どれが最善かは一概にいえず、画面・ハードウェア・ライセンスで選ぶことになるとまとめは結論づけます[4]。vLLMやSGLangを比べた解説[6]や、速度・品質・リソース使用量を測る記事[6]、推論サーバー比較用のベンチマークツール[5]も出ており、計測が当たり前の時代です。
しかし、標題の「llama.cppより速い」には注意が必要です。作者のコメント自体は「CPU上ではllama.cppに匹敵する」という表現で、「速い」と「匹敵する」の間には幅があります[3]。素材には、このスタックを第三者が計測した数値は見つかりませんでした。Hacker Newsの議論も2ポイントと小規模で、検証はこれからです[1]。そもそも速さは条件で入れ替わります。MacではMLXが約3倍速く、高負荷ではvLLMが16〜20倍[2]。単一の「速い」という言葉は、同じ条件での比較でしか意味を持たないのが実情です。
それでも、この試みの意味は小さくありません。2.6MBのJAR1つで推論が完結すれば、Javaで作られた業務システムは、Python環境やネイティブライブラリの設定なしでAI機能を持てるようになります。エンジン勢の実力差が数値で示される中[2]、JVM陣営の主張が通用するかどうか。注目は第三者ベンチマークの登場です。小さな1ファイルが、ローカル推論の選び方をどう変えるか、しばらく見守りたいところです。
引用ソース
- Hacker News Hacker News: Local inferencing in one JVM JAR, dependency free, faster than llama.cpp — https://qxotic.ai/
Local inferencing in one JVM JAR, dependency free, faster than llama.cpp
- Web記事 記事全文: Best local LLM runtimes in 2026: speed vs setup tradeoff — https://botmonster.com/ai/best-local-llm-runtimes-2026/
Best local LLM runtimes in 2026: speed vs setup tradeoff
The best local LLM runtime in 2026 depends on what runs under the hood. Ollama, LM Studio, and Jan are all just llama.cpp rebranded with a friendlier interface, so - HNコメント HNコメント: cal inferencing in one JVM JAR, dependency free, faster than llama.cpp — https://news.ycombinator.com/item?id=50223693
Quixotic AI is a serious attempt to bring an end-to-end AI stack to the JVM. Performance is already competitive with llama.cpp (on CPUs), the APIs are crafted to be simple and easy to use. Every component in the stack ca
- Web記事 記事全文: Local AI Runtime Comparison: Ollama vs llama.cpp vs vLLM and more — https://d-central.tech/local-ai-runtime-comparison/
Local AI Runtime Comparison: Ollama vs llama.cpp vs vLLM and more
This compares the runtimes that run a local LLM — the engines behind the model. Once a runtime can serve a model, the next question is what that model ca
- Web記事 Web検索: GitHub – Asahi-Prv/llmservebench: Benchmark and compare LLM inference … — https://github.com/Asahi-Prv/llmservebench
GitHub – Asahi-Prv/llmservebench: Benchmark and compare LLM inference …
- Web記事 Web検索: LLM Inference Engines Compared: vLLM, SGLang, Ollama & llama.cpp — https://leetllm.com/blog/llm-inference-engine-comparison-2026
LLM Inference Engines Compared: vLLM, SGLang, Ollama & llama.cpp
- Web記事 Web検索: Benchmarking Local LLMs in 2026: Speed, Quality, Resource Usage — https://dasroot.net/posts/2026/04/benchmarking-local-llms-speed-quality-resource-usage/
Benchmarking Local LLMs in 2026: Speed, Quality, Resource Usage
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS