巨大なMoEモデルを、RAMへの事前読み込みなしで動かす——。そんな推論方式が、llama.cpp周辺で具体化してきました。以前取り上げた、8GBのGPUで35Bモデルを動かした実検証の流れを受け、今回は仕組みの解説と実装が揃い始めています。必要なエキスパートをディスクからその都度読み込むストリーミングでは、読み込みと計算を重ねることで概ね2倍の速度向上が報告されています[2]。
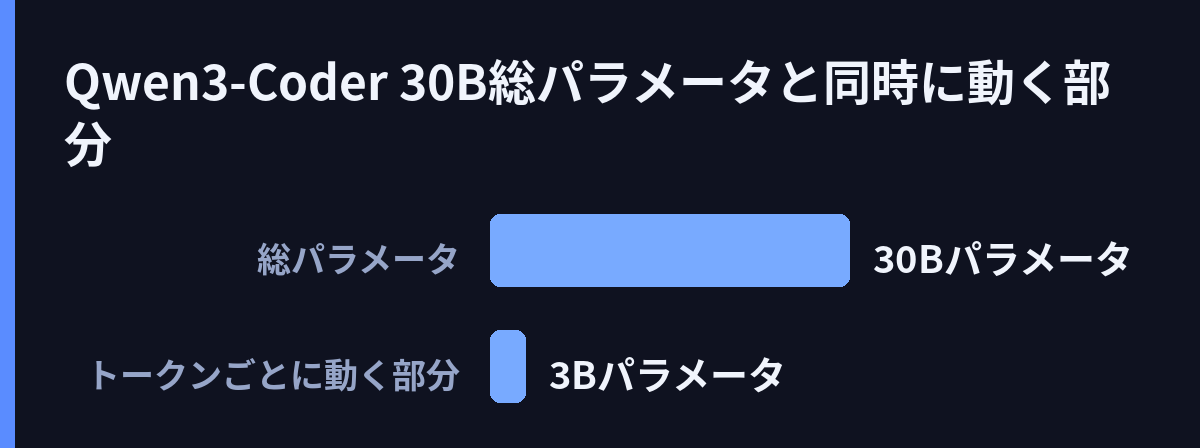
仕組みを押さえておきます。MoE(混合エキスパート)は、トークンごとに必要な「専門分岐(エキスパート)」だけを動かすモデル構造です。ローカルで動かす魅力は、トークンごとに動くパラメータが一部だけという点にあります。解説によると、Qwen3-Coderの30Bモデルは、同時に動くのはわずか3Bです[2]。使う部分が小さい一方で、動かないエキスパートもどこかに置いておく必要があります。16GBや24GBのマシンでは、この「置き場所」が最大の壁でした[2]。
現在の標準的な解決策が、エキスパート重みをシステムRAMに置く方法です。最初のN層分のエキスパートをVRAMの外に置く–n-cpu-moeという指定があり、Nを増やすほどVRAMは節約でき、その分CPUの仕事が増えます[2]。attention(前後のトークンの関係を処理する部分)や、トークンごとに動く計算はGPUに残る分担です[2]。速度と容量を層ごとに交換する「つまみ」です。代償はトークン/秒に直接現れます。モデルがメモリ不足で落ちないぎりぎりが適正値だと解説されています[2]。この方法で、30B級のMoEは16GBのGPUでも動くようになりました[2]。
次の段階は、エキスパートを事前読み込みせず、ディスクから直接流す方式です。鍵はタイミングのずれです。トークンごとに使うエキスパートを選ぶルーターの計算は、attentionの計算が終わる前に完了します。この隙間が先読みの窓になります。いま計算中の層の間に、次の層で必要なエキスパートをディスクから読み込めるのです[2]。待ち時間を計算の合間に隠せるかどうかが、速度を左右します。全部を事前に読み込む場合と比べ、ある実装の議論では概ね2倍のスループット向上が示されています[2]。llama.cpp本体への機能要望として議論されており、執筆時点で少なくとも5つの独立した実装が動いているようです[2]。
実装も姿を見せています。GitHubではllama.moeとして、llama.cppベースで動的なエキスパートオフロードを行う軽量推論フレームワークが公開されました[3]。ビルドにはCUDAが必要で、使い方はllama-serverと同じです。コマンドを置き換えるだけで済む設計になっています[3]。またHacker Newsには、スマートフォンとノートPCで巨大MoEをストリーミングする「BigMoeOnEdge」が投稿されました[1]。llama.cppの上に重ねるレイヤーとして作られています。解説面では、GPU加速と組み合わせてMoEをローカル推論する実践ガイドがHugging Faceのブログで公開され[4]、大規模MoEモデルの推論性能を最適化するガイドもGistで共有されています[5]。
しかし、話が速い分野だけに、検証も追いかけています。話題になった「24GBのGPUで96Kコンテキスト」という主張については、その裏付けを検討する記事が公開されています[5]。華やかなデモの数字が、そのまま誰の環境でも出るわけではないようです。研究側からも動きがあります。HOBBITという研究が発表されました[5]。高い精度と低い精度の重みを使い分ける混合精度で、エキスパートのオフロードを高速化する研究です。実装とは違う、研究側からのアプローチです。一方、注目のBigMoeOnEdgeは、現時点でポイント1・コメント0と、反応はこれからです[1]。
エキスパートの「置き場所」は、VRAMからRAMへ、さらにディスクへと段階的に外へ広がってきました。先読みの窓をどれだけ活かせるかが、速度の分かれ目になります。実装と検証が揃ってきた今、次に見たいのは各環境での実測です。スマホやノートという身近な機器で巨大モデルがどこまで動くか。デモの数字が日常の数字に変わるかどうか、注目が集まりそうです。
引用ソース
- Hacker News Hacker News: Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop — https://github.com/Helldez/BigMoeOnEdge
Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop
- Web記事 記事全文: llama.cpp’s MoE Expert Offload: –n-cpu-moe and Streaming, Explained — https://www.shawnmayzes.com/ai-engineering/llama-cpp-moe-expert-offload-explained/
llama.cpp’s MoE Expert Offload: –n-cpu-moe and Streaming, Explained
– 8 min read
If you’re running a mixture-of-experts model locally – Qwen3-Coder, DeepSeek-class models – the whole appeal is that only a fraction of th - Web記事 記事全文: GitHub – jklincn/llama.moe: Optimized inference of MoE models based on … — https://github.com/jklincn/llama.moe
A lightweight inference framework for Mixture-of-Experts (MoE) models, built on top of llama.cpp with dynamic expert offloading.
sudo apt update
sudo apt install build-essential cmake ccache libcurl4-openssl-dev ninja-bu - Web記事 Web検索: Performant local mixture-of-experts CPU inference with GPU acceleration … — https://huggingface.co/blog/Doctor-Shotgun/llamacpp-moe-offload-guide
Performant local mixture-of-experts CPU inference with GPU acceleration …
- Web記事 Web検索: HOBBIT: A Mixed Precision Expert Offloading System for Fast MoE Inference — https://arxiv.org/html/2411.01433v2
HOBBIT: A Mixed Precision Expert Offloading System for Fast MoE Inference
- Web記事 Web検索: Guide to optimizing inference performance of large MoE models across … — https://gist.github.com/DocShotgun/a02a4c0c0a57e43ff4f038b46ca66ae0
Guide to optimizing inference performance of large MoE models across …
- Web記事 Web検索: llama.cpp ‘Streaming Expert Loading’: The Viral 96K-on-24GB Claim vs … — https://runaihome.com/blog/llama-cpp-streaming-expert-loading-96k-context-24gb-2026/
llama.cpp ‘Streaming Expert Loading’: The Viral 96K-on-24GB Claim vs …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS