📌 エグゼクティブサマリー
180B・活性化6BのQwen3.8-Flash-Nextが、スコア比較でMetaの816Bモデルを上回る40点を記録し話題に。ローカル実測ではDeepSeek-V4.1-Flashの量子化に対し25問全問正解と好調です。一方で総合指標ではDeepSeekに僅差で及ばず、必要メモリも111GB超と軽量ではありません。
「総パラメータ180B、一度に動くのは6Bだけ」。そんな構造を持つ「Qwen3.8-Flash-Next」が、ローカルLLMコミュニティで話題です。MoE(タスクごとにモデルの一部だけを動かして計算を減らす仕組み)を採用しており、動く部分は「活性化パラメータ」と呼ばれます。前回記事では27Bモデルの旧GPUでの実測を追いました。その後、話題は一回り大きなFlash-Nextへと広がり、より巨大なモデルとの比較検証が相次いでいます。
目を引いたのが、Artificial Analysisのスコアをオープンウェイトモデル11種で整理したRedditの投稿です。Metaの816B(活性化42B)「Muse Spark Open」が39点に対し、Flash-Next(180B・活性化6B)は40点。総パラメータは4分の1以下ですが、スコアでは上回りました[4]。量子化(重みを圧縮してメモリを節約する仕組み)済みGGUFの容量も、Muse Spark Openが約506GB、Flash-Nextは約111GBです[4]。MetaはMuse Spark Openのローカル構成として512GBのMac Studioを2台推奨しています[4]。Flash-Nextとの差は歴然です。なお前回取り上げたQwen3.8 27Bも34点を記録。501BのBeam(30点)を上回り、4bit量子化に必要なメモリは16〜19GBとされています[4]。
実際に動かした比較も現れています。別のReddit投稿者は、BenchKitを改造したツールでベンチマークを実施。Flash-Nextを約129GBの量子化で推論強度「xhigh reasoning」に設定し、DeepSeek-V4.1-Flash-1017の2.6bit量子化(187GB+203GBのEngram)と25問で対決させました[1]。結果はFlash-Nextが25問全問正解、DeepSeekは23問です。サンプルは小さいものの、投稿者は「どちらを使うべきかの答えになった」とFlash-Nextの使用継続を決めています[1]。印象的なのはPython関数を書かせる問題です。DeepSeekは127.9秒考え続けた末に停止しました。活動サイクルが10秒間80%以上で張り付く「doom loop」検出による強制終了です。Flash-Nextは18.8秒で正解を返しています[1]。ただしTPS(1秒あたりの生成トークン数)などの実測速度は、素材には見つかりませんでした。
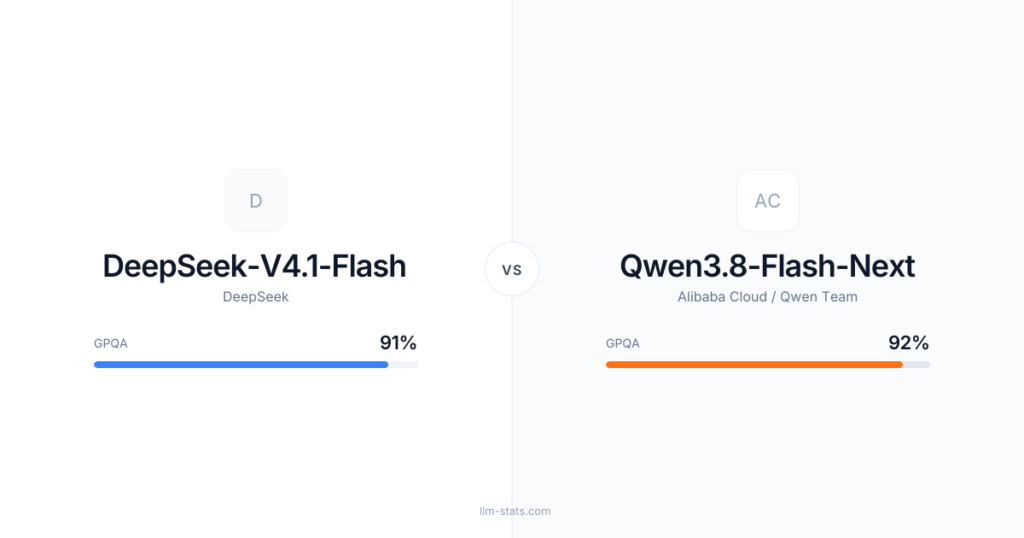
一方、ベンチマーク集計サイトLLM Statsの総合スコアでは、評価が分かれます。DeepSeek-V4.1-Flashとの比較では、DeepSeekが50.0、Flash-Nextが48.1と僅差です[2]。共通する5ベンチマークでは、DeepSeekが3つ(DeepSWE 1.1、Humanity’s Last Exam、NL2Repo)で上。Flash-Nextは2つ(Agents’ Last Exam、GPQA)で上です[2]。更新版の1017との比較でも、総合は51.2対48.1でDeepSeekが先行し、エージェント系の能力指数でもリードしています[5]。もっとも、パラメータ数はDeepSeekが638.2B多く、約510%の差があります[2]。コンテキスト長もDeepSeek側のみ公開されており、入力104万トークン超という大容量です[2]。VRAMやGPU構成に絞った比較ページでも、DeepSeek V4.1 Flash(552B)やV4 Flash(284B)との対比が用意されています[7][7]。
ここで押さえたいのが、「6Bモデル」という見方の罠です。活性化が6Bでも、実体は180Bクラスのモデルです。noteの解説記事は「Qwen3.8-Flash-Nextは6Bモデルではない」と題し、180Bクラスの実態を解説しています[6]。Kensink Labsのモデルページも「180B Sparse」として、ベンチマークやライセンスをまとめています。動かすには111〜129GBの量子化データが必要で、決して軽量ではありません[1][4]。総合スコアでDeepSeekに僅かに及ばない点も、万能ではないことを示しています。
こうした流れの背景には、Xの日本のトレンドで「パーソナルAIエージェント」という言葉が上がっていることもあるようです[3]。手元のハードで高性能モデルを動かす動きは、個人でエージェントを持つ流れと重なります。総合指標では僅差で追う立場でも、必要なメモリと実測の挙動を見れば、Flash-Nextは十分に選択肢になり得ます。「大きいのに軽く動く」設計が、ローカル推論の一つの形になっていくかもしれません。
RECENT COMMENTS