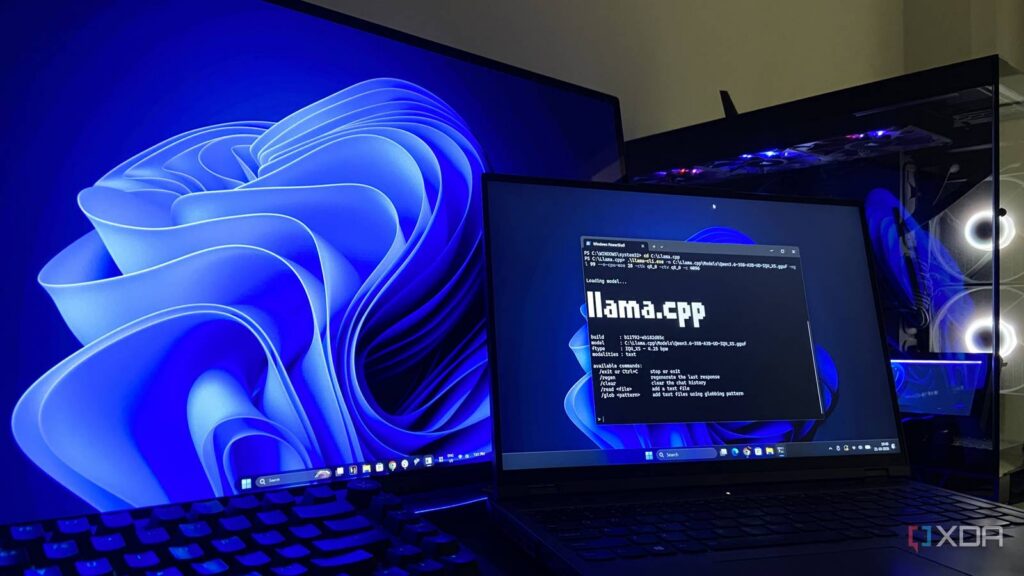
VRAMが8GBのノートPCで35Bモデルが動く——先日話題になったllama.cppのMoEオフロード技に、今度は「スマホでも」を狙う動きが現れました。Hacker Newsには「Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop」という投稿が上がっています[1]。投稿者のBigMoeOnEdgeは、llama.cppの上に重ねるレイヤーです。スマホとノートPCで巨大なMoEモデルをストリーミングで動かすことを目指しています[1]。
まず背景をさっと整理します。MoE(Mixture-of-Experts)は、モデル内の「専門家」にあたる層のうち、その都度必要な一部だけを動かす仕組みです。XDAの記事では、35Bモデルのうち推論で実際に動くのは約3Bで、残りは待機していると説明されています[2]。前回取り上げた通り、XDAのライターは8GBのRTX 3070 Mobileを搭載したノートPCで、約17.7GBのモデルファイルを動かしました[2]。量子化は4ビット台、コンテキストは32Kという設定です。著者自身、当初はこのノートPCを「最初から対象外」と決めつけていました[2]。鍵は、GPUに載せた層のうち専門家にあたる部分だけをメインメモリへ戻す指定(–n-cpu-moe)です[2]。
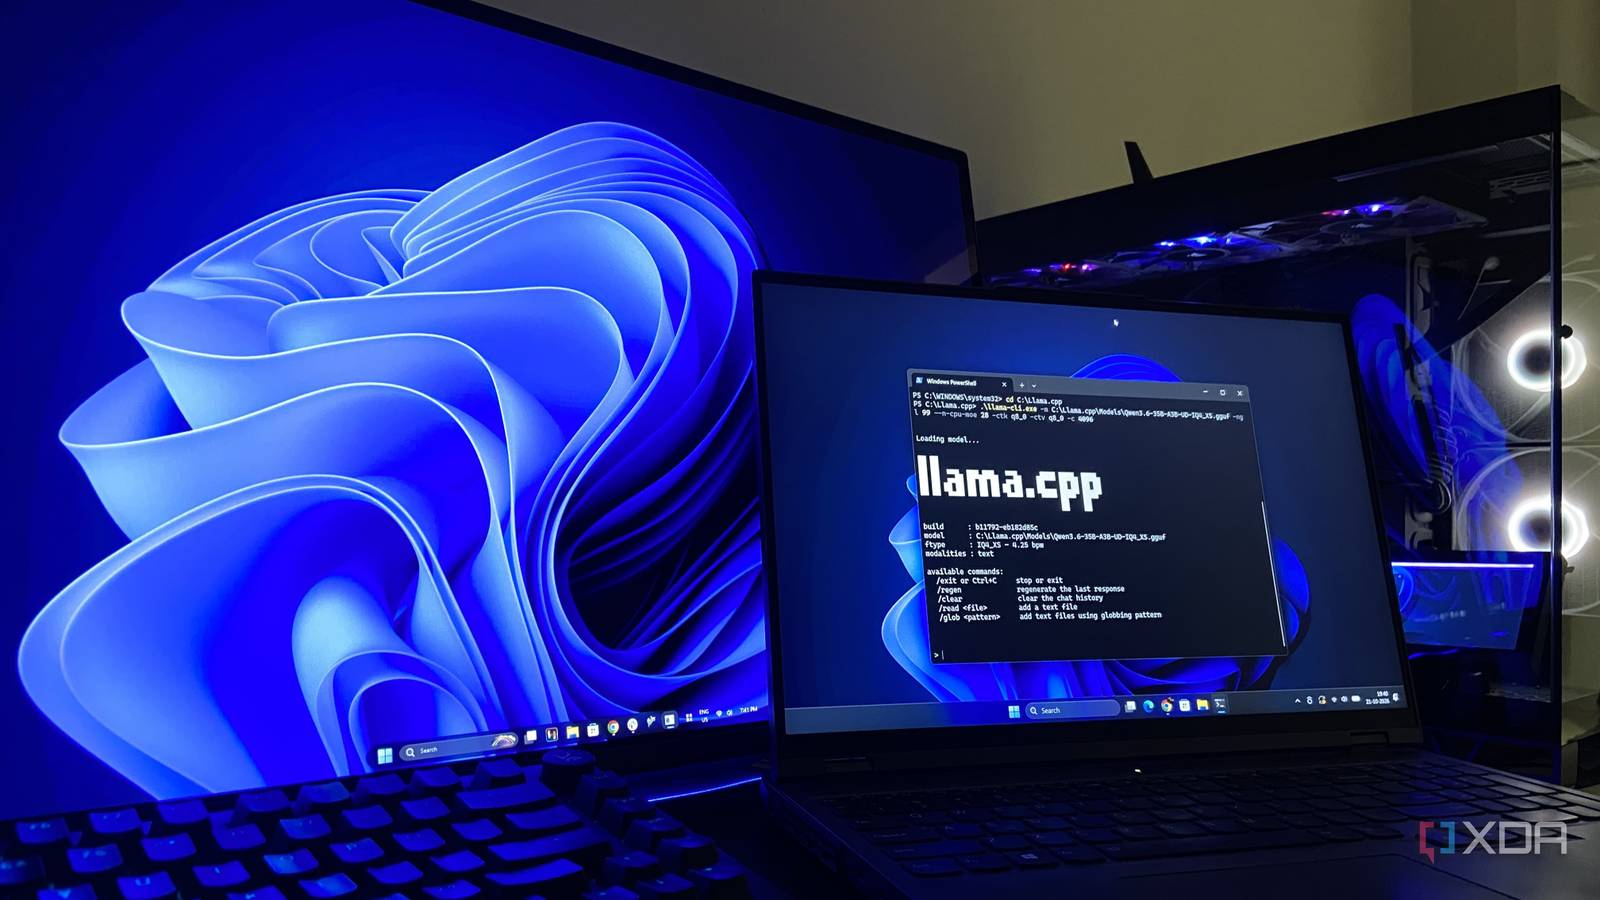
注目したいのは、デスクトップ側の数字です。著者のRTX 4070 Ti Super(VRAM 16GB)でも、このモデルのファイルは17.7GBあってVRAMを超えます。それでもテストした中で最速だったと書かれています[2]。著者はこれを「MoEが計算を変えた」結果と説明しています[2]。ファイルサイズとVRAMの単純な勝負ではなくなった、というわけです。
今回の新しい動きは、こうした設定技を「道具」の形にまとめようとする点にあります。GitHubでは「llama-stream-moe」というリポジトリも公開されています[3]。llama.cpp系のプロジェクトで、名前からMoEの専門家層を必要に応じて順次読み込むストリーミング処理を狙ったものと思われます[3]。リポジトリの説明では、Appleのチップ向け最適化やx86向けの拡張命令対応などが並びます[3]。幅広いハードウェアで動く土台なので、スマホに載るARM系チップとも相性が良さそうです。BigMoeOnEdgeも同じくllama.cppの上に重ねる構成で[1]、フラグ1つの小技から専用レイヤーへと、段階が進んできました。
周辺を見ても、この技術への関心の広がりがうかがえます。少ないVRAMで大きなローカルモデルを動かすガイド[4]や、専門家層のオフロードとストリーミングを解説する記事[5]が現れています。大規模MoEモデルの推論性能を最適化するガイド[6]や、llama.cppの推論速度を高める方法をまとめた記事[7]も相次ぎました。一つの実験報告から複数の解説へ広がるのは、試す人の輪が広がっている証拠でもあります。元になったXDAの記事も検索結果に繰り返し現れており、読まれ続けているようです。
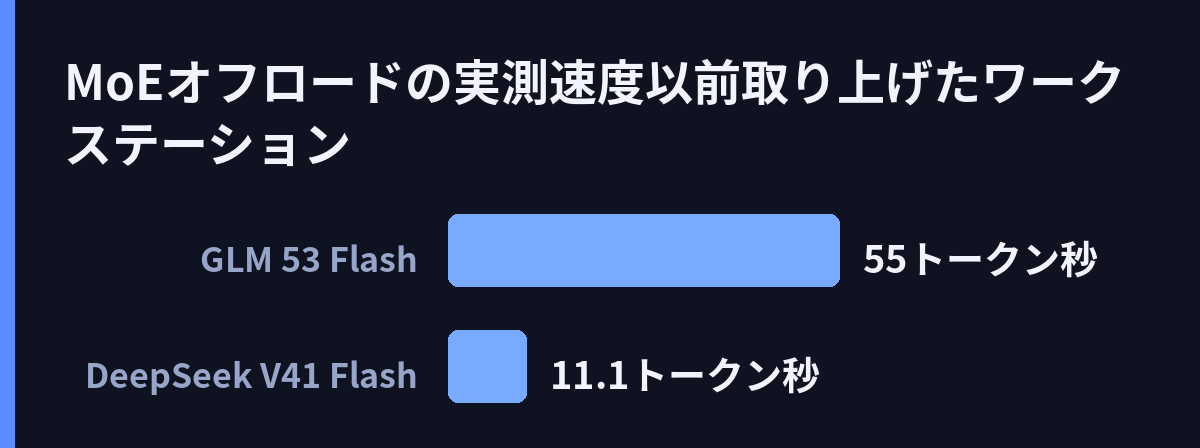
ただし、手放しで喜べる段階ではありません。Hacker Newsの投稿は現時点で1ポイント、コメント0件です[1]。コミュニティの検証がまだ始まっておらず、実力はまだわかりません。素材にもスマホ上での実測値は見つかりませんでした。参考までに、以前取り上げたワークステーション(RTX 3060を2枚、RAM 256GB)の実測があります。DeepSeek V4.1 Flashが約11.1トークン/秒、GLM 5.3 Flashが約55〜60トークン/秒でした。prefill(プロンプト全体を一括処理する段階)は約1,100〜1,500トークン/秒です。専門家層をメインメモリから読み込む工程が増えるぶん、速度は落ちやすくなるはずです。スマホはメモリの容量も帯域もこれより小さく、同じ速度が出るかは別問題のようです。
ローカルAIの最大の壁は、載せられるメモリの量でした。MoEオフロードはその壁をメインメモリ側へ押し広げ、今回の動きはさらにスマホへ届けようとしています。VRAMの上限に縛られずにモデルを選べる時代が、少しずつ近づいています。専用レイヤーが実際の速度や動作報告を示せるかどうかが、次の注目点になりそうです。
引用ソース
- Hacker News Hacker News: Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop — https://github.com/Helldez/BigMoeOnEdge
Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop
- Web記事 記事全文: I changed one llama.cpp flag, and my 8GB laptop GPU now runs a 35B … — https://www.xda-developers.com/i-stopped-thinking-my-8gb-gpu-was-too-small-after-learning-to-offload-moe-llm-layers-to-ram/
A lot of what you can do with your PC seems to be limited by the VRAM its GPU has. It decides what resolution your games run at, how large a video project you can edit without the timeline stuttering intermittently, and
- Web記事 記事全文: GitHub – 544103252/llama-stream-moe — https://github.com/544103252/llama-stream-moe
LLM inference in C/C++
– Hugging Face cache migration: models downloaded with -hf are now stored in the standard Hugging Face cache directory, enabling sharing with other HF tools.
– guide : using the new WebUI of llama. - Web記事 Web検索: Run Bigger Local AI Models on Less VRAM: llama.cpp MoE Offloading Guide … — https://aliteq.com/llama-cpp-moe-offloading-run-bigger-models-less-vram
Run Bigger Local AI Models on Less VRAM: llama.cpp MoE Offloading Guide …
- Web記事 Web検索: llama.cpp's MoE Expert Offload: –n-cpu-moe and Streaming, Explained — https://www.shawnmayzes.com/ai-engineering/llama-cpp-moe-expert-offload-explained/
llama.cpp's MoE Expert Offload: –n-cpu-moe and Streaming, Explained
- Web記事 Web検索: Guide to optimizing inference performance of large MoE models across … — https://gist.github.com/DocShotgun/a02a4c0c0a57e43ff4f038b46ca66ae0
Guide to optimizing inference performance of large MoE models across …
- Web記事 Web検索: How to Optimize llama.cpp for Maximum Inference Speed in 2026 — https://docs.bswen.com/blog/2026-03-15-llamacpp-optimization-speed/
How to Optimize llama.cpp for Maximum Inference Speed in 2026
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS