総パラメータ125Bの巨大モデルを、8GBのGPUで毎秒70トークン動かす――そんな報告がRedditで話題になっています[1]。対象はQwen3.8-Flash-Nextです。2026年8月26日に公開されたオープンウェイトのMoE(トークンごとに一部のパラメータだけを動かす仕組み)モデルで、次期Qwen4の設計を先取りした先行プレビューです[3]。先日の記事では、公開時の確認情報と慎重な見方を整理しました。今回はその後共有された、ローカル実行の実像に迫ります。
このモデルの構成が、ローカル実行の鍵を握ります。総数125Bのうち、トークンごとに動くのは約6Bだけです[2]。さらにn-gram埋め込みとして51Bが追加されています[3]。これはよく使う語のパターンを巨大な辞書のようにRAMに置いておく仕組みです。計算量を増やさずに知識を補える、と説明されています[2]。長い文脈の処理には、注目すべき一部だけを見て計算を減らすスパースアテンション(QSA)を組み合わせています[2][3]。Gated DeltaNetと呼ぶ層は、会話の記憶を小さな状態に圧縮して保持します。長い会話でもメモリの負荷が増えにくい、とされています[2]。ネイティブのコンテキスト長は262,144トークンです[3]。コンテキストを後から伸ばすYaRNという手法を使えば、100万トークンまで広げられる可能性もあります[3]。
Redditの投稿者が使ったのは、ISTA DASLab製の3.5 BPW量子化のCoder版です[1]。量子化は重みを圧縮してメモリを節約する仕組みで、BPWは重み1つあたりのビット数を示します。1bit量子化と誤解されがちですが、そうではありません[1]。構成の工夫が秀逸です。MoEのエキスパート(役割分担される部分ネットワーク)のうち小さいものを8GBのVRAMに置き、大半は24GBのRAMへ、n-gramは高速なSSDへ、という分担です[1]。結果は262Kコンテキストで毎秒70トークンでした[1]。合計32GB程度のメモリがあれば、コンテキストを減らして動かせるとも述べています[1]。起動時のパラメータは自分の機材に合わせて調整し、ブラウザのハードウェアアクセラレーションを切ってVRAMを空ける細かい工夫も添えられています[1]。
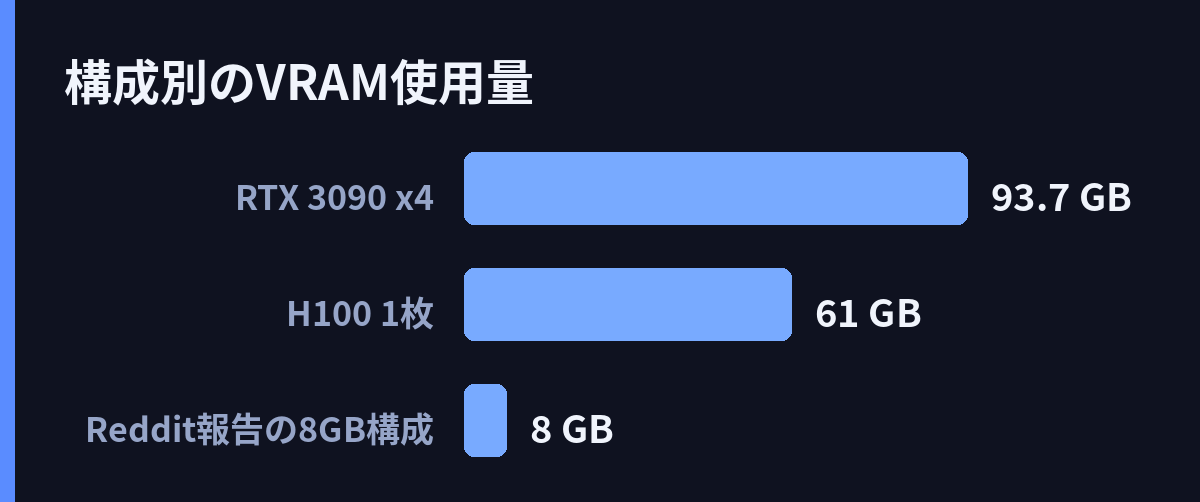
より大きな環境での報告もあります[2]。H100(80GB)1枚では、Unsloth製GGUF(llama.cpp用の量子化モデル形式)が61GB強のVRAMで動きました[2]。RTX 3090を4枚束ねた96GBでは、UD-IQ4_XSという量子化で93.7GBに達し、ほぼ上限いっぱいでした。埋め込みをシステムRAMへ追い出す工夫が必要です[2]。DataCampの検証では、RTX PRO 6000(96GB)にUD-Q4_K_XLを載せてllama.cppでサーバ化しました[3]。そこにコーディングエージェント用ツールのOpenCodeをつなぎ、完全ローカルの構成を作っています[3]。筆者はコーディング性能について「予想以上だった」と評価しています[3]。
ただし、つまずきも目立ちます。8GB VRAMではCUDAがうまく動かず、Vulkanバックエンドへの切り替えが助言されました[1]。llama.cppも、UnslothのGGUF対応と結びついた、本体にまだ取り込まれていない特定ビルドでないと動かないといいます[2]。性能面にも明暗があります。言語・コーディング系の多くのテストでは、Qwen 3.7/3.8-27BやDeepSeek V4 Flashを上回りました[2]。Claude Opus 4.6を上回る項目もある一方で、HLE(多分野にまたがる推論)やリポジトリ規模のコード処理では劣後します[2]。
周辺の動きも活発です。アーキテクチャ設計を検証したarXiv論文が公開されています[4]。vLLMでのサーバ運用を解説する記事も、FP8(8ビット浮動小数点という精度)や262Kコンテキストの観点から現れました[5]。GitHubでは262kフルコンテキストを扱うlean-qwenflashというリポジトリが登場し[6]、Unsloth製GGUFでの実行ガイド[7]や設計思想を解説するハンズオン記事[8]、評価と推論性能をまとめたページも揃いつつあります。
総125B・活性6Bという非対称な設計は、RAMやSSDへの分担と相性がよく、消費者向け機材でも動かせる見通しを示しました[1][2]。一方で、専用ビルドが必要な準備のハードルや、推論系タスクでの弱点も見えてきました。Qwen4に向けた設計を、コミュニティが実機で先取りして検証する段階に入ったようです。
引用ソース
- Reddit Reddit r/LocalLLaMA: 8 GB GPU, 262K context 3.5 BPW Qwen-Flash-Next Coder 70 T/s using llama.cpp — https://www.reddit.com/r/LocalLLaMA/comments/1xebdzl/8_gb_gpu_262k_context_35_bpw_qwenflashnext_coder/
8 GB GPU, 262K context 3.5 BPW Qwen-Flash-Next Coder 70 T/s using llama.cpp
- Web記事 記事全文: How to Run Qwen3.8-Flash-Next Locally with llama.cpp — https://www.mindstudio.ai/blog/run-qwen3-8-flash-next-locally
What is Qwen3.8-Flash-Next and why does it matter for local AI?
Qwen3.8-Flash-Next is an open-weight preview of the architecture that will become Qwen 4. It’s a 125 billion parameter model, but thanks to a mixture-of-exp - Web記事 記事全文: Run a Qwen3.8-Flash-Next Coding Agent Locally With OpenCode — https://www.datacamp.com/tutorial/run-qwen3-8-flash-next-locally
How to Run Qwen3.8-Flash-Next Locally as a Coding Agent with OpenCode
Learn how to run Qwen3.8-Flash-Next GGUF locally with llama.cpp on an RTX PRO 6000, then connect it to OpenCode for a fully local agentic coding setup - Web記事 Web検索: On the Design of Qwen3.8-Next Architecture: Evaluation, Efficiency, and … — https://arxiv.org/pdf/2608.30320v1
On the Design of Qwen3.8-Next Architecture: Evaluation, Efficiency, and …
- Web記事 Web検索: How to Serve Qwen3.8-Flash-Next with vLLM: Hardware, FP8 and 262K Context — https://7minai.com/how-to-serve-qwen3-8-flash-next/
How to Serve Qwen3.8-Flash-Next with vLLM: Hardware, FP8 and 262K Context
- Web記事 Web検索: GitHub – MaxDevv/lean-qwenflash: Qwen3.8-Flash-Next at full 262k … — https://github.com/MaxDevv/lean-qwenflash
GitHub – MaxDevv/lean-qwenflash: Qwen3.8-Flash-Next at full 262k …
- Web記事 Web検索: Qwen3.8-Flash-Next GGUF Guide 2026: Run It Locally with unsloth … — https://cldnavi.com/en/blog/qwen38-flash-next-gguf-guide-2026/
Qwen3.8-Flash-Next GGUF Guide 2026: Run It Locally with unsloth …
- Web記事 Web検索: Hands-On: Qwen3.8-Flash-Next and a Glimpse into Qwen4’s Design … — https://dev.to/oooocean66/hands-on-qwen38-flash-next-and-a-glimpse-into-qwen4s-design-philosophy-llamacpp-support-2p2c
Hands-On: Qwen3.8-Flash-Next and a Glimpse into Qwen4’s Design …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS