「JAR(Javaのプログラム一式を1ファイルにまとめた形式)1つで動き、依存関係なし、llama.cppより速い」。JVM(Java仮想マシン)製のローカル推論エンジンを紹介するこの投稿が、Hacker Newsにあります[1]。前回取り上げたのと同じ投稿で、スコアは1ポイント、コメントは0件です[1]。議論は盛り上がっておらず、主張の真偽を確かめた人はまだ現れていません。そこで今回は、主張の中身ではなく、2026年の推論エンジンをめぐる状況からこの話題を読み解きます。
まず、土俵の大きさからです。2026年のローカルAI向け推論エンジンを比較したガイドでは、Ollama、llama.cpp、vLLM、MLX、TensorRT-LLM、ExLlamaV2、Mullamaの7つが主要な選択肢として挙げられています[2]。速度・手軽さ・機能の観点でエンジンを評価する記事も出ています[6]。Ollama対llama.cpp対vLLMという構図の比較は、各所で行われています[4]。JAR1つを売りにする新参者は、この7つの勢力図に割って入ることになります。
この中で、Ollamaは1コマンドでインストールからモデル実行まで済む、初心者の入り口として人気です[2]。単独の開発者が5分以内にモデルを動かすなら、まずOllamaが有利です[3]。ただし実体はllama.cppを包むラッパー(包んで使いやすくしたソフト)で、複数リクエストを途切れなく捌く継続的バッチ処理は持っていません[2]。llama.cppの上にはLM StudioやGPT4Allなど多くのツールが乗る基盤です[2]。vLLMはGPUでの本格的なサービス提供向けの本命です[3]。

そして、1人で使う場合の差は意外に小さいのです。RTX 4090でLlama 3.1 8B(4bit量子化)を動かすと、3エンジンの速度はおよそ62〜71トークン/秒に収まります[3]。量子化とは、重みを圧縮してメモリを節約する仕組みのことです。しかもこの差のほとんどは、エンジンの性能ではなく量子化の形式によるものだといいます[3]。単独で使う限り、エンジン選びの優劣は小さいのです。
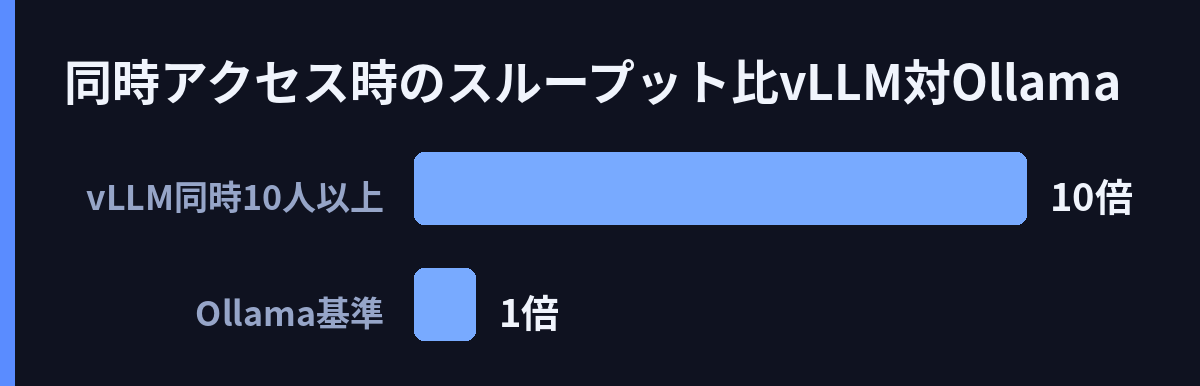
勝負が分かれるのは、同時アクセスです。vLLMの強みは、GPUのメモリを効率よく割り当てるPagedAttentionです[3]。そこに継続的バッチ処理が加わると、GPU使用率を85〜92%に保てます[3]。同時に10以上のセッションが来る場面では、vLLMはOllamaの10倍以上のスループットを出せるという数値もあります[3]。継続的バッチ処理を備えるのはvLLMやTensorRT-LLMで、備えないエンジンとは同時処理で桁違いの差がつきます[2]。
一方、JVM陣営の周辺にも動きがあります。mukel/llama3.javaは、Llama 3の推論をJavaファイル1つに収めたプロジェクトです[6]。依存関係の少なさを武器にした試みは、単発ではないようです。また、Hugging Faceは推論サーバーを測定するベンチマークツール「inference-benchmarker」を公開しています[5]。検証の道具は、すでに手に入ります。
しかし、話題の主張には裏付けがありません[1]。記憶に新しい失敗例もあります。以前取り上げた純Pythonでの自作推論エンジンの挑戦では、decode(トークンを1つずつ生成する段階)の速度が「期待では200トークン/秒なのに20トークン/秒しか出ない」という報告がありました。自作エンジンでは、理想と実測の差が大きく開きがちです。
さらに、単独速度では3エンジンの差が小さく[3]、「llama.cppより速い」だけでは決め手になりにくい側面があります。主流3エンジンはOpenAI互換APIで動き、乗り換えは接続先URLの変更だけで済みます[3]。差がつくのは同時処理です。JVM製エンジンが継続的バッチ処理に対応しているかが、本当の勝負どころになると思われます。土俵も道具も整った今[2][5]、必要なのは同時アクセス時の実測です。検証の結果を待ちたいところです。
引用ソース
- Hacker News Hacker News: Local inferencing in one JVM JAR, dependency free, faster than llama.cpp — https://qxotic.ai/
Local inferencing in one JVM JAR, dependency free, faster than llama.cpp
- Web記事 記事全文: Local LLM Inference Engines Compared: The Definitive 2026 Guide — https://www.local-llm.net/compare/inference-engines-2026/
The local LLM inference engine landscape in 2026 offers more choices than ever, and selecting the right one can dramatically affect your performance, developer experience, and hardware utilization. This guide compares th
- Web記事 記事全文: vLLM vs Ollama vs llama.cpp: Local Inference in 2026 — https://whysogeek.com/vllm-ollama-llamacpp-which-inference-engine-2026/
Running open models yourself in 2026 means choosing an inference engine, and the three serious options, Ollama, vLLM, and llama.cpp, are not really competitors. They are tools built for different jobs. Pick wrong and you
- Web記事 Web検索: Local AI Runtime Comparison: Ollama vs llama.cpp vs vLLM and more — https://d-central.tech/local-ai-runtime-comparison/
Local AI Runtime Comparison: Ollama vs llama.cpp vs vLLM and more
- Web記事 Web検索: GitHub – huggingface/inference-benchmarker: Inference server … — https://github.com/huggingface/inference-benchmarker
GitHub – huggingface/inference-benchmarker: Inference server …
- Web記事 Web検索: Best Local LLM Inference Engines 2026: Speed, Ease, Features — https://www.local-llm.net/best/inference-engine/
Best Local LLM Inference Engines 2026: Speed, Ease, Features
- Web記事 Web検索: mukel/llama3.java: Llama 3 inference in a single Java file — https://hysenlabs.com/projects/mukel-llama3-java
mukel/llama3.java: Llama 3 inference in a single Java file
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS